登录
推荐 文章 Go 技术 课程 下载 专题 AI
首页 >  AI模型评测  >  MMBench
MMBench详解:多模态大模型基准测试、功能特点与使用指南

MMBench

AI模型评测
348次浏览
2026-09-26

工具简介

MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。

详细介绍

MMBench简介

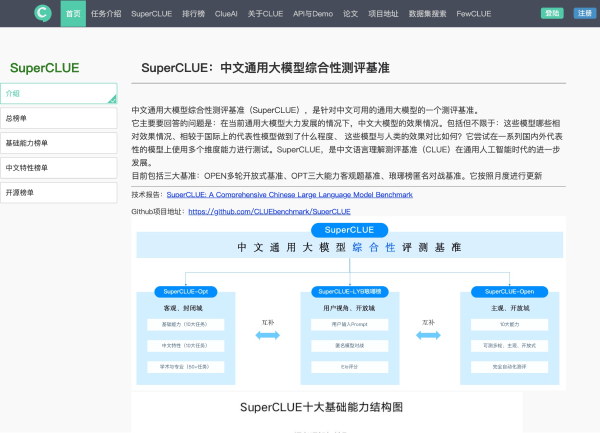
MMBench是一个综合性的多模态基准测试平台,由上海人工智能实验室携手南洋理工大学、香港中文大学、新加坡国立大学及浙江大学的研究团队共同发布。该基准旨在通过从感知到认知的逐级细分,对模型的20项细粒度能力进行全面评估。其数据集包含约3000道单项选择题,源自互联网及权威基准库。与传统基于规则匹配选项的评测方式不同,MMBench采用循环打乱选项的策略来验证输出结果的一致性,并利用ChatGPT精准匹配模型回复与选项,从而确保评估的准确性。涵盖视觉问答、图像描述生成等多种任务类型,MMBench基于多维度指标为模型提供全方位的性能画像。其公开的排行榜直观展示了各模型的表现,有助于研究者和开发者把握多模态技术的发展现状,进而推动领域内的技术创新。

MMBench

MMBench核心功能

  • 细粒度能力拆解:将多模态能力划分为感知、推理等多个维度,针对每个维度定制相关问题,实现对模型细粒度能力的深度评估。
  • 海量多模态数据:提供约3000个多项选择题,覆盖20种能力维度,支持在多样化场景下对模型性能进行充分测试。
  • 创新评估机制:引入“循环评估”策略,通过多次循环推理检验模型的稳定性,有效降低噪声干扰,确保评估结果更加可靠。
  • 双语环境支持:提供英文和中文版本的数据集,能够评估模型在不同语言环境下的理解与处理能力。
  • 数据可视化展示:支持对数据样本进行可视化处理,帮助用户更直观地理解数据结构及具体内容。
  • 官方评估套件:提供VLMEvalKit工具,支持对多模态模型进行标准化评估,并可提交测试结果以获取准确率数据。
  • 基准排名系统:通过排行榜展示不同模型在MMBench数据集上的性能表现,为研究人员提供有价值的参考依据。
MMBench

MMBench使用教程

  • 环境依赖安装:首先需安装必要的工具和库。MMBench官方推荐使用其评估工具VLMEvalKit。可通过以下命令完成安装:
pip install vlmevalkit
  • 获取数据集:访问MMBench官方GitHub仓库:https://github.com/open-compass/mmbench/下载数据集。根据实际需求选择VLMEvalKit格式或Legacy格式。例如,下载MMBench-Dev数据集:
wget <Download Link (VLMEvalKit)> -O MMBench_DEV_EN.zip
unzip MMBench_DEV_EN.zip
  • 数据加载与预览:利用VLMEvalKit提供的脚本加载并查看数据样本。示例代码如下:
from vlmeval.dataset import ImageMCQDataset
from vlmeval.smp import mmqa_display

# 加载 MMBench 开发集
dataset = ImageMCQDataset('MMBench_DEV_EN')# 查看第 0 个样本
dataset.display(0)# 构建多模态提示
item = dataset.build_prompt(0)print(item)
  • 执行模型推理:使用您的多模态模型对数据集进行推理。以下是使用llava_v1.5_7b模型进行推理的示例命令:
python run.py --model llava_v1.5_7b --data MMBench_DEV_EN --mode infer
    • 运行结束后,推理结果将保存为Excel文件,例如:llava_v1.5_7b/MMBench_DEV_EN.xlsx。
  • 性能评估:使用VLMEvalKit对模型的预测结果进行评估。该工具将依据MMBench标准计算准确率等各项指标。
  • 提交评测结果:
    • 若需在MMBench领先榜上提交结果,请遵循以下步骤:
      • 使用测试集数据进行推理,生成预测结果文件(如llava_v1.5_7b/MMBench_TEST_EN.xlsx)。
      • 登录MMBench领先榜页面上传预测结果文件。
      • 系统将自动计算并展示模型在各能力维度上的具体表现。

MMBench应用场景

  • 模型效能评估:MMBench提供全面的多模态基准测试平台,能够对视觉语言模型在不同任务及能力维度上的表现进行精细化评估,帮助研发人员清晰识别模型的优势与不足,指明优化方向。
  • 学术研究辅助:研究人员可利用MMBench数据集进行新型模型的开发与验证,促进多模态技术前沿领域的探索与研究。
  • 工业落地应用:在企业环境中,MMBench有助于评估和筛选适合特定产品的多模态模型,确保所选模型在实际应用中具备足够的性能与稳定性,从而提升产品的市场竞争力。
  • 教育教学资源:作为优质的教学资源,MMBench帮助学生和研究人员深入理解多模态模型的评估方法及应用场景,通过实践项目和课程练习增强对多模态技术的掌握与应用能力。
  • 跨领域融合应用:MMBench的多模态数据集覆盖文化、科学、医疗等多个领域。例如,CCBench(中国文化相关基准测试)可专门评估模型在特定文化背景下的表现,助力文化研究与跨文化交流的发展。

最新文章

Embedding 批量请求的长度和失败重试设计

Embedding 批量请求的长度和失败重试设计

从批大小、单条长度和整批预算三个维度拆分 Embedding 请求,并用
GitHub Desktop 整理本地提交历史的操作步骤

GitHub Desktop 整理本地提交历史的操作步骤

GitHub Desktop 可以直接在 History 中拖动本地提交
Redis EXPIRE 条件参数如何避免覆盖更长 TTL

Redis EXPIRE 条件参数如何避免覆盖更长 TTL

Redis 反复刷新缓存 TTL 时,普通 EXPIRE 可能把更长的剩
Redis Cluster 槽位统计辅助容量规划的方法

Redis Cluster 槽位统计辅助容量规划的方法

Redis Cluster 容量规划不能只看节点内存,还要同时看 163
Redis MULTI EXEC 无回滚时的业务补偿方案

Redis MULTI EXEC 无回滚时的业务补偿方案

Redis MULTI/EXEC 会把命令串行执行,但不会像关系型数据库
Redis Pipeline 降低往返延迟的批量边界

Redis Pipeline 降低往返延迟的批量边界

Redis Pipeline 通过批量发送命令减少网络往返,但批次过大也