
Web Crypto subtle.digest 处理大文件时如何分块计算
来源:17golang原创
时间:2026-09-14 22:25:36 475浏览 收藏
处理几十 MB 甚至更大的文件时,直接把 file.arrayBuffer() 交给 crypto.subtle.digest() 很容易让内存峰值跟着文件大小上涨。关键点是:Web Crypto 的 subtle.digest() 目前不接收流,也没有 update() 方法;把文件切成多段后分别计算摘要,再把摘要字符串拼接,得到的并不是原文件的 SHA-256。
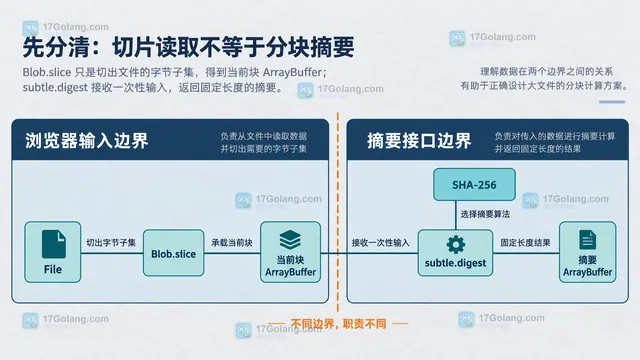
Blob.slice()负责切片,不能改变subtle.digest()的“一次性输入”语义。- 要控制峰值内存,需要一个可持续接收块的哈希器:每块调用
update(),全部读完再调用digest()。 - 块大小先从 4 MiB 试起;大文件或低内存设备可放进 Web Worker,SHA-256 校验也不等于身份认证。
先分清:切片读取不等于分块摘要
原生方案适合小文件,写法很直接:先把完整文件读成一个 ArrayBuffer,再交给 Web Crypto。
async function digestWholeFile(file) {
  // 这里一次性读取完整文件,适合体积可控的输入。
  const bytes = await file.arrayBuffer();
  // digest 不保存可继续 update 的上下文,所以不能把它当流式哈希器。
  const buffer = await crypto.subtle.digest("SHA-256", bytes);
  return Array.from(new Uint8Array(buffer), (byte) =>
    byte.toString(16).padStart(2, "0")
  ).join("");
}
MDN 明确说明,digest() 不支持 streaming input;它接收的是 ArrayBuffer、TypedArray 或 DataView,并返回一个新的摘要 ArrayBuffer。因此下面这种思路只是算出了多个独立文件块的摘要:
// 错误示意:块摘要的拼接不等于整文件摘要。
const partA = await crypto.subtle.digest("SHA-256", await file.slice(0, 4 * 1024 * 1024).arrayBuffer());
const partB = await crypto.subtle.digest("SHA-256", await file.slice(4 * 1024 * 1024).arrayBuffer());
// 这里得到的是 SHA256(partA) 与 SHA256(partB) 的两个结果,不是 SHA256(file)。
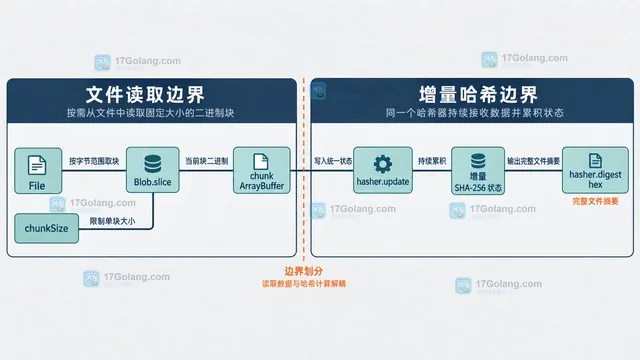
用 Blob.slice 控制每次读入的块大小
Blob.slice(start, end) 会返回原 Blob 的一个子集,arrayBuffer() 再把这个子集读成二进制缓冲区。切片边界要使用字节偏移,不要按字符串字符数计算;文件可能是图片、压缩包或任意二进制数据。
| 环节 | 职责 | 常见误区 |
|---|---|---|
file.slice() | 决定本轮读取的起止字节 | 以为它已经完成摘要 |
part.arrayBuffer() | 得到当前块的二进制视图 | 把所有块保存到数组里,重新制造峰值 |
hasher.update() | 把当前块并入同一个哈希状态 | 每轮重新创建哈希实例 |
hasher.digest() | 结束输入并输出最终摘要 | 在中途调用后继续 update |
真正的分块方案:同一个哈希器持续 update
浏览器端可以选择提供增量接口的库,例如 hash-wasm。它的 createSHA256() 返回带状态的实例,连续调用 update() 后再 digest("hex")。官方项目地址可复制为:https://github.com/Daninet/hash-wasm。
# 安装带有 createSHA256、update 和 digest 接口的前端依赖。
npm install hash-wasm
import { createSHA256 } from "hash-wasm";

export async function digestFileInChunks(file, chunkSize = 4 * 1024 * 1024) {
  // 只接受 Blob/File,并拒绝无意义的块大小,避免循环无法前进。
  if (!(file instanceof Blob)) throw new TypeError("file 必须是 Blob 或 File");
  if (!Number.isSafeInteger(chunkSize) || chunkSize
这段代码把“文件读取”和“摘要状态”分开:slice() 限制单块大小,update() 保留跨块的 SHA-256 上下文。它不会把整个文件装进一个 ArrayBuffer,代价是引入 WASM/依赖、需要额外测试包体和 Worker 调度。
块大小和 Worker 怎么取舍
4 MiB 是一个便于起步的工程值,不是标准答案。块太小会增加 slice()、Promise 和 WASM 边界调用次数;块太大又会抬高单次 ArrayBuffer 的峰值。可以根据设备内存、文件类型和交互响应逐档测试 1、4、8 MiB。
如果哈希计算会让主线程出现明显卡顿,把同一套读取循环搬到 Web Worker;不要在主线程和 Worker 同时保留整份文件副本。需要断点续算时,只有库明确支持保存/恢复内部状态才可以持久化状态,而且状态可能包含输入相关信息,不能当作普通公开元数据。
最后别混淆用途:SHA-256 适合做完整性比对、去重键或上传前校验;如果需求是证明“这份文件来自某个可信方”,还需要签名、密钥管理和服务端验证,单独计算摘要不能完成身份认证。
常见问题
把文件分成多块后分别调用 subtle.digest,能省内存吗?
每次调用的峰值可能变小,但结果是多个块摘要,不是整文件摘要;若要得到整文件 SHA-256,应使用增量哈希器或让服务端以流方式计算。
空文件会返回什么?
循环不会执行,增量哈希器直接 digest() 即可得到 SHA-256 的空输入结果;仍应在业务层决定空文件是否允许上传。
能把 digest 的结果继续 update 吗?
不要这样做。digest() 表示输入结束;要计算另一份文件,应重新初始化或创建新的哈希实例。
-
130 收藏
-
194 收藏
-
414 收藏
-
427 收藏
-
480 收藏
-
419 收藏
-
209 收藏
-
485 收藏
-
173 收藏
-
220 收藏
-
339 收藏
-
471 收藏
-
文章 · 前端 | 11小时前 | 前端 · css · 设计系统 · color-mix · 主题色 · CSS color-mix CSS 颜色混合空间 Oklab 主题色 Oklch 色相插值 前端设计令牌451 收藏
-
367 收藏
-
254 收藏
-
367 收藏
-
222 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习