
Go []rune 转回字符串时为什么长度发生变化
来源:17golang原创
时间:2026-09-15 06:36:21 428浏览 收藏
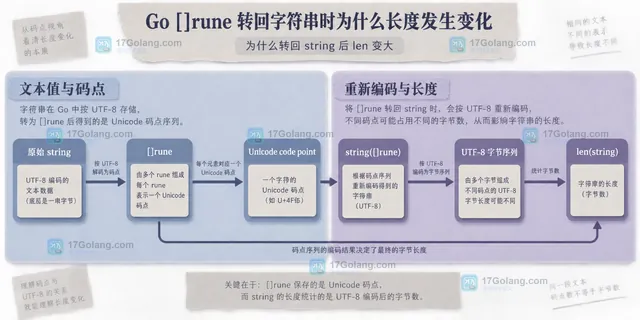
Go 中把 []rune 转回 string 后,len 变大通常不是内容被重复了,而是统计口径变了:[]rune 按 Unicode code point 保存元素,string 按 UTF-8 字节保存内容。中文、表情等字符重新编码后往往占用多个字节,所以 len(string([]rune(s))) 统计的是字节数,不是 rune 数量。
- ASCII 字符通常一个 rune 对应一个字节,中文和多数表情会出现一对多的 UTF-8 字节。
len(s)看字节数,utf8.RuneCountInString(s)看 rune 数量,二者不能互换。- 展示长度、截断边界和协议长度要先确定口径,再决定使用 string、[]rune 还是字节级处理。
为什么转回 string 后 len 变大
先看一个混合 ASCII 和中文的例子:
package main
import (
    "fmt"
    "unicode/utf8"
)
func main() {
    s := "Go你好"
    rs := []rune(s)
    restored := string(rs)
    // len 统计 string 的 UTF-8 字节数;RuneCountInString 统计 Unicode code point 数量。
    fmt.Println(len(s), len(rs), len(restored), utf8.RuneCountInString(restored))
}
s 和 restored 的文本值相同,转换前后并没有凭空增加字符。差异来自表示方式:字母通常占 1 个 UTF-8 字节,而一个中文 code point 常占 3 个字节。[]rune 转换先把字符串中的 UTF-8 序列解码成整数值;转回 string 时,再把这些 code point 编码成 UTF-8 字节序列。
因此,判断“长度变化”前要先问清楚长度指什么。若是网络协议或文件大小,字节长度才是答案;若是文本框最多允许多少个 Unicode code point,应该看 rune 数量。
转换过程不会改变有效文本,但会处理无效字节
对合法 UTF-8 字符串,string([]rune(s)) 通常能还原同样的文本值。字符串若包含无效 UTF-8 字节,转成 []rune 时会按 Go 的解码规则把无效序列处理为替代字符,再转回 string 后,字节内容可能真的与原始值不同。
package main
import (
    "fmt"
    "unicode/utf8"
)
func main() {
    s := string([]byte{'A', 0xff, 'B'})
    rs := []rune(s)
    restored := string(rs)
    // 先判断输入是否为有效 UTF-8,再决定是否允许做 rune 级文本处理。
    fmt.Println(utf8.ValidString(s), len(s), len(rs), len(restored), restored)
}
这里的关键不是死记某个数字,而是先用 utf8.ValidString 判断输入。日志、二进制片段或错误编码的外部数据不应直接当作正常 Unicode 文本;如果必须保留原始字节,就不要先转成 []rune 再试图还原。
用三种长度口径定位差异
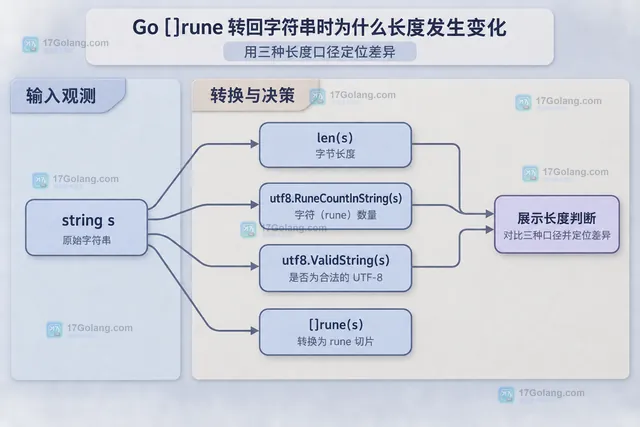
排查时把同一个 string 同时放进三个观察点:len(s) 得到字节数,utf8.RuneCountInString(s) 得到 rune 数量,utf8.ValidString(s) 得到输入是否是合法 UTF-8。[]rune(s) 适合需要按 code point 访问或截断的场景,但它会带来额外内存,并且“一个 rune”等于“一个用户感知字符”也不总成立,例如组合字符和某些 emoji 序列可能由多个 code point 组成。
可以把判断写成三个问题:
- 要限制传输或存储大小吗?使用字节数,并明确是否允许截断 UTF-8。
- 要限制 Unicode code point 数量吗?使用
utf8.RuneCountInString或[]rune后的切片长度。 - 要展示“用户看到的字符数”吗?先确认产品是否需要 grapheme cluster 级别的分割,不能把 rune 数量直接当成最终 UI 字符数。
按场景选择处理方式
如果只是拼接、比较、传输合法文本,优先保留 string;需要按 Unicode code point 读取、替换或截断时,再转换为 []rune,完成操作后转回 string。截断时不要直接按 len(s) 切字节,否则可能把一个 UTF-8 序列切开;如果边界必须按字节控制,则应在协议层明确采用安全的 UTF-8 边界策略。
最后做一次小核对:原始输入和转换结果是否都通过 utf8.ValidString,长度指标是否和业务字段名称一致,是否误把 rune 数量当成用户可见字符数。这样就能把“转回字符串长度变了”拆成可解释、可验证的编码问题。
常见问题答疑
Q1:为什么英文转成 []rune 再转回 string,len 看起来没有变化?
英文 ASCII 字符通常每个只占一个 UTF-8 字节,所以字节数与 rune 数量恰好相同;这只是编码结果相同,不代表两个函数统计的是同一个概念。
Q2:len([]rune(s)) 能不能代替 utf8.RuneCountInString(s)?
对一次性计算通常可以得到同样的 rune 数量,但前者会创建 rune 切片并占用额外内存;只需要计数时优先使用 utf8.RuneCountInString。
Q3:转换后文字显示成 � 是什么原因?
常见原因是输入含有无效 UTF-8 字节,rune 解码阶段使用了替代字符。先用 utf8.ValidString 定位输入问题,不要把替代字符当成原始字节恢复。
Q4:一个 rune 就等于一个用户看到的字符吗?
不一定。组合字符、变体选择符和部分 emoji 可能由多个 code point 组成;如果产品按用户感知字符限制长度,需要采用专门的 grapheme cluster 处理策略。
-
455 收藏
-
423 收藏
-
321 收藏
-
171 收藏
-
316 收藏
-
290 收藏
-
Golang · Go问答 | 36分钟前 | 基准测试 · Go问答 · 内存分配 · Go性能 · map键设计 · Go string []byte map key Go map key 分配 string 转 []byte 性能 Go AllocsPerRun Go map 性能评估137 收藏
-
372 收藏
-
352 收藏
-
300 收藏
-
318 收藏
-
245 收藏
-
210 收藏
-
438 收藏
-
476 收藏
-
208 收藏
-
125 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习