
GPU 集群观测从 CPU 指标扩展时要增加哪些维度
来源:17golang原创
时间:2026-09-15 13:06:44 110浏览 收藏
如果集群监控现在只有 CPU 使用率、负载和内存,扩展到 GPU 时不能只加一条 GPU 利用率曲线。最小可用方案是同时补上四组维度:设备身份与调度归属、计算与显存、温度功耗与错误、任务和互联拓扑。这样才能回答“哪台机器的哪块卡被哪个任务占用”“利用率低是空闲、缺数据还是被 PCIe/NVLink 卡住”。
官方资料:https://docs.nvidia.com/datacenter/dcgm/latest/reference/dcgm-exporter-metrics.html
- GPU 身份至少要能关联 node、GPU UUID、MIG 实例和 workload,名称不要只依赖易变的设备序号。
- 利用率要和显存、时钟、温度、功耗、XID/ECC、PCIe/NVLink 一起看,单指标不能代表吞吐。
- Prometheus 标签应服务于定位;用户 ID、请求 ID 等无界字段应放到日志或事件系统,避免时序爆炸。
先补齐 GPU 集群的四类身份维度
CPU 监控通常围绕 node、CPU 核或实例展开,GPU 还多了一层设备切分和调度映射。建议先固定四类身份:节点身份(cluster、node、机架或可用区)、设备身份(GPU UUID、型号、设备序号)、切分身份(MIG profile、GPU instance、compute instance)以及工作负载身份(namespace、pod、job、队列)。
这里的关键不是把所有字段都复制成标签,而是保留可回溯主键。设备序号适合人看,却可能随重启或枚举顺序变化;UUID 更适合资产关联。MIG 环境还要确认采集器是否真的暴露了 GPU instance 维度,不能因为配置了标签就假定底层字段一定支持。
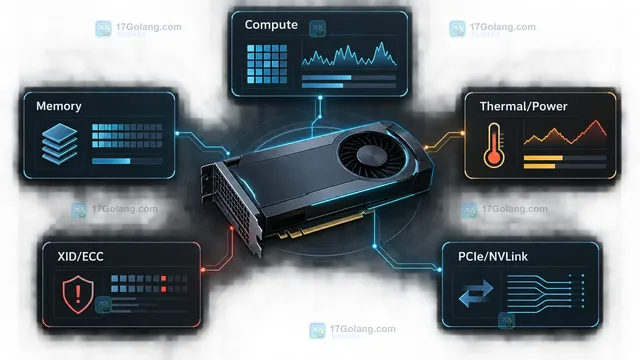
从“利用率”扩展到性能与健康维度
第一层是计算:GPU 利用率、SM 或 tensor 活跃度、核心时钟。第二层是内存:显存已用、空闲、保留量,以及需要时再看显存带宽。第三层是健康:GPU 温度、显存温度、板卡功耗、功耗或温度限制事件、XID、ECC 和重映射行。第四层是数据搬运:PCIe 收发字节、NVLink 吞吐和 P2P 状态。
这几层要组合判断。例如 GPU 利用率低、显存接近上限,可能是等待换入;GPU 利用率高但时钟下降,同时温度或功耗限制事件增长,更像散热或功耗墙;计算指标正常而 PCIe 吞吐异常,则应转向主机到设备的数据路径。DCGM Exporter 的默认字段与可选 profiling 字段并非每种 GPU 都支持,运行时能力和实体类型需要以实际 /metrics 输出为准。
| 排查问题 | 优先维度 | 不要单独下结论 |
|---|---|---|
| 卡是否真的忙 | GPU 利用率、SM 活跃度、时钟 | 只看显存占用 |
| 为什么变慢 | 温度、功耗、限制事件、XID/ECC | 只看平均利用率 |
| 数据是否堵在链路 | PCIe、NVLink、P2P、任务归属 | 只看节点 CPU |
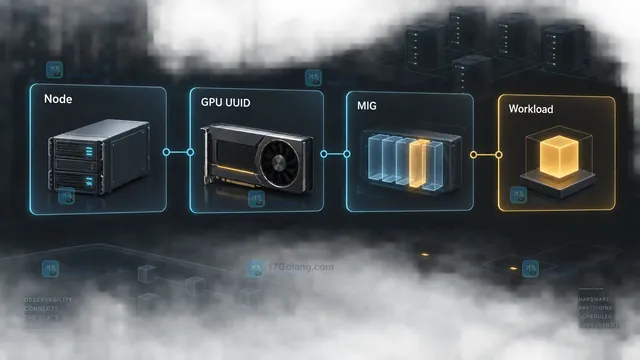
把任务、拓扑和资源分配关联起来
设备指标解决“卡发生了什么”,任务标签解决“谁在使用它”。在 Kubernetes 场景,至少要能从 GPU 时序回到 pod、namespace、job 或调度队列;在 Slurm 等环境,则需要保留作业和分区映射。关联字段最好由资源发现或调度层提供,避免在 Prometheus 中通过不稳定的字符串猜测。
多卡训练还要增加拓扑视角:GPU 到 CPU NUMA 节点的亲和性、PCIe 路径、NVLink 对等状态、跨卡通信流量。它们不必全部进入常驻大盘,可以把拓扑和 profiling 作为故障时的二级面板。这样日常采集成本可控,出现“利用率不低但吞吐上不去”时又有证据可查。
用最小指标集落地,避免标签爆炸
第一版可以先采集每卡利用率、显存已用/空闲、温度、功耗、XID 或健康状态,再补 node 与 workload 关联。对温度、功耗这类故障敏感指标使用更快的 watch group,对容量趋势使用较长周期;采集间隔应按告警反应时间和 exporter 开销共同决定。
# 中文注释:核心容量指标保留稳定身份,业务请求 ID 不放进 Prometheus 标签
gpu_utilization_ratio{cluster="train-a",node="gpu-node-03",gpu_uuid="GPU-demo-03",job="embed-worker"} 0.82
gpu_memory_used_bytes{cluster="train-a",node="gpu-node-03",gpu_uuid="GPU-demo-03",job="embed-worker"} 68719476736

# 中文注释:告警组合多个信号,避免只因一次利用率下降就误报
gpu_utilization_ratio  0.90 * gpu_memory_total_bytes
Prometheus 官方建议谨慎使用高基数标签;用户 ID、请求 ID、完整容器命令等无界字段不适合放进长期时序。实践中可把稳定的 cluster/node/gpu_uuid/workload 作为主维度,把详细调用链和样本级信息留给日志、Trace 或事件系统。新增一组 profiling 指标前,先估算“设备数 × 实体数 × 标签组合 × 保留周期”,再决定是否全量开启。
常见问题
GPU 利用率高就表示训练吞吐高吗?
不一定。还要看显存带宽、时钟、功耗/温度限制、数据搬运和任务吞吐;利用率只是设备忙碌程度的一个投影。
MIG 模式为什么不能直接复用整卡看板?
MIG 会引入 GPU instance 等实体维度,整卡和实例的字段支持可能不同。看板应先确认实际时序中是否有对应实例标签,再决定聚合方式。
为什么不把所有业务字段都加到 GPU 指标上?
每种标签组合都会生成新的时间序列。无界业务字段会让采集、存储和查询成本迅速上升,应把细粒度归因交给日志或 Trace。
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
298 收藏
-
科技周边 · 业界新闻 | 3小时前 | openai · 业界新闻 · AI工程 · API迁移 · OpenAI Responses API Assistants API Conversation previous_response_id394 收藏
-
297 收藏
-
170 收藏
-
187 收藏
-
科技周边 · 业界新闻 | 8小时前 | 云原生 · WebAssembly · 架构设计 · wit · 组件模型 · WebAssembly Component Model WIT WebAssembly组件 服务边界249 收藏
-
202 收藏
-
311 收藏
-
400 收藏
-
344 收藏
-
272 收藏
-
430 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习