
Java GC 日志出现 humongous allocation 时怎么判断
来源:17golang原创
时间:2026-09-15 17:05:54 184浏览 收藏
Java GC 日志里出现 humongous,先不要把它直接判定为内存泄漏。若当前收集器是 G1,判断重点有三层:实际的 Region 大小、对象是否达到半个 Region,以及 Humongous regions: X->Y 是否长期伴随老年代压力、并发标记赶不上分配或 Full GC。只有三组证据能对上,才值得调整分配方式或 G1 参数。
最可靠的第一步是确认 G1 的实际 Region 大小,再用它的一半计算阈值;日志中的 humongous Region 数表示占用的 Region,不等于 Java 对象个数。
官方资料:https://docs.oracle.com/en/java/javase/26/gctuning/garbage-first-g1-garbage-collector1.html
先确认 JVM 的 Region 尺寸
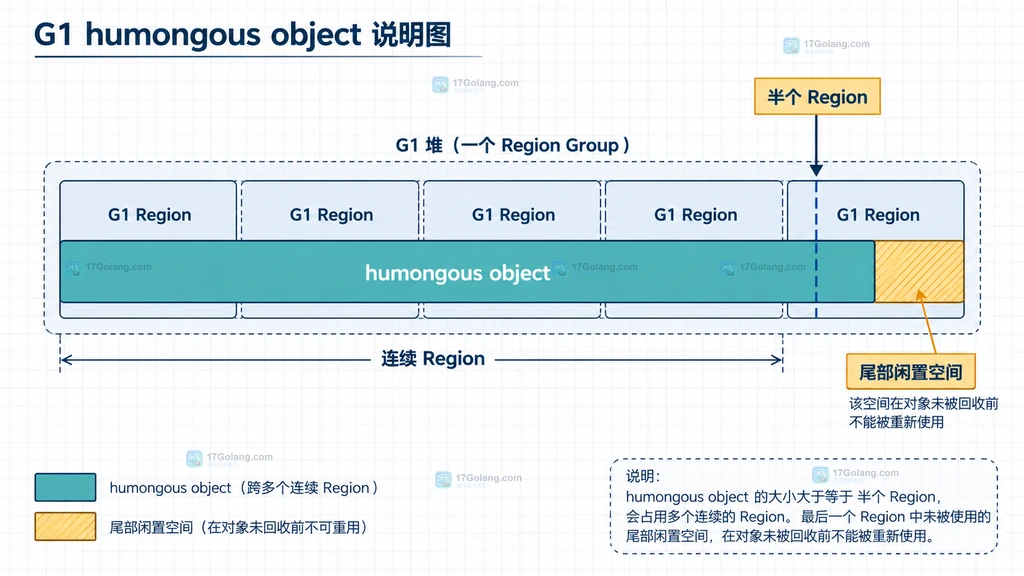
G1 把堆切成大小相同的 Region。对象大小达到单个 Region 的一半,就会走 humongous 分配路径,并占用一段连续的 old-generation Region。这个阈值不是固定的 1 MB 或 2 MB,而取决于本次 JVM 实际选出的 -XX:G1HeapRegionSize。
# 查看本次 JVM 采用的 G1 Region 大小;输出是观测信息,不是调参建议。
java -XX:+PrintFlagsFinal -version 2>&1 | grep G1HeapRegionSize

# 用统一日志保留 GC 标签和堆区变化,便于关联多次事件。
java -XX:+UseG1GC \
  -Xlog:gc*,safepoint:file=gc.log:time,uptime,level,tags \
  -jar app.jar
例如 Region 是 4 MB,理论判断线就是 2 MB;Region 是 16 MB,判断线就是 8 MB。实际对象还会受到对象头、数组长度和对齐影响,所以不要拿业务字段长度直接和阈值做一一对应。启动日志通常也会打印已选的 Region 大小,排查时应以这次进程的值为准。
Region 大小决定 humongous 的阈值
G1 为一个大对象预留连续 Region,起始 Region 放置对象头部,后续 Region 继续承载对象。最后一个 Region 没被对象填满的部分,在对象整体回收前不能拿给普通对象使用。因此,刚刚超过阈值的大数组可能并不大,却会造成明显的尾部空间浪费。
这也是为什么“堆还有很多空闲空间”与“humongous 分配失败”可以同时出现:前者描述总量,后者还要求找到连续的 Region。一个偶发的大对象不一定有问题;反复创建并长期存活的字节数组、压缩缓冲区、序列化结果或大文本,才更值得继续追踪。
从日志判断是偶发大对象还是持续压力
先让日志包含堆区信息,再看相邻 GC 事件中的变化:
# 只保留与 Region 和堆区判断相关的统一日志标签。
java -Xlog:gc+heap=info,gc=info:file=gc.log:time,uptime,level,tags \
  -jar app.jar

# 在副本上快速找出 humongous、老年代和 Full GC 线索;不要把 grep 结果当成对象画像。
grep -E 'Humongous regions|Old regions|Pause Full|Evacuation Failure' gc.log
重点看四个关系:
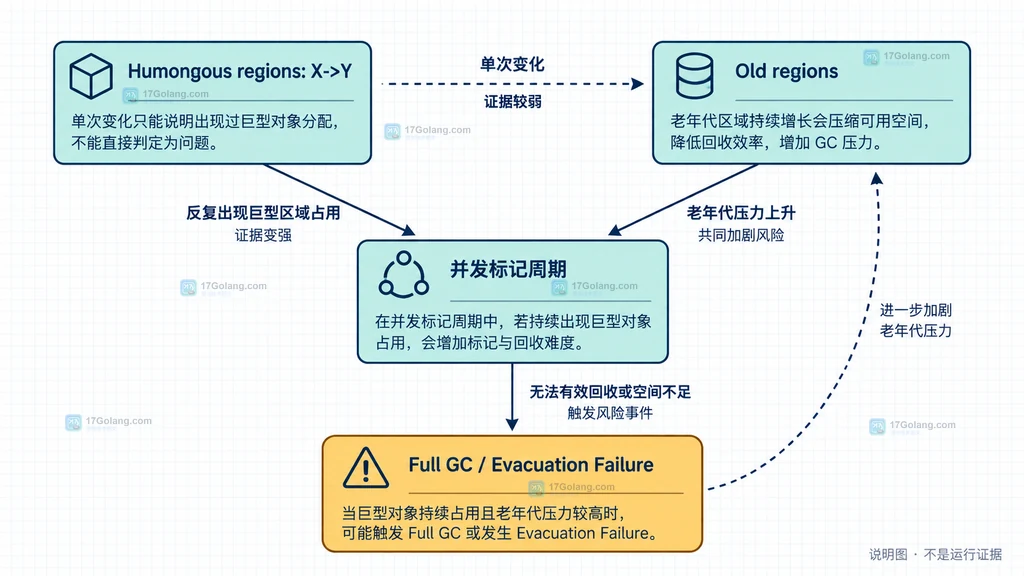
Humongous regions: X->Y:说明本次 GC 前后有多少 Region 被这类对象占用,不能直接推导出对象数量。Old regions:如果 humongous 占用上升,同时老年代长期抬高,说明大对象正在挤压可回收空间。- 并发标记是否及时完成:大量 humongous 分配可能促使 G1 更早启动并发周期,不能只看单次暂停时长。
Pause Full或Evacuation Failure:这类信号与连续空间不足、回收节奏失配有关,优先级高于一次孤立的 humongous 记录。
先改分配形态,再评估 Region 参数
如果同一业务负载下 humongous Region 持续增加,第一选择通常是减少大对象的创建和存活时间:把一次性聚合结果改成分块处理,复用可控大小的缓冲区,限制缓存中的大值,并确认调用链不会无意中长期持有数组。这样解决的是根因,且不会改变整个堆的布局。
如果对象确实是业务必需品,再在压测环境评估增大 -XX:G1HeapRegionSize。Region 变大后,部分对象可能不再达到半 Region 阈值,但 Region 数量、年轻代布局和暂停行为也会一起变化,不能只凭“humongous 变少”判定成功。扩堆、并发标记线程和 IHOP 也只能针对已经确认的压力模式调整。
复查要使用同一版本、同一堆上限和相近的业务负载,至少对比 humongous Region 峰值与回落、Old Region 趋势、Full GC 次数、最长暂停和分配速率。若只是阈值变化而业务分配速率未变,说明问题可能被隐藏,并未真正消失。
常见判断误区
看到 humongous 就说明内存泄漏吗?
不是。它首先是 G1 对大对象的分类。只有在对象持续存活、Region 不回落并伴随堆压力时,才需要继续做引用链或堆转储分析。
把 G1HeapRegionSize 调大一定更好吗?
不一定。它可能让部分对象回到普通分配路径,也可能改变收集粒度和暂停特征。先证明大对象分配是主要压力,再用相同负载做前后对照。
因此,Java GC 日志出现 humongous allocation 时,正确顺序是“确认收集器和 Region 大小、计算阈值、关联多次日志、最后才做方案调整”。把一个词还原成一组可交叉验证的证据,才能避免把正常的大对象误判成泄漏,也避免用全局参数掩盖分配设计问题。
-
Golang · Go问答 | 2个月前 | goroutine · pprof · Go问答 · 线上排查 · 性能调优 · pprof goroutine泄漏 服务告警 Go问答 context取消 Go线上排查374 收藏
-
239 收藏
-
126 收藏
-
文章 · java教程 | 3个月前 | 并发编程 · Spring Boot · 生产实践 · Java教程 · 线程池隔离 · java 并发编程 线程池 spring boot completablefuture191 收藏
-
文章 · java教程 | 3个月前 | Spring Boot · mybatis · 生产实践 · Java教程 · 数据库性能 · java MyBatis 性能优化 spring boot N+1116 收藏
-
305 收藏
-
229 收藏
-
278 收藏
-
257 收藏
-
455 收藏
-
439 收藏
-
385 收藏
-
229 收藏
-
500 收藏
-
400 收藏
-
272 收藏
-
190 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习