
Go Scanner Buffer 设置后为什么仍可能拒绝 token
来源:17golang原创
时间:2026-09-15 18:13:19 383浏览 收藏
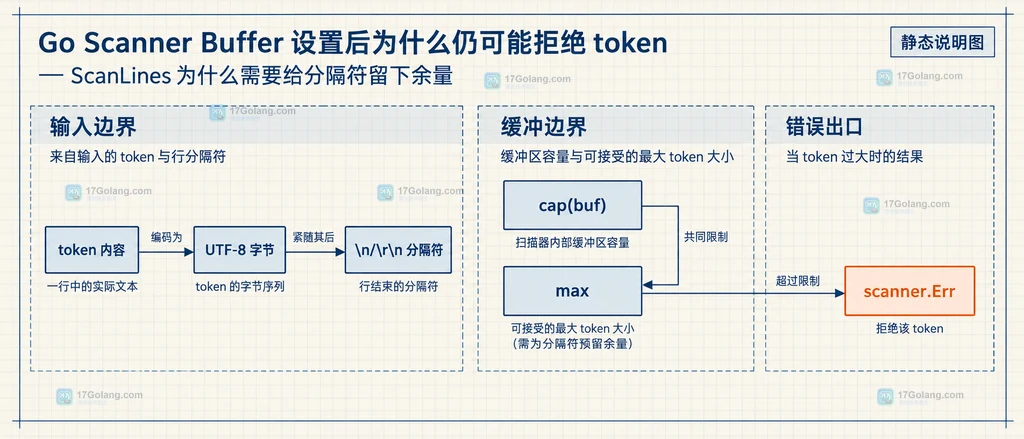
我第一次遇到 bufio.Scanner: token too long 时,已经调用了 scanner.Buffer,却仍然在某一行数据上失败。后来把问题拆开才发现:Buffer 调整的是扫描器的初始缓冲和最大分配边界,不是“允许任意长度 token”的开关。实际长度还要按字节计算,并给分隔符留余量。
排查这类问题,先确认 token 的字节长度,再同时检查cap(buf)、max和分隔符空间;如果输入长度没有可靠上限,就不要继续把 Scanner 的上限往上堆,改用bufio.Reader。
Scanner默认最大缓冲是 64 KiB,ScanLines还可能需要放下换行符。Buffer必须在第一次Scan前调用,且中文字节数不等于字符数。- 超长 token 会让 Scanner 不可恢复地停止;没有上限的输入更适合 Reader。
官方资料:https://pkg.go.dev/bufio
Scanner.Buffer 调大后仍报 token too long,先看这两个上限
bufio.NewScanner 默认使用内部缓冲,MaxScanTokenSize 当前文档值为 64 * 1024。调用 Buffer(buf, max) 后,buf 提供初始容量,max 限制扫描期间可以使用的最大缓冲;如果初始切片的容量已经不小于 max,Scanner 可以只使用这块缓冲而不再分配。
常见误区是只把 max 写成目标行长度。例如目标行约 128 KiB,却把 max 也设成 128 KiB。扫描器需要先拿到足够的输入,让 SplitFunc 找到分隔边界;到达边界前就撞上最大缓冲时,token 还没被交付,Err() 便会返回超长错误。
package main

import (
	"bufio"
	"fmt"
	"strings"
)

func main() {
	input := strings.NewReader("一条可能很长的记录\n")
	scanner := bufio.NewScanner(input)
	// 初始容量和最大容量都留出余量,避免分隔符挤掉最后几个字节。
	scanner.Buffer(make([]byte, 0, 256*1024), 256*1024)
	for scanner.Scan() {
		fmt.Println(len(scanner.Bytes())) // 用字节数观察 token,不把字符数当容量。
	}
	if err := scanner.Err(); err != nil {
		// Scan 返回 false 后必须检查 Err,才能区分 EOF 和超长失败。
		fmt.Println("scan failed:", err)
	}
}
ScanLines 为什么需要给分隔符留下余量
默认的 ScanLines 会返回一行,并去掉行尾标记。这个标记可以是一个换行,也可以是 \r\n。因此,业务上说“这一行是 128 KiB”,通常只描述了 token 内容,不一定包含 Scanner 为确认边界而需要读到的字节。
另外,Go 字符串的长度按字节计算。一个中文字符通常占多个 UTF-8 字节,len(scanner.Text()) 得到的也是字节数;如果要估算容量,不要用“字符数乘一个固定值”来代替实际输入。更可靠的做法是按协议允许的最大字节数加上分隔符和安全余量配置。
| 检查项 | 它说明什么 | 处理建议 |
|---|---|---|
len(token) | 已经交付的 token 字节数 | 用来估算真实上限 |
cap(buf) | 初始缓冲可容纳的字节数 | 不要小于常见 token |
max | 允许 Scanner 扩张到的边界 | 比 token 与分隔符总和更大 |
scanner.Err() | 扫描停止的首个非 EOF 错误 | 必须在循环结束后检查 |
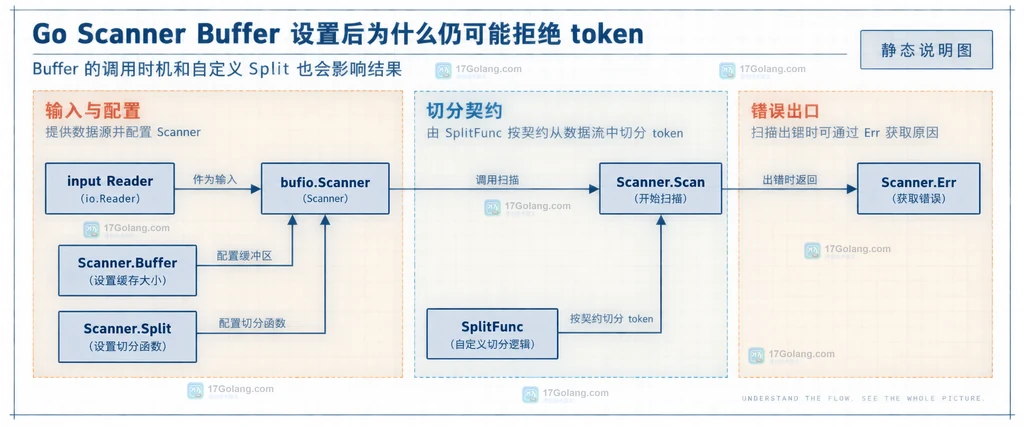
Buffer 的调用时机和自定义 Split 也会影响结果
Buffer 和 Split 都应在第一次调用 Scan 之前设置。扫描已经开始后再调用 Buffer 会触发 panic;这类问题看起来像“参数没有生效”,实际是配置时机错误。
如果使用自定义 SplitFunc,它可能在数据不完整时返回 (0, nil, nil),让 Scanner 继续读入;但如果它一直等一个输入中不存在的终止符,缓冲区最终仍可能达到上限。排查时把 Split 的终止条件写成一句话,并确认完整 token 到达时会返回正的 advance 和非空 token。
split := func(data []byte, atEOF bool) (advance int, token []byte, err error) {
	for i, b := range data {
		if b == ';' {
			// 分号是协议边界;返回正 advance 才能让 Scanner 前进。
			return i + 1, data[:i], nil
		}
	}
	if atEOF && len(data) > 0 {
		// EOF 时交付没有终止符的最后一段,避免无意义地继续等待。
		return len(data), data, nil
	}
	// 尚未读到完整 token,请求 Scanner 继续填充缓冲区。
	return 0, nil, nil
}

scanner := bufio.NewScanner(input)
// Split 和 Buffer 都放在首个 Scan 之前,max 要覆盖协议允许的最大 token。
scanner.Split(split)
scanner.Buffer(make([]byte, 0, 256*1024), 256*1024)
超过可控长度时,换 bufio.Reader 更稳
Scanner 在 token 过大、读取出错或 SplitFunc 返回错误时会停止,而且停止后不能从上一个 token 继续恢复;官方文档也建议,需要更强错误控制或需要处理大 token 时使用 bufio.Reader。如果协议规定每行最多 1 MiB,Scanner 配一个略大的上限很合适;如果一行长度取决于外部文件,Reader 更容易做流式处理和错误分支。
reader := bufio.NewReader(input)
for {
	line, err := reader.ReadString('\n')
	if len(line) > 0 {
		// 这里可以按字节数、业务字段或流式规则自行判断上限。
		fmt.Println(len(line))
	}
	if err != nil {
		// EOF 是正常结束,其他错误需要交给调用方处理。
		if err != io.EOF {
			fmt.Println("read failed:", err)
		}
		break
	}
}
上面的示例若直接使用,需要在导入区补上 io。实际项目中也可以选择 ReadBytes、ReadLine 或带长度限制的自定义读取逻辑,关键是把“如何恢复、何时丢弃当前记录”掌握在业务代码手里。
相关问题
把 max 设大于 cap(buf) 就一定能扫描成功吗?
不一定。它只表示 Scanner 有机会扩张到该边界;token 还要连同需要读取的分隔符放得下,SplitFunc 也必须能识别边界。
中文 token 为什么比想象中更容易触发上限?
Scanner 的容量单位是字节,不是汉字个数。应按 UTF-8 编码后的实际字节数和协议分隔符估算。
如何判断是 Scanner 上限还是业务 Split 出错?
先检查 scanner.Err() 是否为 token too long,再单独确认 SplitFunc 在完整输入和 EOF 两种状态下是否会返回 token。
-
502 收藏
-
502 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
107 收藏
-
478 收藏
-
Golang · Go问答 | 1小时前 | go · os.File · File.WriteAt · 并发写文件 · WriterAt · Go File.WriteAt 并发写 Go 文件分片写入 Go os.File 并发安全 Go WriterAt 不重叠区间 Go O_APPEND WriteAt307 收藏
-
489 收藏
-
350 收藏
-
198 收藏
-
Golang · Go问答 | 2小时前 | 排查 · 条件编译 · Go问答 · 构建约束 · 编译标签 · Go //go:build go list build tag build constraints // +build331 收藏
-
333 收藏
-
Golang · Go问答 | 2小时前 | internal · Go问答 · Go Modules · 包可见性 · 工作区排查 · Go internal go.work 多模块工作区 import path314 收藏
-
Golang · Go问答 | 2小时前 | 依赖管理 · go · module · retract · 版本选择 · go mod download Go module retract Go 模块撤回 Go 依赖版本缓存 go list -retracted368 收藏
-
113 收藏
-
487 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习