
MySQL 直方图怎么改善倾斜列的行数估算
来源:17golang原创
时间:2026-09-26 20:08:16 341浏览 收藏
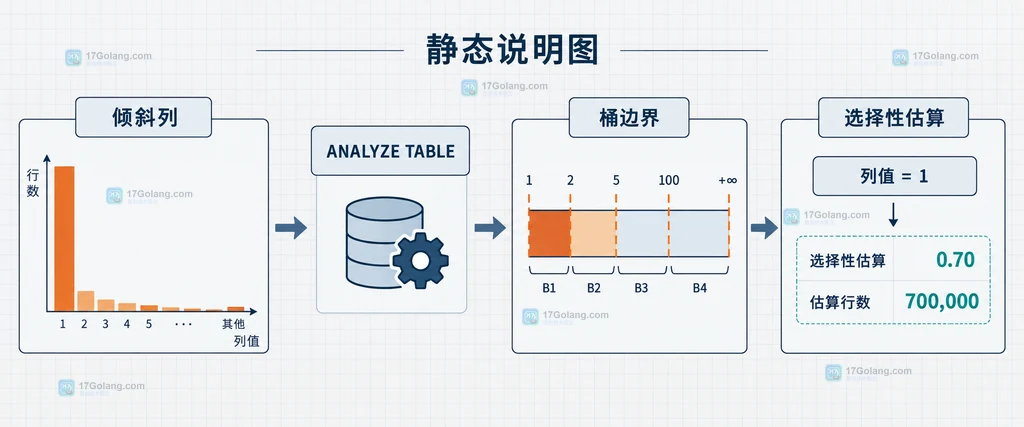
MySQL 查询在数据分布均匀时,普通索引基数或默认选择性往往够用;但当一列的大多数记录集中在少数值上,优化器可能把过滤条件估得过宽或过窄,进而选错连接顺序和访问方式。处理这类问题,先保留原始 EXPLAIN,再用 ANALYZE TABLE ... UPDATE HISTOGRAM 为倾斜列建立统计,最后回到执行计划比较,而不是一上来盲目加索引。
官方文档:https://dev.mysql.com/doc/refman/8.4/en/analyze-table.html
- 直方图主要帮助非索引列或选择性估算不准的列,不会强制 MySQL 改用某个执行计划。
- 默认桶数是 100,可按数据分布尝试 32、64 或 128;检查结果时重点看 histogram-type 和 sampling-rate。
- 数据持续变化会让手动直方图变旧;收益不稳定就重新生成,必要时用 DROP HISTOGRAM 回滚。
先确认倾斜列,再建立直方图
触发信号通常是:同一条 SQL 的估算行数与实际扫描量差距很大,过滤列没有合适的单列索引,或者某个状态值占了绝大多数记录。先把业务查询缩小成可复现的过滤条件,并记录执行计划。下面的表名和列名只作示例,生产环境应替换为实际对象。
-- 先保存过滤条件的估算基线,避免建统计后无法比较
EXPLAIN
SELECT order_id, customer_id
FROM orders
WHERE order_status = 'pending';

-- 用频次检查倾斜方向;这里只取前几种值,避免打印整列
SELECT order_status, COUNT(*) AS row_count
FROM orders
GROUP BY order_status
ORDER BY row_count DESC
LIMIT 8;
如果 pending 占比很高,而 cancelled、refunded 很少,均匀分布假设就容易失真。直方图特别适合让优化器知道这种值域差异;但如果列已有高选择性的索引,范围优化器或索引采样可能优先于直方图,不能只看统计对象的存在就判断问题已解决。
用 UPDATE HISTOGRAM 让值域分布进入统计
MySQL 用 ANALYZE TABLE 管理直方图。桶数不是越大越好:32 或 64 适合先做低成本试验,复杂的长尾值域再考虑 100 或 128。单次变更多个桶数会影响比较结果,因此应一次只调整一个变量。
-- 先用 64 个桶描述订单状态的值域分布
ANALYZE TABLE orders
  UPDATE HISTOGRAM ON order_status
  WITH 64 BUCKETS;

-- 如果本次试验收益不稳定,删除这一列的直方图
ANALYZE TABLE orders
  DROP HISTOGRAM ON order_status;
官方语法允许 1 到 1024 个桶,省略 WITH 时默认是 100。建立操作会更新数据字典中的统计对象,不是给表增加索引,也不会替代索引设计。对加密表、临时表、JSON 和空间类型等不支持或不适合生成的列,应先查清限制再执行。
检查 COLUMN_STATISTICS,别只看建表语句成功
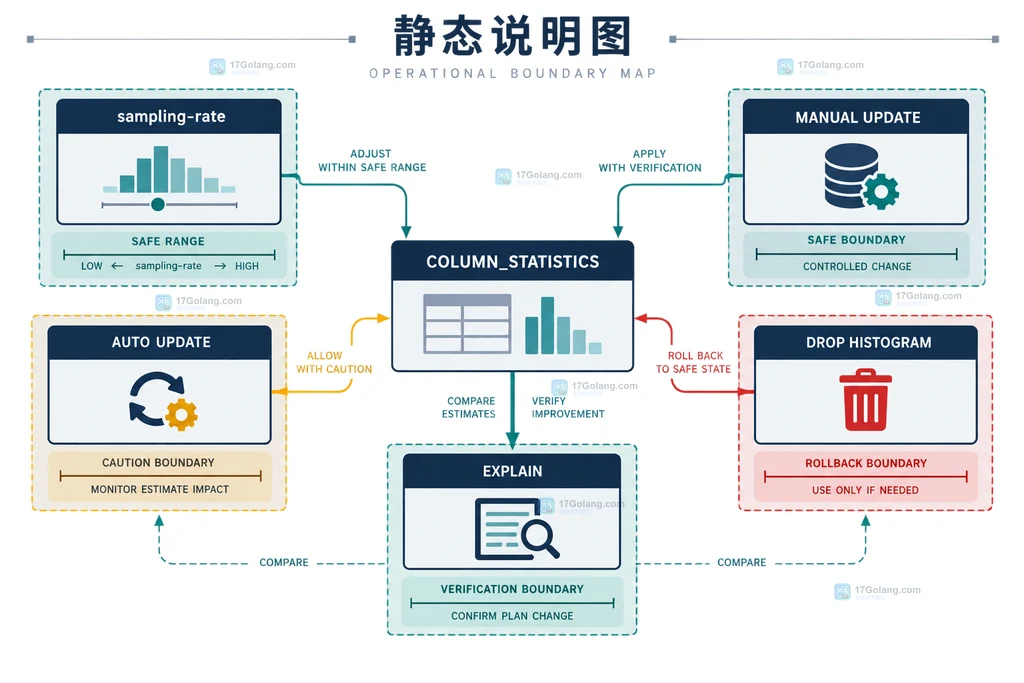
ANALYZE TABLE 返回成功,只能说明统计生成请求被接受。还要查看直方图类型、指定桶数、实际桶数量以及采样率。低于 1 的 sampling-rate 表示生成过程读取了部分数据,数据越偏、样本越少,越要谨慎解读结果。
-- 查看直方图的类型、桶数和采样比例
SELECT
  TABLE_NAME,
  COLUMN_NAME,
  HISTOGRAM->>'$."histogram-type"' AS histogram_type,
  HISTOGRAM->>'$."number-of-buckets-specified"' AS bucket_count,
  HISTOGRAM->>'$."sampling-rate"' AS sampling_rate,
  HISTOGRAM->>'$."last-updated"' AS last_updated
FROM INFORMATION_SCHEMA.COLUMN_STATISTICS
WHERE SCHEMA_NAME = DATABASE()
  AND TABLE_NAME = 'orders'
  AND COLUMN_NAME = 'order_status';
低基数列可能生成 singleton 直方图,一个桶对应一个值;不同值很多时通常是 equi-height,一个桶描述一段范围。关注桶数是否足以区分长尾,不要把“桶数更多”误当成“估算一定更准”。
用 EXPLAIN 判断收益,并保留回滚路径
重新执行原查询,比较 rows、filtered、访问类型以及连接顺序。如果环境支持并且查询可以在受控范围运行,再用 EXPLAIN ANALYZE 对照实际行数。重点是估算误差是否缩小、总耗时是否改善,而不是某个字段是否发生变化。
-- 重新查看优化器对过滤结果的估算
EXPLAIN FORMAT=JSON
SELECT order_id, customer_id
FROM orders
WHERE order_status = 'pending';

-- 在可控的只读窗口对照实际执行行数;生产环境先评估额外开销
EXPLAIN ANALYZE
SELECT order_id, customer_id
FROM orders
WHERE order_status = 'pending';
如果估算变准但执行时间没有下降,说明瓶颈可能在回表、排序、连接或 I/O,而不是单列选择性。此时不要继续盲增桶数,应回到索引、SQL 形状和数据访问量排查。
刷新策略、回滚条件和常见问题
直方图默认是手动更新:批量导入、状态分布明显变化或计划漂移时重新执行 UPDATE HISTOGRAM。MySQL 8.4 支持在创建时指定 AUTO UPDATE,让后续 ANALYZE TABLE 及 InnoDB 持久统计重算时一并更新;如果需要可控发布,继续使用默认的 MANUAL UPDATE。
回滚条件可以设为:估算误差没有收窄、计划在高峰时段变差、采样比例过低且无法稳定复现。先记录对比结果,再执行 DROP HISTOGRAM,不要直接删除整张表的统计信息。
| 现象 | 优先判断 | 处理方向 |
|---|---|---|
| 无索引列估算偏差大 | 值域是否明显倾斜 | 建立直方图并比较 EXPLAIN |
| 已有索引但计划不变 | 是否由范围优化器或索引采样主导 | 检查索引列顺序和实际访问量 |
| 刚建好不久又失真 | 统计是否已过期 | 安排手动刷新或评估 AUTO UPDATE |
| 新计划变慢 | 估算是否改善但路径成本上升 | 保留证据后 DROP HISTOGRAM 回滚 |
相关问题
直方图会自动随着每次 INSERT 更新吗?
默认不会。它是按需生成或更新的持久统计;数据变化后可能逐渐过期,需要在合适窗口重新分析。
桶数是不是越大越好?
不是。桶数增加会提高分布表达能力,但也增加生成和维护成本。建议从 32 或 64 开始,用估算误差和计划稳定性决定是否调整。
建了直方图为什么执行计划没有变化?
可能是原列已有索引,范围估算优先;也可能原估算已经足够,或者直方图没有覆盖当前谓词。回看 COLUMN_STATISTICS 和 EXPLAIN,不要只凭 SQL 成功消息下结论。
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
175 收藏
-
432 收藏
-
390 收藏
-
244 收藏
-
228 收藏
-
116 收藏
-
434 收藏
-
404 收藏
-
445 收藏
-
418 收藏
-
465 收藏
-
364 收藏
-
- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-
- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-
- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-
- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-
- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习