
银行统一 AI 训练与推理平台为什么采用云原生架构
来源:17golang原创
时间:2026-09-28 03:41:55 369浏览 收藏
银行统一 AI 训练与推理平台采用云原生架构,核心原因不是“流行”,而是要在同一套治理面上共享异构加速器、数据路径、模型资产和监控能力,同时允许训练与在线推理使用完全不同的队列、弹性和运行时策略。Kubernetes 适合承担统一控制面;Kueue、KEDA、HAMi、Fluid、Prometheus 等组件则把训练准入、推理扩缩容、细粒度算力分配、数据加速和指标反馈拆成可组合的能力。
官方案例:https://www.cncf.io/case-studies/china-merchants-bank-2/
2026 年 9 月,CNCF 公布招商银行统一 AI 训练与推理平台案例。案例描述的平台管理近一万张异构加速卡,并把 99% 的资源纳入统一框架。这个案例的价值不只在规模,更在于它清楚展示了“统一底座、分离策略”如何落地。下面按触发场景、资源边界、两条流水线、门禁、失败处理和复盘指标来拆解。
统一不是把训练和推理塞进同一条流水线
训练和推理都消耗加速器,却不是同一种工作负载。训练通常运行时间长、可排队,需要配额、公平性、优先级和批量资源;在线推理强调低延迟、可用性和快速弹性,流量波动时必须及时增减副本。若强行使用一套调度规则,训练可能抢占在线容量,推理的碎片化需求也可能降低大规模训练任务的装箱效率。
因此,案例中的“统一”指向共享控制面,而不是统一执行策略:
- 训练路径:Training API 把作业转换为 Kubernetes Deployment Pods,训练运行时采用 Twinkle on Ray,并由 Kueue 管理队列、配额和准入。
- 推理路径:Inference Gateway 把服务请求交给 Deployment Pods,推理运行时采用 vLLM 或 SGLang on Ray,Prometheus 指标与 KEDA 共同驱动扩缩容。
- 共享底座:Kubernetes Scheduler 与 HAMi 负责 Pod 放置及共享加速器容量分配,Fluid 加速数据集、模型权重和检查点,监控体系贯穿两条路径。
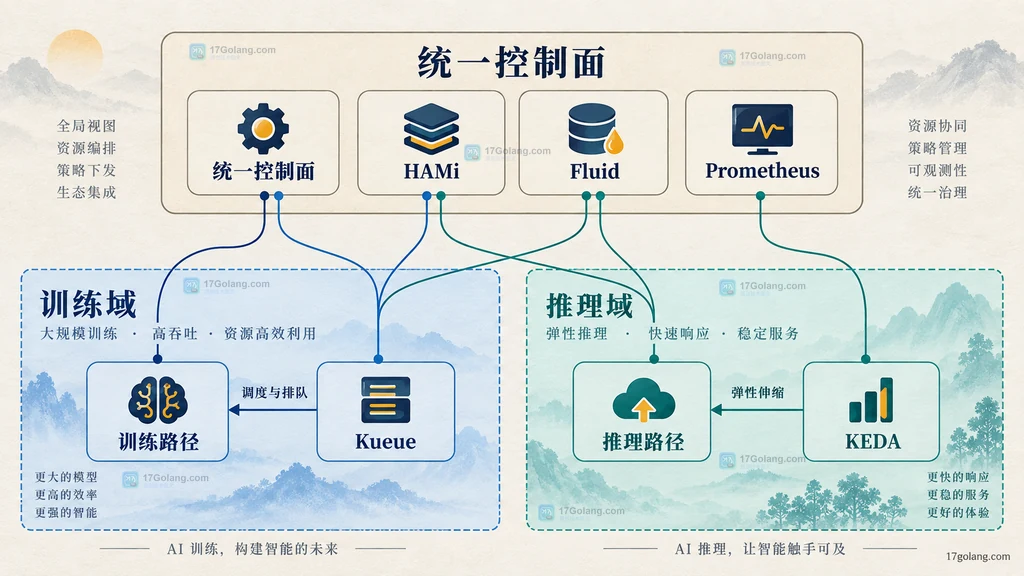
这种设计解决了两个看似冲突的目标:平台团队只维护一套资源视图、身份边界和运维接口;算法与业务团队仍能按工作负载类型选择合适的运行时和策略。
权限配置的本质是划清三层资源边界
统一平台的权限不能只停留在“谁能提交作业”。至少要覆盖租户、工作负载和设备三个层级。
| 边界 | 要控制的对象 | 常见门禁 |
|---|---|---|
| 租户边界 | 团队、项目、成本中心 | 命名空间、配额、优先级、模型访问权限 |
| 工作负载边界 | 训练作业、微调任务、在线服务 | 准入策略、最小资源、并发量、服务等级 |
| 设备边界 | 不同型号的 GPU 或其他加速卡 | 拓扑、显存、算力份额、亲和与隔离策略 |
HAMi 在这里承担细粒度设备共享能力。CNCF 早期招商银行案例提到,通过拓扑感知调度和设备分区,可以把分配粒度细化到 1 GB 显存和 1% 算力。它意味着小型推理或微调任务不必独占整张卡,但平台必须同步设置隔离、超售和故障域规则,不能只追求更高装箱率。
训练流水线先做准入,再做资源编排
训练任务的关键不是“立刻启动”,而是“在满足配额和资源条件后稳定启动”。案例把 Kueue 放在训练准入位置,队列接收任务后先判断租户配额、优先级和可用资源,再允许工作负载进入集群。这比让大量 Pod 先创建、再长期 Pending 更容易解释资源去向,也便于平台执行公平共享。
一条稳妥的训练流水线通常包含以下阶段:
- 提交:Training API 接收作业参数、镜像、数据集和资源声明。
- 准入:Kueue 检查队列、配额和优先级,未满足条件的任务保持等待状态。
- 放置:Kubernetes Scheduler 与 HAMi 根据卡型、拓扑、显存和算力份额放置 Pod。
- 数据就绪:Fluid 缓存训练数据、模型权重和检查点,减少节点切换造成的重复传输。
- 运行与恢复:Ray 承载分布式任务,平台持续采集队列、设备、吞吐和失败指标。
这里的自动化重点是“门禁前置”:配额不足、设备类型不匹配、数据未就绪时不进入执行阶段。否则,统一平台只是把原来的资源冲突集中到了一个更大的集群。
推理流水线依靠指标反馈调整容量
在线推理不能沿用训练队列的等待逻辑。请求已经到达时,系统需要根据延迟、吞吐或队列深度快速调整服务副本。案例中,Inference Gateway 负责入口,vLLM 或 SGLang on Ray 承担推理,Prometheus 暴露指标,KEDA 根据指标触发扩缩容。
这种组合把“扩容依据”从固定 CPU 使用率扩展到更贴近业务的信号。例如,平台可以关注请求排队、首 Token 延迟、每秒 Token 数和设备利用率。但门槛不能只设置一个数字:扩容还要核对可用加速器、模型权重加载时间、冷启动成本和最小冗余;缩容则必须避免中断活跃请求。
训练与推理最终仍会在共享资源池相遇。因此容量策略应预留在线服务底线,再把剩余资源交给训练队列使用;当线上压力上升时,通过明确的优先级和抢占边界回收容量,而不是临时人工协调。
共享数据路径和模型资产比共享集群更重要
如果训练完成后还要手工复制权重、重新登记版本、再由另一套系统加载,所谓统一平台只统一了算力。案例把 Fluid 放入共享数据路径,让数据集、模型权重和检查点可以被缓存和复用;训练与推理因此能围绕同一套模型资产建立交付关系。
统一模型生命周期至少要保存模型版本、基础模型与适配器关系、训练数据版本、运行时兼容信息、审批状态和回滚目标。这样,推理服务扩容时才能确定加载哪份权重,训练失败后也能从明确的检查点恢复,而不是依赖临时目录或操作人员记忆。
CNCF 案例还描述了 LoRA 多租户共享:默认五个 LoRA 租户共享一个基础模型实例,使训练密度提高到 5 倍,并把五个独立副本收敛为一个共享实例。这个结果依赖模型与隔离方案,不应直接套成所有模型的固定比例,但它很好地说明了“共享模型资产”为什么可能比单纯共享设备带来更大的收益。
真正可落地的是一组平台门禁
自动化平台不能把“提交成功”当成“可以运行”。更稳妥的做法是把关键条件拆成可观测、可拒绝、可恢复的门禁:
- 训练准入门禁:配额、队列、优先级和设备类型同时满足后才创建执行资源。
- 共享就绪门禁:加速器份额可分配、数据可访问、模型版本已登记,缺一项都不进入运行态。
- 推理容量门禁:延迟或队列信号触发扩容时,还要检查卡型、权重缓存和最大副本数。
- 发布门禁:模型、运行时、路由和监控指标必须绑定同一版本,才能切换生产流量。
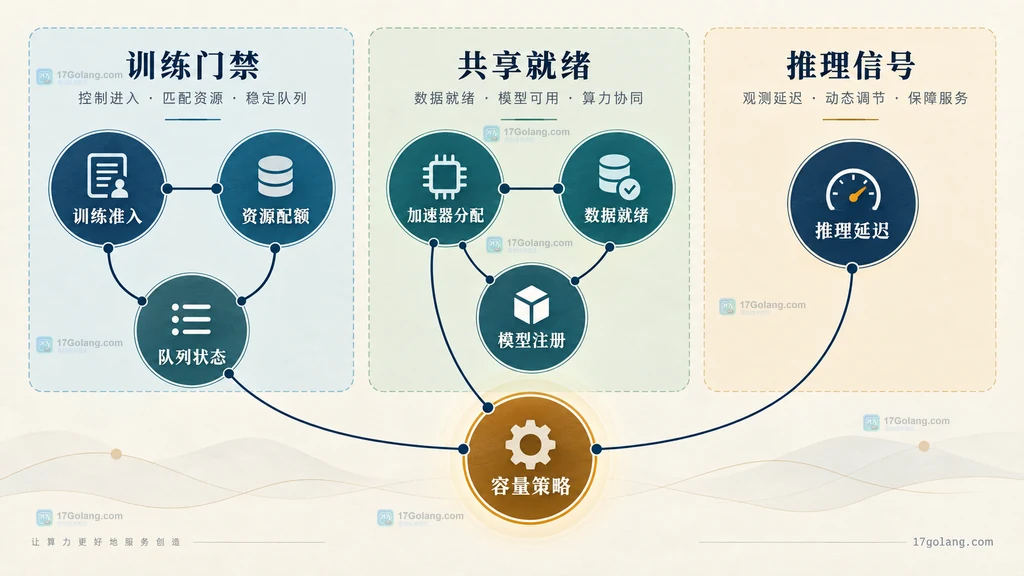
每个门禁都要返回可解释状态。比如“等待资源”应区分配额不足、目标卡型缺失、拓扑不满足和数据缓存未完成;否则自动化只会把问题藏在一个 Pending 状态里。
失败处理要按控制面、资源面和数据面分层
统一平台扩大了资源池,也扩大了故障影响范围。失败处理应至少分成三类:
- 控制面异常:暂停新的准入与发布,不立即终止已有训练和推理;控制面恢复后先对账,再继续调度。
- 资源面异常:隔离故障设备,重新计算可分配份额;训练从检查点恢复,推理把流量迁移到健康副本。
- 数据面异常:禁止加载不完整权重,回退到已登记版本;缓存失效时允许降级到源存储,但要限制并发以防止传输风暴。
通知也要带上租户、任务、资源类型、模型版本、失败门禁和建议动作。只发送“Pod 启动失败”无法支持银行平台的值班与审计要求。
用前后对比指标复盘,而不是只看集群规模
CNCF 案例披露的行内结果包括:平均加速器计算利用率从 35% 提升到 60% 以上;可比口径下每百万 Token 推理成本下降超过 60%;默认五个 LoRA 租户共享基础模型实例,训练密度达到原来的 5 倍。早期 HAMi 案例还披露,拓扑感知调度使跨机器调度降低 30%。
这些数字是案例方在自身模型、硬件和统计口径下的前后对比,不是所有银行都能直接复现的基准。真正值得复用的是测量框架:
| 维度 | 建议指标 | 要避免的误读 |
|---|---|---|
| 资源效率 | 设备利用率、显存碎片、排队时长 | 只看瞬时利用率,不看任务等待 |
| 训练交付 | 准入等待、完成率、检查点恢复时间 | 把排队任务算作运行任务 |
| 推理服务 | 首 Token 延迟、吞吐、每百万 Token 成本 | 跨模型、跨精度直接比较成本 |
| 平台治理 | 人工干预次数、回滚时间、告警可解释率 | 只统计部署次数,不统计恢复质量 |
因此,银行选择云原生架构的结论可以概括为:用统一控制面减少重复建设和资源碎片,用可组合组件保留训练与推理的差异化策略,再通过门禁、指标和回滚把共享资源变成可治理的平台能力。云原生不是目标,稳定地协调异构算力、模型资产和多租户服务才是目标。
相关问题
统一训练与推理平台一定要共用一个集群吗?
不一定。统一首先是控制面、资源视图、模型资产和治理规则统一。出于合规、故障域或地域要求,执行集群可以物理分离,只要平台能保持一致的准入、版本和观测模型。
为什么不能只使用 Kubernetes 原生调度器?
原生调度器适合通用 Pod 放置,但训练还需要队列、配额和整组准入,推理需要业务指标驱动弹性,异构设备还需要更细的共享和拓扑能力。案例采用 Kueue、KEDA、HAMi 等组件,是为了补齐这些领域策略。
训练和推理共享资源会不会影响线上稳定性?
会有风险,所以必须设置在线容量底线、优先级、抢占边界和故障域。共享的前提是策略隔离与可观测,而不是把所有任务无条件放进同一个资源池。
评估是否值得建设统一平台,先看什么?
先看异构设备碎片、训练排队、推理容量波动、模型复制次数和人工交接成本。如果这些问题已跨团队反复出现,统一控制面和共享数据路径通常比继续扩充孤立集群更有价值。
-
214 收藏
-
Golang · Go教程 | 3个月前 | 性能优化 · kubernetes · Go教程 · 生产实践 · Go1.25 · golang Go Kubernetes 性能优化 GOMAXPROCS473 收藏
-
Golang · Go教程 | 1个月前 | 容器 · go · 性能 · kubernetes · 运行时 · Kubernetes GOMAXPROCS cgroup Go 1.25 容器 CPU 限额438 收藏
-
318 收藏
-
353 收藏
-
102 收藏
-
科技周边 · 业界新闻 | 7小时前 | 云原生 · AI基础设施 Kubernetes 平台工程 CNCF Japan State of Cloud Native Development in Japan 2026439 收藏
-
213 收藏
-
150 收藏
-
381 收藏
-
216 收藏
-
117 收藏
-
463 收藏
-
116 收藏
-
216 收藏
-
153 收藏
-
375 收藏
-
- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-
- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-
- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-
- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-
- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习