
Go url.ParseQuery 怎么处理重复参数和分号错误
来源:17golang原创
时间:2026-09-28 06:57:57 455浏览 收藏
url.ParseQuery 处理重复参数时不会覆盖旧值,而是把同名键的值依次放进 url.Values 的字符串切片中;处理未编码分号时,则会把包含分号的整个设置判为无效并返回错误。需要特别注意的是:即使返回了错误,结果 map 仍然是非空对象,其中可能保留了其他解析成功的参数。
因此,稳定的处理方式可以概括为三点:多值参数直接读取 values[key],只需要一个值时才调用 Get;分号如果是数据就由客户端编码为 %3B;服务端直接调用 ParseQuery 并检查错误,不要在需要严格校验时只依赖会忽略解析错误的 URL.Query()。
Go 官方文档:https://pkg.go.dev/net/url#ParseQuery
先看 ParseQuery 的返回模型
url.ParseQuery 接收不带问号的查询字符串,例如 tag=go&tag=web&page=2,返回 (url.Values, error)。其中 url.Values 的底层类型是 map[string][]string。键是参数名,值不是单个字符串,而是一组字符串。
raw := "tag=go&tag=web&page=2&draft"
values, err := url.ParseQuery(raw)
if err != nil {
    return err
}

fmt.Println(values["tag"])      // [go web]
fmt.Println(values.Get("tag"))  // go
fmt.Println(values.Get("page")) // 2
fmt.Println(values.Get("draft")) // 空字符串
没有等号的 draft 会被解释为键 draft 对应一个空值。它与 draft= 的读取结果相同,但与“根本没有 draft 参数”并不完全等价。如果业务必须区分缺失和空值,应配合 values.Has("draft"),而不是只比较 Get 的返回字符串。
| 查询片段 | Values 中的结构 | Get 返回 |
|---|---|---|
tag=go&tag=web | map["tag"] = []string{"go", "web"} | go |
draft | map["draft"] = []string{""} | 空字符串 |
没有 draft | 键不存在 | 空字符串 |
重复参数应该怎么读取
重复键本身并不是错误。筛选标签、多个字段、批量 ID 等接口经常使用 tag=go&tag=web 这种形式。真正需要先确定的是:这个参数在业务上是单值还是多值。
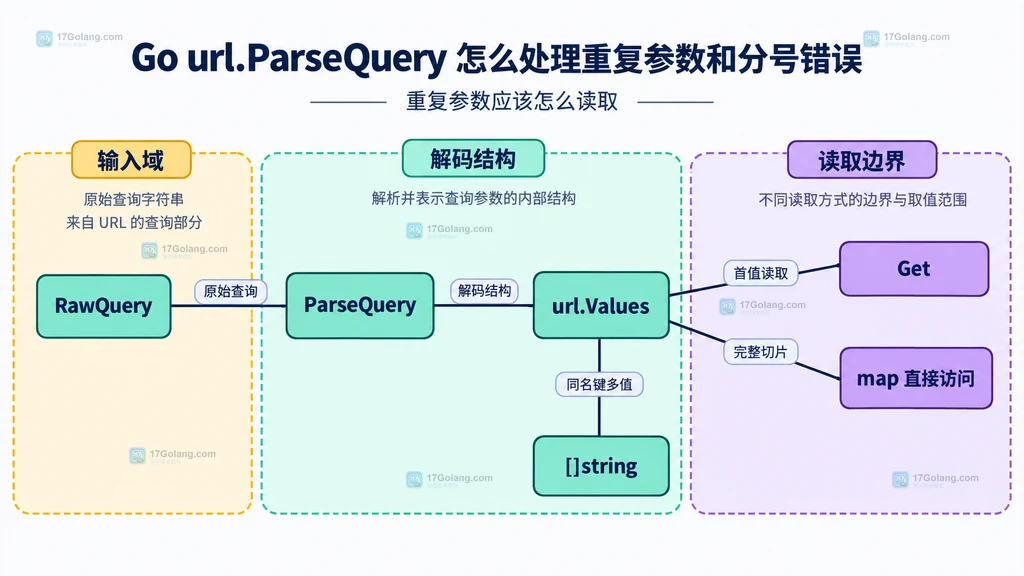
多值参数:直接读取切片
// 多值参数直接读取完整切片,不调用 Get
tags := values["tag"]
for _, tag := range tags {
    if tag == "" {
        return fmt.Errorf("tag 不能为空")
    }
}
直接索引可以保留全部值和原有顺序。取得切片后还应按业务限制数量、单值长度和允许字符,避免一个看似普通的筛选参数无限膨胀。
单值参数:先确认重复值策略
values.Get("page") 只返回第一个值。若客户端发送 page=1&page=9,直接使用 Get 会把第二个值静默丢掉。公开 API 最好明确选择以下一种策略:
- 严格策略:切片长度不是 1 就返回参数错误;
- 首值策略:明确约定只使用第一个值,并把该约定写进接口文档;
- 末值策略:显式读取切片最后一个元素,不要误以为
Get会这样做。
// 单值参数显式拒绝重复键,避免悄悄丢值
func one(values url.Values, key string) (string, error) {
    items, ok := values[key]
    if !ok || len(items) == 0 {
        return "", fmt.Errorf("缺少参数 %s", key)
    }
    if len(items) != 1 {
        return "", fmt.Errorf("参数 %s 只能出现一次", key)
    }
    return items[0], nil
}
构造查询参数时,Add 会在现有切片后追加值,Set 会替换该键的全部旧值。Encode 会为切片里的每个值再次输出同名键,并按键名排序。解析和构造两侧如果对多值规则理解不同,就容易产生只生效一个标签或签名串不一致的问题。
未编码分号为什么报错
ParseQuery 期望每个 key=value 设置使用 & 分隔。包含未经过 URL 编码的分号的设置被认为无效。比如:
name=alice;admin=true&page=2
第一个设置中存在原始分号,因此该设置不会进入结果;page=2 仍可能被保留,同时函数返回类似 invalid semicolon separator in query 的错误。分号不是此处可替代 & 的分隔符。
如果分号本来就是值的一部分,例如备注 north;south,客户端必须把它编码为 %3B:
note=north%3Bsouth&page=2
解析后 note 的值就是 north;south。不要在服务端用 strings.ReplaceAll(raw, ";", "&") 之类的方式“修复”输入:这样无法区分数据中的分号和客户端误用的分隔符,还可能让不同代理、网关和应用层对同一请求产生不同解释。
错误和部分结果如何同时处理
官方文档说明,ParseQuery 总会返回一个非 nil map,其中包含已经找到的有效参数;error 描述遇到的第一个解码错误。除未编码分号外,错误的百分号转义也可能让某个设置解析失败。
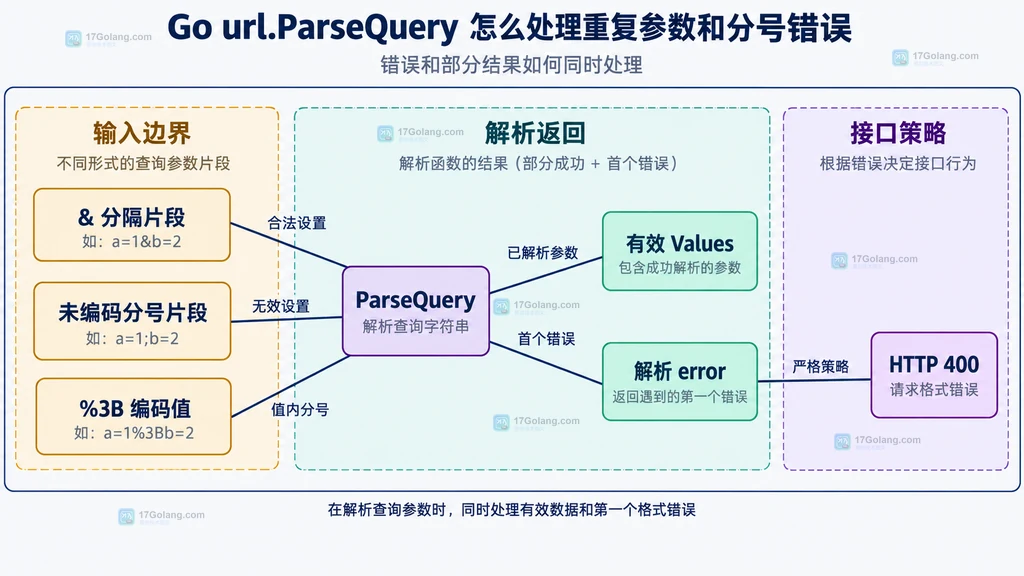
这会形成一个容易踩坑的状态:values 里有数据,err 也不为 nil。不要用 len(values) > 0 代替错误检查,也不要因为看到错误就误认为 map 一定为空。
// 严格模式直接检查解析错误,不消费部分结果
values, err := url.ParseQuery(rawQuery)
if err != nil {
    // 严格接口:任何格式错误都拒绝,不消费部分结果
    return nil, fmt.Errorf("查询参数格式错误: %w", err)
}
return values, nil
对鉴权、分页、排序、金额、导出条件等会改变结果边界的参数,通常应采用严格策略:只要 err != nil 就返回 400,并且不使用部分结果。这样客户端能尽早修正编码,也避免“某些参数生效、某些参数被跳过”的隐蔽状态。
若是在日志分析、兼容历史数据或离线清洗中确实需要保留部分结果,也应显式记录错误,并把“部分解析”建模成独立状态,不能悄悄忽略错误:
// 离线清洗场景显式保留部分解析状态和警告
values, err := url.ParseQuery(rawQuery)
result := ParseResult{
    Values:  values,
    Partial: err != nil,
}
if err != nil {
    result.Warning = err.Error()
}
在 HTTP 接口里建立稳定边界
r.URL.Query() 使用起来很方便,但 URL.Query 的实现会调用 ParseQuery(u.RawQuery) 并丢弃返回的错误。因此,只要接口需要识别未编码分号、错误转义等格式问题,就应直接解析 r.URL.RawQuery。
func parseListQuery(r *http.Request) (ListQuery, error) {
    // 直接解析 RawQuery,保留标准库返回的格式错误
    values, err := url.ParseQuery(r.URL.RawQuery)
    if err != nil {
        return ListQuery{}, fmt.Errorf("解析查询字符串: %w", err)
    }

    // 多值参数读取完整切片,并限制可接受的数量
    tags := values["tag"]
    if len(tags) > 20 {
        return ListQuery{}, fmt.Errorf("tag 最多允许 20 个")
    }

    // 单值参数通过 one 拒绝重复键
    pageText, err := one(values, "page")
    if err != nil {
        return ListQuery{}, err
    }
    page, err := strconv.Atoi(pageText)
    if err != nil || page
这个边界把三类问题分开处理:ParseQuery 负责 URL 编码格式;参数读取层负责单值或多值约束;业务校验负责数量、类型和范围。不要把它们全部塞进一次 Get 调用里。
| 场景 | 推荐读取方式 | 错误策略 |
|---|---|---|
| 标签、字段列表、批量 ID | values[key] | 限制数量、长度并逐项校验 |
| 页码、排序方向、单个游标 | 先检查切片长度,再取值 | 重复出现时按接口约定拒绝或明确取值 |
| 未编码分号或错误转义 | 直接检查 ParseQuery 的错误 | HTTP 接口通常返回 400 |
| 分号属于值本身 | 客户端发送 %3B | 不要在服务端猜测并替换 |
兼容处理和安全注意
如果旧客户端长期把分号当作分隔符,最稳妥的兼容方式是在客户端或独立迁移层修正编码,并为旧协议设置明确下线时间。核心业务接口继续只接受标准的 & 分隔。不要在同一个解析器里同时猜测两套语义。
重复参数也不应被当作无成本输入。即使标准库负责解码,应用仍要限制每个键的值数量、单值长度以及整个请求目标的大小。对于影响缓存键、签名、鉴权或数据库查询的参数,还要确保网关、应用和下游服务使用相同的首值、末值或拒绝策略。
常见边界与排查清单
Get 为什么只有一个值?
Values.Get 的契约就是返回该键关联的第一个值。需要多个值时必须直接访问 map。它不是“随机选一个”,也不会返回最后一个。
返回 error 后 values 能继续用吗?
技术上可以,因为它包含已解析成功的参数;业务上是否使用要由调用方决定。HTTP API 更适合严格拒绝,离线清洗才适合把它作为带警告的部分结果。
空字符串怎么区分缺失参数?
Get 对“键不存在”和“第一个值为空”都返回空字符串。使用 Has 或 map 的双返回值判断键是否存在,再检查切片内容。
分号编码后为什么不会报错?
%3B 是值内部字符的百分号编码,不再是查询字符串中的原始分号。ParseQuery 先按 & 划分设置,再对键和值做解码,因此能够把它还原成普通数据。
重新输出查询字符串用什么?
修改 url.Values 后调用 Encode。它会正确转义键和值,并为多个值重复输出键。不要手工拼接 &、= 和百分号转义。
把格式错误和业务规则分开
url.ParseQuery 的能力边界很清楚:它把查询字符串解码成多值 map,并报告格式错误;它不会替你决定某个键能否重复,也不会决定部分结果是否可以继续使用。把重复值策略、分号编码规则和错误处理策略分别写清楚,HTTP 接口在网关、应用和下游之间才会保持一致。
-
860 收藏
-
843 收藏
-
826 收藏
-
809 收藏
-
792 收藏
-
408 收藏
-
435 收藏
-
153 收藏
-
274 收藏
-
227 收藏
-
422 收藏
-
202 收藏
-
389 收藏
-
241 收藏
-
288 收藏
-
413 收藏
-
447 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习