
Redis Vector Sets 存储相似度结果的查询组织
来源:17golang原创
时间:2026-10-02 21:57:42 449浏览 收藏
Redis Vector Sets 适合把“向量相似度”和“可筛选属性”放进同一个查询边界:先用 VADD 让每个元素拥有固定维度的向量,再用 VSIM 按查询向量或已有元素检索,最后用 COUNT、WITHSCORES 和 FILTER 控制结果形态。真正需要先设计的不是一条命令,而是 key、维度、元素标识和属性字段这四个输入契约。
官方地址:https://redis.io/docs/latest/
- Vector Set 的维度一旦确定,后续写入和查询都要保持一致。
VSIM只负责相似度排序,FILTER负责按元素属性缩小候选。- 低召回先检查
EF、量化和属性类型,不要只把COUNT调大。
先固定向量集合的输入契约
把一条内容、商品或记忆看成一个元素,把 embedding 看成它的向量,把年份、评分、租户等可检索字段放在属性里。示例只用二维数字,方便看清数据关系;真实文本 embedding 往往有更多维度。
# 用 VALUES 写入两个二维元素;元素名是业务侧稳定的结果标识
VADD points VALUES 2 1.0 1.0 pt:A
VADD points VALUES 2 -1.0 -1.0 pt:B

# 先确认对象类型、成员数量和向量维度
TYPE points
VCARD points
VDIM points
这里的 points 是 Vector Set key,2 是维度,pt:A 是元素名。生产环境不要把会变化的展示标题直接当元素名,否则更新和回溯都会变得困难。写入后至少记录三项检查:类型应为 vectorset,数量应与有效元素数一致,维度应与 embedding 模型契约一致。
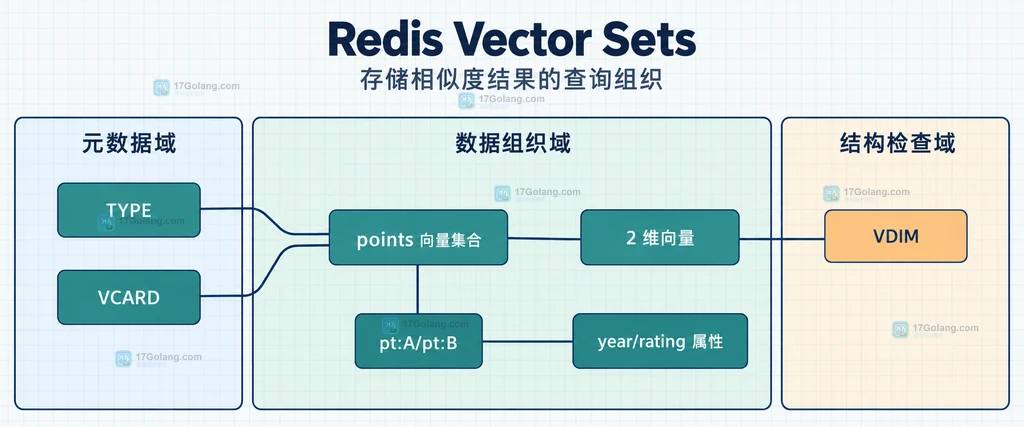
用 VADD 和属性组织相似度对象
只做相似度检索时,向量和元素名已经够用;需要按年份、评分或类型过滤时,再给元素附加顶层 JSON 属性。属性可以在写入时用 SETATTR 设置,也可以用 VSETATTR 后补。
# 写入时绑定简单属性;字段类型要和之后的过滤表达式一致
VADD movies VALUES 3 0.5 0.8 0.2 movie:1 SETATTR '{"year": 2022, "rating": 8.4}'

# 后续修改属性,不改变元素标识
VSETATTR movies movie:1 '{"year": 2023, "rating": 8.6}'

# 排查过滤没有命中时,先把实际属性取出来
VGETATTR movies movie:1
year 和 rating 应保存为数值,而不是带引号的字符串;否则 .rating > 8 这类表达式可能因类型不匹配而排除元素。属性字段尽量保持扁平,既便于过滤,也避免把大段业务文档复制到每个向量元素中。
用 VSIM 组合结果数量与分数
VSIM 有两种常用输入:VALUES 后跟查询向量,或 ELE 后跟集合中已有的元素名。前者适合外部模型刚产生一个 embedding 的场景,后者适合“找和某条内容相似的内容”。
# 以查询向量检索,限制返回 3 个元素
VSIM movies VALUES 3 0.5 0.8 0.2 COUNT 3

# 以已有元素 movie:1 为参照,并返回元素名与相似度分数
VSIM movies ELE movie:1 COUNT 3 WITHSCORES
默认只关心元素名时,不要无条件打开 WITHSCORES;需要二次排序、阈值判断或解释推荐结果时再返回分数。COUNT 是结果数量上限,不是召回质量开关;如果结果不理想,优先查向量维度、量化和搜索参数。
把属性过滤放到查询边界
Vector Set 的价值在于可以在相似度查询里同时表达简单的标量条件。例如只返回 2020 年以后、评分超过 8 的元素:
# FILTER 只读取元素属性;FILTER-EF 控制为满足过滤而检查的候选范围
VSIM movies VALUES 3 0.5 0.8 0.2 COUNT 5 \
  FILTER '.year >= 2020 and .rating > 8' FILTER-EF 500
过滤表达式使用点号访问顶层字段,支持比较、逻辑运算和 in。缺少字段、JSON 无效或字段类型不匹配时,元素会被静默跳过;因此“结果为空”不一定是向量相似度没有命中,也可能是属性条件把候选排光了。条件很稀疏时可以提高 FILTER-EF,代价是检查更多候选;不要把它当成固定推荐值。
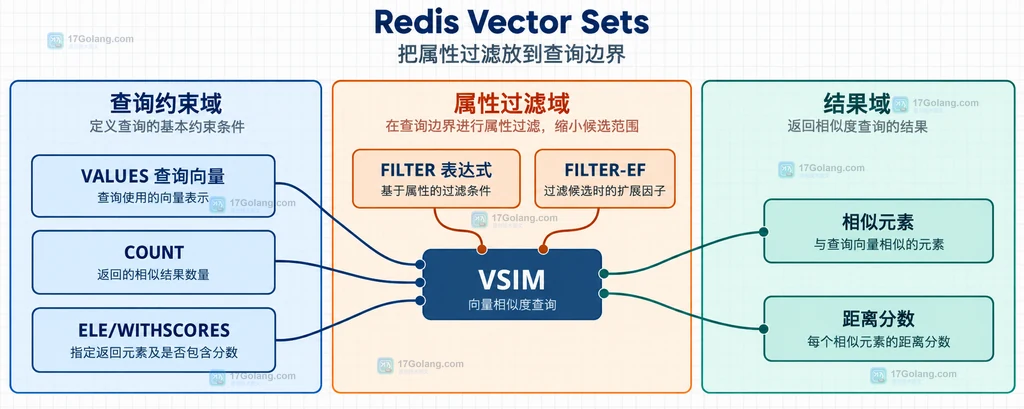
按规模与精度要求收敛方案
出现低召回时,先用较高的 EF 做对照,再检查量化模式;官方文档还提供 TRUTH 作为线性扫描对照,但它更慢,适合验证而不是常态查询。出现内存上涨时,重点看向量维度、量化方式、图连接参数 M 和属性 JSON 大小。
| 现象 | 优先检查 | 处理边界 |
|---|---|---|
| 结果数量少 | 维度、FILTER 字段、FILTER-EF | 先确认属性没有缺失或类型错误 |
| 召回不稳定 | EF、量化模式 | 用 TRUTH 做小规模对照 |
| 内存偏高 | 向量精度、M、属性体积 | 优先压缩属性并评估量化 |
这套组织方式的边界也很明确:Vector Set 解决的是向量相似度与轻量属性过滤,不等于把复杂全文检索、深层 JSON 查询和业务主数据都塞进同一个 key。元素名负责稳定关联,属性负责轻量筛选,业务详情仍可放在独立的数据结构中。
相关问题
为什么 VSIM 返回的元素比 COUNT 少?
先检查过滤条件、属性是否缺失以及 FILTER-EF。如果没有过滤,再确认集合中实际成员数和查询向量维度。
什么时候使用 ELE 而不是 VALUES?
已有集合元素作为参照时用 ELE;查询向量来自集合外的 embedding 服务时用 VALUES。
FILTER-EF 越大越好吗?
不是。它可能提高稀疏条件下找到足够结果的机会,但会增加候选检查成本,应按召回率和延迟压测后决定。
-
117 收藏
-
426 收藏
-
171 收藏
-
113 收藏
-
195 收藏
-
270 收藏
-
468 收藏
-
394 收藏
-
386 收藏
-
357 收藏
-
101 收藏
-
145 收藏
-
351 收藏
-
460 收藏
-
471 收藏
-
413 收藏
-
327 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习