
Java Stream Gatherer 与 Collector 的职责对比
来源:17golang原创
时间:2026-10-04 00:48:42 205浏览 收藏
Java Stream 的 Gatherer 与 Collector 都有状态创建、元素处理、合并和收尾函数,但职责并不重叠:Gatherer 是自定义中间操作的扩展点,负责把输入流转换成还能继续组合的新流;Collector 是终端可变归约策略,负责结束流水线并返回一个最终结果。如果任务是滑动窗口、固定分批、前缀扫描、带状态的多对多转换或短路,先看 Gatherer;如果任务是分组、汇总、拼接、收集到集合或生成最终报表,先看 Collector。
判断时不要先比较四个函数名,而要先问一句:处理后还要不要继续写map、filter或其他中间操作?要继续,Gatherer 更接近问题;流水线到这里就结束并交付结果,Collector 更自然。
Java SE 26 Gatherer API:https://docs.oracle.com/en/java/javase/26/docs/api/java.base/java/util/stream/Gatherer.html
Java SE 26 Collector API:https://docs.oracle.com/en/java/javase/26/docs/api/java.base/java/util/stream/Collector.html
我一开始为什么容易把它们混在一起
第一次认真看 Gatherer 接口时,我很自然地把它理解成“功能更强的 Collector”:二者都有中间状态、combiner 和 finisher,甚至 Gatherers.fold 也能把多个输入折叠成一个输出。真正把两者分开后,心智模型反而简单了——Collector 解决“怎样得到最终值”,Gatherer 解决“怎样定义一种新的流变换”。
Oracle 的 Java SE 26 文档把 Stream.gather 定义为有状态中间操作扩展点;Stream.collect 则是终端操作。Gatherer 及内置 Gatherers API 标注自 Java 24 起提供。它带来的趋势并不是淘汰 Collector,而是让过去需要手写迭代器、外部库或复杂 flatMap 的中间变换有了标准扩展位置。
先分清扩展点所在位置
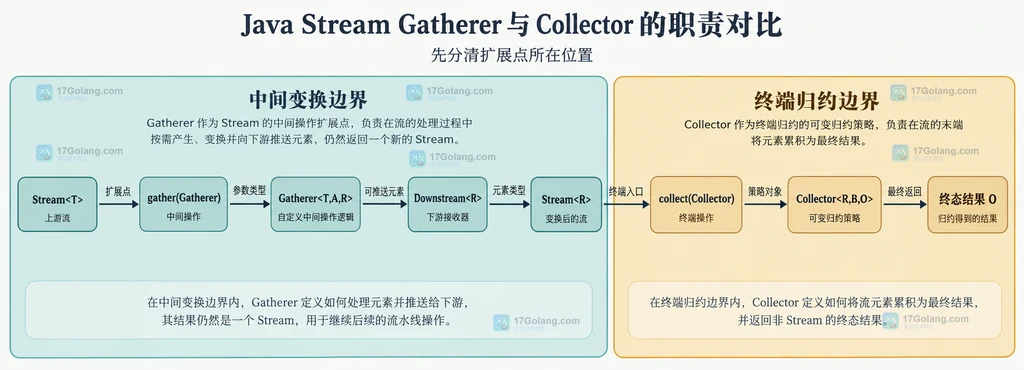
Gatherer 的类型可以读成 Gatherer:消费 T,可维护状态 A,并向 Downstream 推送零个、一个或多个 R。调用 stream.gather(gatherer) 后得到的仍是 Stream,因此后面还能继续过滤、映射、限流或收集。
Collector 的 Collector 也有输入 T、中间容器 A 和结果 R,但 stream.collect(collector) 直接返回 R。它不再把元素送回流,而是完成一次可变归约。
| 比较项 | Gatherer | Collector |
|---|---|---|
| 操作位置 | 中间操作 | 终端操作 |
| 主要产物 | 零个到多个下游元素,形成新 Stream | 一个最终结果 R |
| 典型任务 | 窗口、扫描、带状态转换、短路、受控并发映射 | 分组、汇总、拼接、集合化、统计 |
| 后续组合 | 可以继续 map/filter/limit/collect | 流水线已经结束 |
| 状态合并 | 提供 combiner 才可并行化;默认 combiner 表示仅顺序求值 | combiner 合并分区容器,并受恒等性和结合性约束 |
| 短路能力 | integrator 可返回 false,通知不再接收输入 | 通常消费完整输入后产生终态结果 |
四组函数相似,输出契约却不同
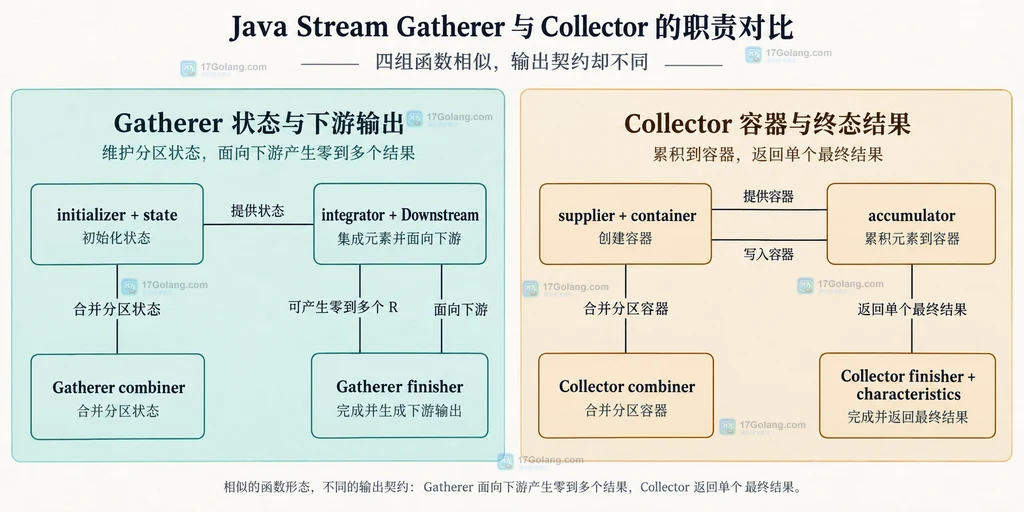
Gatherer 由 initializer、integrator、combiner 和 finisher 描述。这里最关键的是 integrator:它既能读写状态,也能调用 downstream.push(...) 发出元素;返回 false 时还可以表达短路。finisher 同样面对 Downstream,所以结束输入时仍可补发结果。
Collector 则由 supplier 创建可变容器,accumulator 把元素写入容器,combiner 合并分区容器,finisher 把容器转换为最终结果。characteristics 还能声明并发、无序或恒等收尾等性质。Collector 的这些函数围绕“完成归约”协作,不负责在流水线中间持续输出元素。
固定窗口为什么更像 Gatherer
假设订单金额需要每三条组成一批,再对每批求和。这里的中间产物不是一个最终总额,而是多个窗口;窗口出来后还要继续 map。内置 Gatherers.windowFixed(3) 正好表达这个职责。官方文档还明确说明:最后一个窗口可以少于指定大小,产生的窗口列表不可修改。
import java.util.List;
import java.util.stream.Gatherers;
import java.util.stream.Stream;

public class GathererWindowDemo {
    public static void main(String[] args) {
        List batchTotals = Stream.of(10, 20, 30, 40, 50)
                // Gatherer 先把连续元素转换成固定窗口,最后一组可以不足 3 条
                .gather(Gatherers.windowFixed(3))
                // 窗口仍在流中,因此还能继续映射成每批合计
                .map(batch -> batch.stream()
                        .mapToInt(Integer::intValue)
                        .sum())
                // 这里才使用终端操作,把多个批次结果收成列表
                .toList();

        // 逻辑结果为 [60, 90]:第二个窗口包含 40 和 50
        System.out.println(batchTotals);
    }
}
这个例子让我觉得 Gatherer 最有价值的地方不是“能写复杂状态”,而是中间形态有了名字。窗口是窗口,前缀扫描是前缀扫描,受控并发映射也有 mapConcurrent;调用方不必把它们伪装成一个最终收集动作。
分组汇总为什么仍应交给 Collector
如果目标是按城市计算订单总额,并把 Map 直接交给报表层,流水线已经到终点。此时使用 Collectors.groupingBy 配合下游 summingInt,比先 Gatherer 再转 Map 更直白,也更容易让维护者一眼看出结果类型。
import java.util.List;
import java.util.Map;
import java.util.stream.Collectors;

public class CollectorSummaryDemo {
    record Order(String city, int amount) {}

    public static void main(String[] args) {
        List orders = List.of(
                new Order("杭州", 120),
                new Order("上海", 90),
                new Order("杭州", 80));

        Map amountByCity = orders.stream()
                // Collector 在终端阶段完成分组,并把金额累加到最终 Map
                .collect(Collectors.groupingBy(
                        Order::city,
                        Collectors.summingInt(Order::amount)));

        // 逻辑结果包含杭州 200、上海 90;流水线在 collect 处结束
        System.out.println(amountByCity);
    }
}
Collector 的并行语义也更严格:为了让顺序和并行归约等价,supplier、accumulator、combiner 和 finisher 需要满足文档规定的恒等性与结合性约束。仅仅“写了一个 combiner”并不意味着并行一定更快;例如合并大型 Map 的代价可能抵消分区收益。
重叠地带怎么选:fold、reduce 与 collect
Gatherers.fold 确实能把输入折叠成单个元素,所以它和 reduce、Collector 有重叠感。我的取舍是看单个元素之后是否仍有流式组合价值:
- 折叠后还要继续
filter、与另一个 Gatherer 组合,或把结果留在统一的中间操作链里,可以考虑Gatherers.fold。 - 只需要不可变值,累加函数满足结合性,而且没有可变容器需求,优先
reduce。 - 要构建 List、Map、统计对象或复杂可变容器,优先 Collector。
换句话说,Gatherer 能完成 reduction-like transformation,不等于所有归约都应该迁移到 Gatherer。API 的能力范围与日常代码的最佳表达不是一回事。
采用 Gatherer 前要接受的代价
Gatherer API 自 Java 24 起提供,因此项目基线低于 Java 24 时不能直接使用。即使版本满足,我也不会把已有的 map、filter、distinct 或简单 Collector 全部改写成自定义 Gatherer:标准操作更熟悉,调试成本也更低。
并行方面要尤其保守。没有自定义 combiner 的 Gatherer 只能顺序求值;提供 combiner 后,状态合并必须具有正确语义。Collector 同样不能因为看到 parallelStream 就默认获益。先用真实数据量和真实合并成本测量,再决定是否并行,通常比围绕接口做理论优化可靠。
一张选型清单
- 需要继续流水线:选择 Gatherer,尤其是窗口、扫描、带状态转换和短路。
- 需要一个最终容器或统计值:选择 Collector。
- 只是普通一对一或条件过滤:继续使用 map、filter 等内置操作,不要过度抽象。
- 需要顺序相关状态:优先顺序 Gatherer,明确不要假装可并行。
- 需要并行:分别检查 Gatherer 的状态 combiner 或 Collector 的结合性、恒等性与 characteristics,再做基准测试。
- 团队基线低于 Java 24:不要为了一个局部窗口操作抬高整个项目版本,先评估普通循环或现有库。
常见问题
Gatherer 会替代 Collector 吗?
不会。二者是不同位置的扩展点:Gatherer 扩展中间变换,Collector 定义终端归约。很多流水线会先 gather,再用 collect 或 toList 结束。
Gatherer 一定是有状态的吗?
不一定。Gatherer 可以无状态,也可以有状态;它的 initializer、combiner 和 finisher 都有默认形式。是否维护状态取决于变换本身。
为什么 Gatherer 能短路而 Collector 通常不能?
Gatherer 的 integrator 返回布尔值,返回 false 可以表示不再接收更多上游元素;Collector 的 accumulator 面向完成终端归约,没有同样的逐元素短路契约。
固定窗口之后应该用 toList 还是 Collector?
如果只是把窗口结果放入列表,直接 toList() 最简洁;如果需要分组、统计或自定义终态容器,再使用合适的 Collector。
-
文章 · java教程 | 3星期前 | Java · 异常处理 · 资源管理 · java try-with-resources AutoCloseable close suppressed exception501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
367 收藏
-
190 收藏
-
488 收藏
-
183 收藏
-
301 收藏
-
100 收藏
-
236 收藏
-
380 收藏
-
139 收藏
-
495 收藏
-
244 收藏
-
361 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习