
Python csv.DictReader 怎么接收多余字段
来源:17golang原创
时间:2026-10-04 08:19:57 171浏览 收藏
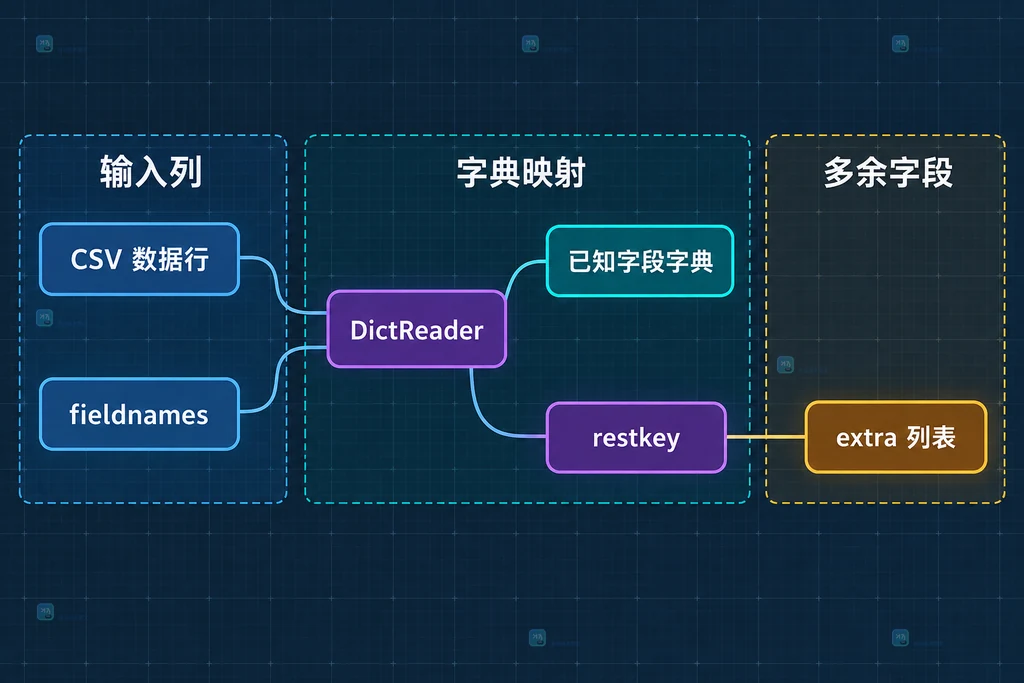
Python 的 csv.DictReader 可以用 restkey 接收一行中超出 fieldnames 数量的值。多出来的值会组成一个列表,存入 restkey 指定的字典键;如果不传该参数,默认键是 None。生产代码建议显式写成 restkey="_extra",读取后用 row.pop("_extra", []) 取出并按策略保留、告警或拒绝。
官方文档:https://docs.python.org/3/library/csv.html
restkey 的最小可用写法
假设表头只有 order_id,amount,currency,某一行却多出两个单元格。下面的写法会把前三个值映射到普通字段,把剩余两个值放进 _extra 列表。
import csv

with open("orders.csv", "r", encoding="utf-8", newline="") as file:
    # restkey 接收超出表头数量的行尾值,结果始终是列表
    reader = csv.DictReader(file, restkey="_extra")

    for row in reader:
        # 正常行没有 _extra 键,因此使用空列表作为默认值
        extra_values = row.pop("_extra", [])
        print(row, extra_values)
官方文档还建议打开 CSV 文件时使用 newline="",让 csv 模块自己处理换行。DictReader 返回的普通字段值默认仍是字符串,不会因为看起来像金额或整数就自动完成业务类型转换。
为什么不建议保留默认的 None 键
不传 restkey 时,多余值会放到 row[None]。它在临时脚本里能用,但进入 JSON、数据库字段映射、日志序列化或类型标注后很容易被忽略。显式键名能让数据契约更清楚,也便于静态检查。
import csv

with open("orders.csv", "r", encoding="utf-8", newline="") as file:
    # 默认 restkey=None,多余值会挂在 None 这个键上
    reader = csv.DictReader(file)
    for row in reader:
        extra_values = row.get(None, [])
        # 业务处理前应把非字符串键移出正常记录
        row.pop(None, None)
        print(row, extra_values)
自定义键也不能随便取。若真实表头本来就有 _extra 列,行尾溢出会与业务字段争用同一个键。比较稳妥的做法是选一个保留名,例如 __overflow__,并在读取表头后确认它不在 reader.fieldnames 中。
多余表头和多余行值不是同一个问题
restkey 只处理“某一行的值数量超过 fieldnames 数量”。如果没有显式传 fieldnames,DictReader 会把文件第一行当作字段名;表头新增的列会成为正常字典键,不会进入 restkey。因此,企业导入接口通常要同时检查两层:
- 未知表头:实际表头中存在契约未定义的列名;
- 行尾溢出:某一数据行的单元格数量比实际表头还多。
import csv

EXPECTED_FIELDS = ("order_id", "amount", "currency")
OVERFLOW_KEY = "__overflow__"

with open("orders.csv", "r", encoding="utf-8", newline="") as file:
    reader = csv.DictReader(
        file,
        restkey=OVERFLOW_KEY,
        restval=None,
    )

    # 访问 fieldnames 会初始化并读取文件表头
    actual_fields = reader.fieldnames or []
    unknown_headers = [
        name for name in actual_fields if name not in EXPECTED_FIELDS
    ]

    # 保留名不得与真实列名冲突,否则溢出列表会覆盖业务含义
    if OVERFLOW_KEY in actual_fields:
        raise ValueError(f"reserved header is not allowed: {OVERFLOW_KEY}")

    for row in reader:
        overflow = row.pop(OVERFLOW_KEY, [])
        print(unknown_headers, overflow, row)
还有一个边界需要单独检查:重复表头。字典无法同时保留两个同名键,后出现的值可能覆盖前一个值。restkey 不负责解决重复列名,所以在正式导入前应检查 len(fieldnames) == len(set(fieldnames))。
用 restval 区分缺失字段
多余字段和缺失字段方向相反。某行值少于 fieldnames 时,DictReader 会用 restval 填充缺失键,默认也是 None。建议把二者分开记录:restkey 保存额外值,restval 标记缺失值。
import csv

MISSING = "__MISSING__"

with open("orders.csv", "r", encoding="utf-8", newline="") as file:
    reader = csv.DictReader(
        file,
        restkey="__overflow__",
        restval=MISSING,
    )

    for row in reader:
        # 多余值与缺失值分别判断,避免把两个问题混成一类
        overflow = row.pop("__overflow__", [])
        missing_fields = [
            key for key, value in row.items() if value == MISSING
        ]
        print(overflow, missing_fields)
如果空字符串本身是合法业务值,不要用空字符串充当缺失标记。独立哨兵字符串适合简单脚本;更严格的系统可以在规范化前保留原始行,并把缺失字段列表放入单独的审计对象。
封装宽松模式和严格模式
是否允许多余字段不是 csv 模块能替你决定的业务规则。兼容第三方供应商时,可以宽松接收并记录;财务、结算或固定接口导入时,通常应在发现未知表头或行尾溢出后拒绝该批次。
from dataclasses import dataclass
from typing import Any


@dataclass(frozen=True)
class ParsedRow:
    line_num: int
    record: dict[str, Any]
    extra_values: list[str]
    issues: list[str]


def normalize_row(
    row: dict[str | None, Any],
    *,
    line_num: int,
    expected_fields: tuple[str, ...],
    unknown_headers: list[str],
    overflow_key: str = "__overflow__",
    strict: bool = False,
) -> ParsedRow:
    # 先复制,避免修改 DictReader 返回给其他处理器的原始对象
    working = dict(row)
    overflow = list(working.pop(overflow_key, []) or [])

    # 只输出契约字段,未知表头值保留在审计信息中
    record = {name: working.get(name) for name in expected_fields}
    issues: list[str] = []

    if unknown_headers:
        issues.append(f"unknown headers: {unknown_headers}")
    if overflow:
        issues.append(f"overflow values: {overflow}")

    # 严格模式在边界层拒绝,宽松模式继续返回带问题的记录
    if strict and issues:
        raise ValueError(f"line {line_num}: {'; '.join(issues)}")

    return ParsedRow(line_num, record, overflow, issues)
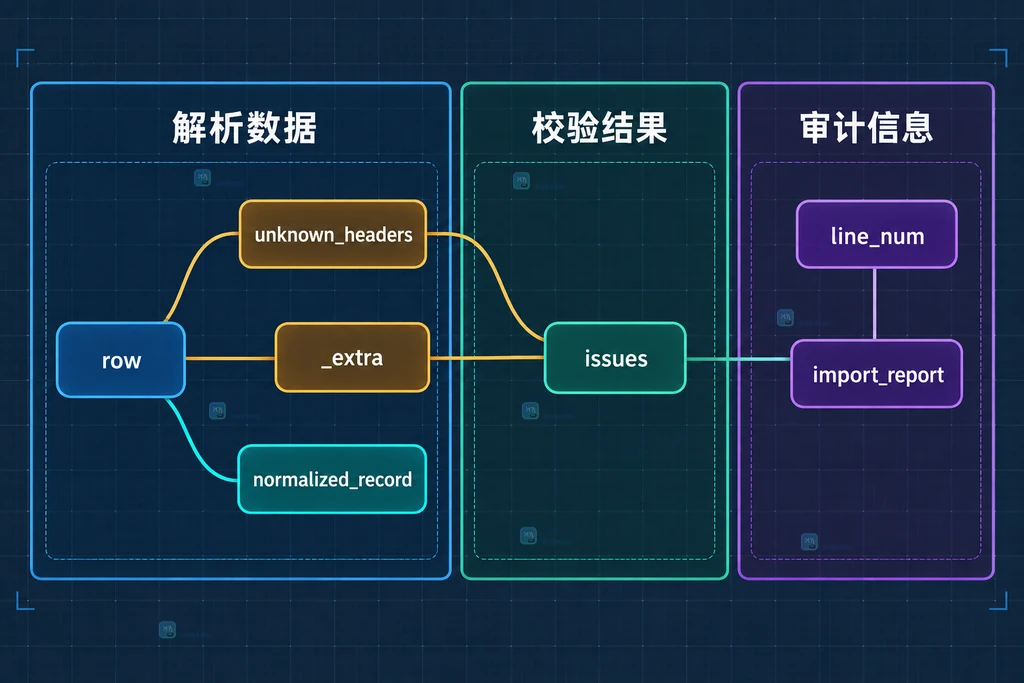
这个封装没有把多余值直接塞进业务记录,因为“未知数据”与“已认可字段”应有不同权限边界。即使采用宽松模式,也建议只把规范字段交给后续数据库写入,把原始额外值留在受控审计记录中。
把多余字段纳入导入审计
DictReader 提供 line_num 属性。它表示读取源中已经处理的行数,记录可能跨多行,所以它不一定等于返回记录的序号,但仍然是定位源文件问题的重要信息。导入报告至少应保存文件标识、line_num、未知表头、行尾多余值和处理策略。
import csv
from pathlib import Path


def inspect_csv(path: Path, *, strict: bool = False) -> list[ParsedRow]:
    expected = ("order_id", "amount", "currency")
    overflow_key = "__overflow__"
    results: list[ParsedRow] = []

    with path.open("r", encoding="utf-8", newline="") as file:
        reader = csv.DictReader(
            file,
            restkey=overflow_key,
            restval=None,
        )
        headers = reader.fieldnames or []

        # 导入前先拒绝重复表头与保留键冲突
        if len(headers) != len(set(headers)):
            raise ValueError("duplicate CSV headers")
        if overflow_key in headers:
            raise ValueError("reserved overflow header")

        unknown_headers = [
            name for name in headers if name not in expected
        ]

        for row in reader:
            # line_num 来自解析器,便于审计文件中的原始位置
            results.append(
                normalize_row(
                    row,
                    line_num=reader.line_num,
                    expected_fields=expected,
                    unknown_headers=unknown_headers,
                    overflow_key=overflow_key,
                    strict=strict,
                )
            )

    return results
上线前的检查清单
| 检查项 | 推荐规则 | 失败处理 |
|---|---|---|
| 文件打开方式 | encoding 明确,newline="" | 拒绝无法解码或无法解析的文件 |
| 表头唯一性 | 不允许重复字段名 | 整批拒绝并报告重复项 |
| 保留键 | restkey 不得出现在真实表头 | 整批拒绝,避免键覆盖 |
| 未知表头 | 宽松记录或严格拒绝 | 按接口版本策略处理 |
| 行尾溢出 | 保留 extra 列表与 line_num | 告警、隔离或拒绝该行 |
| 缺失字段 | 使用 restval 后做必填校验 | 不要与空字符串混淆 |
| 类型转换 | 在规范化层显式完成 | 记录字段名和原始值 |
最小脚本只需要 restkey="_extra"。真正稳定的导入接口还要把表头契约、缺失字段、严格模式和审计信息一起定下来;否则“已经接收多余字段”很容易变成“悄悄吞掉不认识的数据”。
常见问题
为什么我设置 restkey 后始终没有这个键?
只有某一行的值数量超过 fieldnames 数量时,restkey 键才会出现。正常行应使用 row.get(key, []) 或 row.pop(key, [])。
文件新增了一列表头,为什么没有进入 restkey?
因为省略 fieldnames 时,第一行会被当作完整表头,新增列自然成为普通字典键。请另外比较 reader.fieldnames 与预期字段集合。
restkey 和 DictWriter 的 extrasaction 是同一个功能吗?
不是。restkey 处理读取时一行中超过 fieldnames 的值;DictWriter.extrasaction 处理写出时字典包含未列入 fieldnames 的键。
多余值会自动转换类型吗?
默认不会。它们与普通字段一样以字符串形式读入。金额、日期、布尔值等应在规范化层显式转换并记录失败原因。
-
361 收藏
-
346 收藏
-
235 收藏
-
251 收藏
-
407 收藏
-
410 收藏
-
403 收藏
-
236 收藏
-
218 收藏
-
108 收藏
-
文章 · python教程 | 2天前 | 日志 · logging · Python教程 · Python contextvars request_id LogRecord logging.Filter410 收藏
-
351 收藏
-
246 收藏
-
259 收藏
-
279 收藏
-
144 收藏
-
373 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习