
Go csv.Reader.LazyQuotes 会接受哪些非标准引号
来源:17golang原创
时间:2026-10-04 13:16:46 486浏览 收藏
Go 的 encoding/csv 默认按 RFC 4180 风格解析:非引号字段里出现裸双引号,通常会得到 ErrBareQuote;引号字段中的引号没有按规则闭合,也会得到解析错误。把 Reader.LazyQuotes 设为 true 后,解析器会接受两类不规范输入,但它不是“忽略所有 CSV 语法”:逗号仍然分隔字段,换行仍然结束记录,字段数量也仍可校验。
- 非引号字段中的双引号会按普通字符保留。
- 引号字段中的非成对双引号会按字段内容保留,成对双引号仍表示一个双引号。
- 宽松解析要和
FieldsPerRecord、ParseError及隔离日志一起使用,不能把容错当成数据清洗。
Go csv.Reader.LazyQuotes 先放宽了哪两类引号
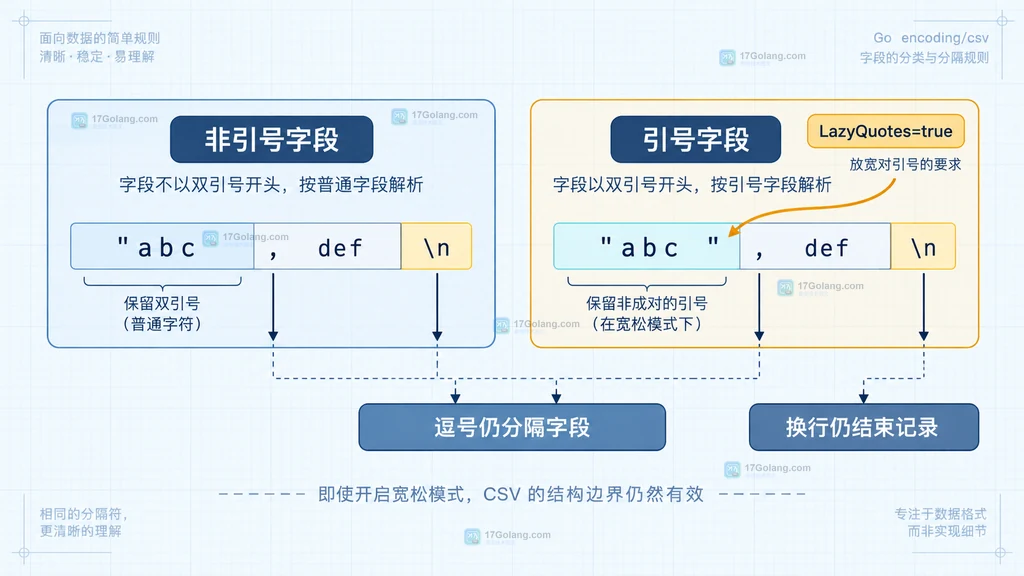
判断边界时先看字段的第一个字符。字段不是以双引号开头时,Reader 会把它当作非引号字段;默认模式会检查字段内部是否存在双引号,LazyQuotes=true 则跳过这项检查,像 alpha"beta 这样的值仍保留在同一个字段里。
字段以双引号开头时,Reader 进入引号字段分支。标准写法是用两个连续双引号表示内容中的一个双引号;开启 LazyQuotes 后,如果遇到没有成对、且后面不是逗号或换行的裸双引号,Reader 会把这个双引号也当作字段内容。文件末尾缺少闭合双引号时,宽松模式也可能完成当前字段。
需要记住的限制是:LazyQuotes 不会改变分隔符规则。非引号字段中的逗号仍会切开字段,换行仍会结束记录;引号字段中的逗号和换行仍可作为字段内容。下面这张图只表达解析关系,不是运行截图。
用最小示例区分“接受”与“仍然分隔”
下面的输入故意包含三种脏数据:普通字段里的双引号、引号字段里没有成对的双引号,以及没有闭合的引号字段。示例把字段数固定为 2,避免宽松引号掩盖列数漂移。
package main

import (
    "encoding/csv"
    "fmt"
    "io"
    "strings"
)

func main() {
    input := "name,note\n" +
        "alpha,a\"b\n" +
        "beta,\"c\"d\n" +
        "gamma,\"unterminated\n"

    reader := csv.NewReader(strings.NewReader(input))
    reader.LazyQuotes = true       // 允许字段中出现未按标准成对的双引号
    reader.FieldsPerRecord = 2     // 保持每条记录的列数约束

    for {
        record, err := reader.Read()
        if err == io.EOF {
            break // 正常读完,不把 EOF 当成业务错误
        }
        if err != nil {
            fmt.Printf("读取失败:%v\n", err) // 生产环境应记录行列并隔离原始记录
            continue
        }
        fmt.Printf("字段=%q\n", record) // 双引号已经成为字段内容的一部分
    }
}
这个例子中,a"b 的双引号不会再触发 ErrBareQuote;"c"d 中的非成对双引号会被保留;末尾未闭合的引号字段也会被宽松接受。它们都没有额外制造列。相反,如果把某行写成 alpha,a"b,c,逗号仍会产生第三列,随后可能触发 ErrFieldCount。
| 输入位置 | 默认模式 | LazyQuotes=true | 仍需注意 |
|---|---|---|---|
| 非引号字段内部 | ErrBareQuote | 保留双引号 | 逗号仍分列 |
| 引号字段内非成对双引号 | ErrQuote | 保留双引号 | 成对双引号仍是一个引号 |
| 引号字段缺少闭合 | 解析错误 | 可被接受 | 必须评估脏数据风险 |
把容错范围锁在可审计的导入入口
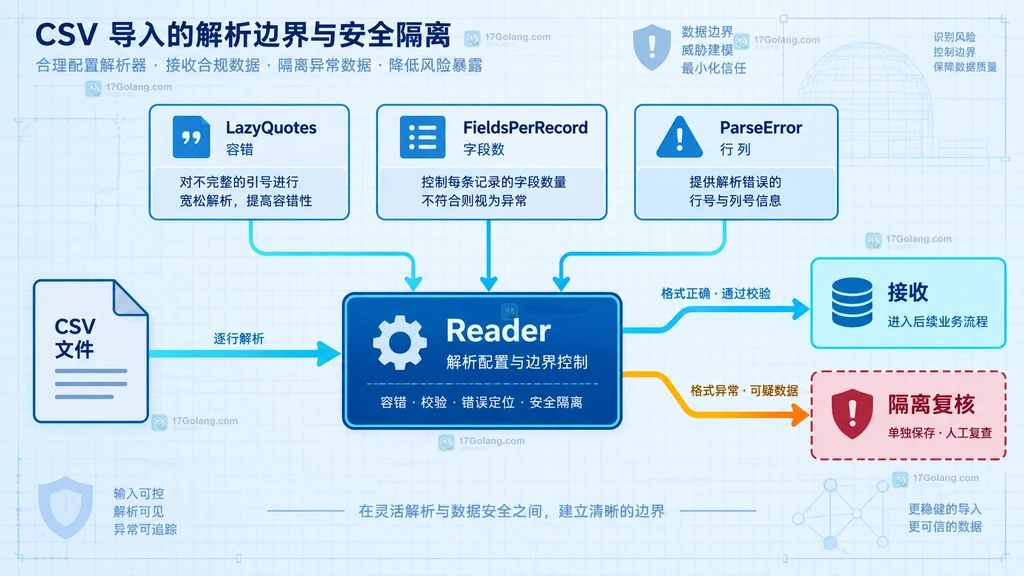
LazyQuotes 适合兼容历史导出文件,不适合无条件吞掉所有输入错误。入口层可以固定列数,并在不能接受的记录上保存行号、列号和原始批次标识。若业务仍需要区分“解析容错”和“列数异常”,不要只判断 err != nil,而应通过 errors.As 识别 *csv.ParseError,再把异常送到隔离队列。
安全边界可以概括为:LazyQuotes 负责“允许某些引号形态”,FieldsPerRecord 负责“列数不能漂移”,ParseError 负责“失败位置可定位”,业务规则负责“这条数据是否真的能入库”。四者缺一时,宽松解析都可能把后续问题推迟到更难排查的环节。
相关问题
LazyQuotes 会忽略 CSV 中的逗号吗?
不会。逗号仍按 Reader.Comma 作为字段分隔符;只有处于合法引号字段内部时,逗号才属于字段内容。
为什么开启 LazyQuotes 后列数仍然报错?
因为 LazyQuotes 只处理引号容错,不关闭 FieldsPerRecord。检查输入中的逗号、分隔符设置和表头列数。
生产导入应该默认开启 LazyQuotes 吗?
不建议默认开启。只有在确认上游文件存在稳定的历史引号问题,并且配套隔离、审计和回放机制时,才在专门入口启用。
怎么定位仍然失败的引号记录?
保留 *csv.ParseError 的行列信息和输入批次标识;不要只记录一段模糊的“CSV 解析失败”。
-
374 收藏
-
187 收藏
-
216 收藏
-
483 收藏
-
197 收藏
-
430 收藏
-
220 收藏
-
324 收藏
-
431 收藏
-
186 收藏
-
334 收藏
-
449 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习