
Go slog.LogAttrs 怎么减少日志属性分配
来源:17golang原创
时间:2026-10-05 02:03:02 180浏览 收藏
我第一次把一段高频请求日志从 Logger.Log 改成 Logger.LogAttrs 时,原以为只是把 "status", 200 换成 slog.Int("status", 200)。真正看过实现后才明白:它减少的是通用 ...any 参数解析与属性转换,不是给所有日志场景提供“零分配”保证。
实际可行的做法是:动态字段使用类型化 Attr,稳定字段提前放进 Logger.With,昂贵值放到 Enabled 判断之后,再用贴近真实 Handler 的基准测试看 allocs/op。这四件事一起做,通常比只替换方法名更有意义。
- 热点调用优先使用
LogAttrs和slog.String、slog.Int、slog.Duration等类型化构造器。 - 服务名、环境、组件等重复字段通过
Logger.With绑定一次。 - 日志级别被关闭时,
LogAttrs会尽早返回,但调用参数仍会先求值;昂贵属性要先检查Enabled。 - 属性数量、值类型、Handler 和输出缓冲都会影响最终分配,必须测自己的负载。
官方文档:https://pkg.go.dev/log/slog
LogAttrs 减少的是哪一层工作
Logger.Log 接收 args ...any。它既要接受交替出现的键和值,也要接受已经构造好的 Attr,还要处理缺键或缺值的错误形式。因此 Record 在接收参数时需要逐项判断:当前值是字符串键、Attr,还是没有键的普通值,然后再转换成 Attr。
Logger.LogAttrs 的参数类型直接是 ...slog.Attr。调用方已经把键、值和类型说清楚,Logger 可以直接把这些 Attr 加入 Record,省去通用参数的分支与转换。官方文档也把它定义为 Logger.Log 的更高效版本。
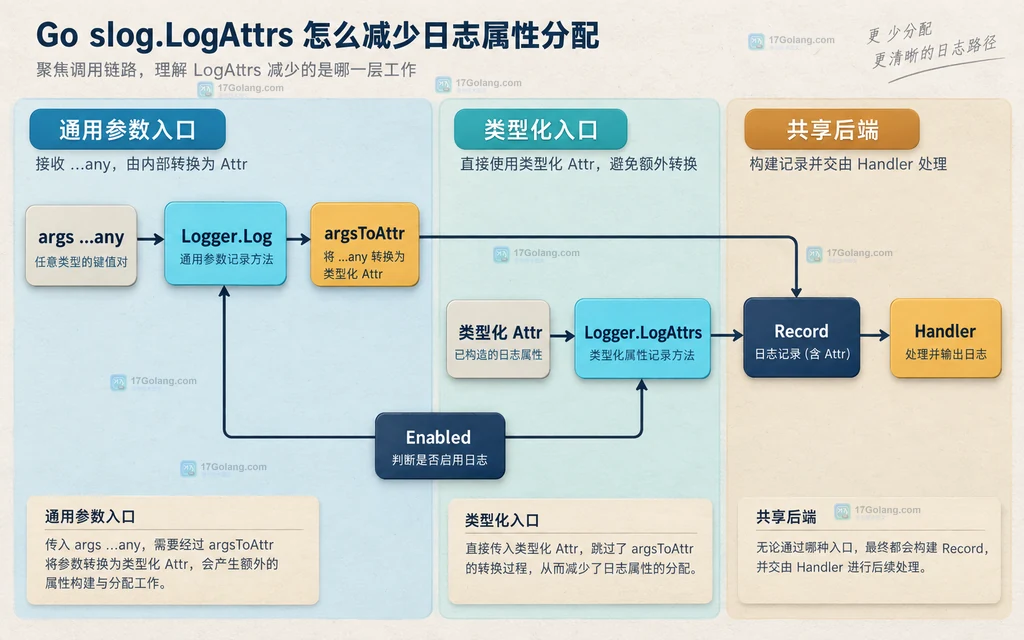
最小改写很直接:
package main

import (
	"context"
	"log/slog"
	"os"
	"time"
)

func main() {
	logger := slog.New(slog.NewJSONHandler(os.Stdout, nil))
	ctx := context.Background()

	// 类型化 Attr 让 Logger 无需解析交替键值参数。
	logger.LogAttrs(ctx, slog.LevelInfo, "request finished",
		slog.String("method", "GET"),
		slog.Int("status", 200),
		slog.Duration("elapsed", 18*time.Millisecond),
	)
}
这段写法还减少了把键和值写错位的机会。普通字符串、整数、布尔值、时间和时长都有专用构造器;遇到错误对象或业务结构体时再用 slog.Any。专用构造器不仅表达更清楚,也让 slog.Value 能用针对常见类型的紧凑表示。
先确认使用范围和性能边界
log/slog 随 Go 1.21 进入标准库,Logger.LogAttrs 和顶层 slog.LogAttrs 都可以直接使用。项目如果必须用更旧的 Go 工具链,就不能只靠改 import 获得这个 API,需要先升级工具链或继续使用原有日志方案。
有三个边界值得提前说清:
| 边界 | 实际含义 | 应对方式 |
|---|---|---|
| 方法更高效 | 省去通用参数转换,不代表所有调用都零分配 | 用真实 Handler 做基准测试 |
| 禁用级别会提前返回 | 传给方法的表达式仍在调用前求值 | 昂贵值先用 Enabled 守卫 |
| Context 可传递信息 | 取消 Context 不会阻止日志写入 | 不要把取消当作日志开关 |
这也是我后来不再追求“一换 API 就归零”的原因。日志输出的最终成本还包括时间格式化、JSON 转义、源代码位置、LogValuer、自定义 Handler、写入器和缓冲扩容。
把稳定属性移出热点调用
请求 ID、状态码会随事件变化,适合在每次 LogAttrs 中构造;服务名、环境、组件名通常长期不变,没必要每次重复提交。可以在初始化阶段派生一个带固定属性的 Logger:
package logging

import "log/slog"

func Component(base *slog.Logger) *slog.Logger {
	// 固定字段只绑定一次,后续日志复用同一个派生 Logger。
	return base.With(
		slog.String("service", "checkout"),
		slog.String("component", "payment"),
		slog.String("env", "prod"),
	)
}
Logger.With 最终调用 Handler 的 WithAttrs。Handler 因而有机会预先格式化这些固定属性,而不是在每条日志里重复处理。官方 slog 设计说明特别把这一点列为性能优化机会。
这里的取舍是:不要为每条请求临时创建一个只用一次的派生 Logger,那会把构造成本重新搬回热点。适合预绑定的是生命周期较长、重复率高的属性;一次性字段仍放在当前事件里。
关闭的日志级别也要避免昂贵求值
LogAttrs 内部会先问 Handler 的 Enabled,关闭的级别不会创建并提交 Record。不过 Go 会在调用函数前计算参数,所以哈希、序列化、大对象转换或数据库查询不会因为方法内部提前返回而自动消失。
package logging

import (
	"context"
	"crypto/sha256"
	"encoding/hex"
	"log/slog"
)

func DebugPayload(ctx context.Context, logger *slog.Logger, payload []byte) {
	if !logger.Enabled(ctx, slog.LevelDebug) {
		// Debug 被关闭时,避免计算哈希和十六进制字符串。
		return
	}

	sum := sha256.Sum256(payload)
	digest := hex.EncodeToString(sum[:])

	// 只有级别启用后才构造昂贵属性值。
	logger.LogAttrs(ctx, slog.LevelDebug, "payload digest",
		slog.Int("bytes", len(payload)),
		slog.String("sha256", digest),
	)
}
如果值本身适合延迟解析,也可以实现 slog.LogValuer,但仍要留意 Handler 最终解析值的时机和次数。对明显昂贵且仅在某个级别需要的数据,显式 Enabled 通常最容易读懂。
Record 为什么对少量属性更友好
当前标准库实现会在 slog.Record 内部预留一个可容纳五个 Attr 的数组。官方团队分析开源项目后发现,绝大多数日志调用传入的属性不超过五个,因此让常见情况不必为属性列表单独申请后备切片。
当属性超过这个内联区,Record 会使用 back []Attr 保存剩余部分,届时可能出现一次分配。标准库自己的测试也覆盖了三个 Attr 无分配、六个 Attr 出现一次分配的典型情况。不过“五个”是当前实现细节,不是 API 契约;Go 版本、编译器优化、Handler 和属性值都会改变结果。
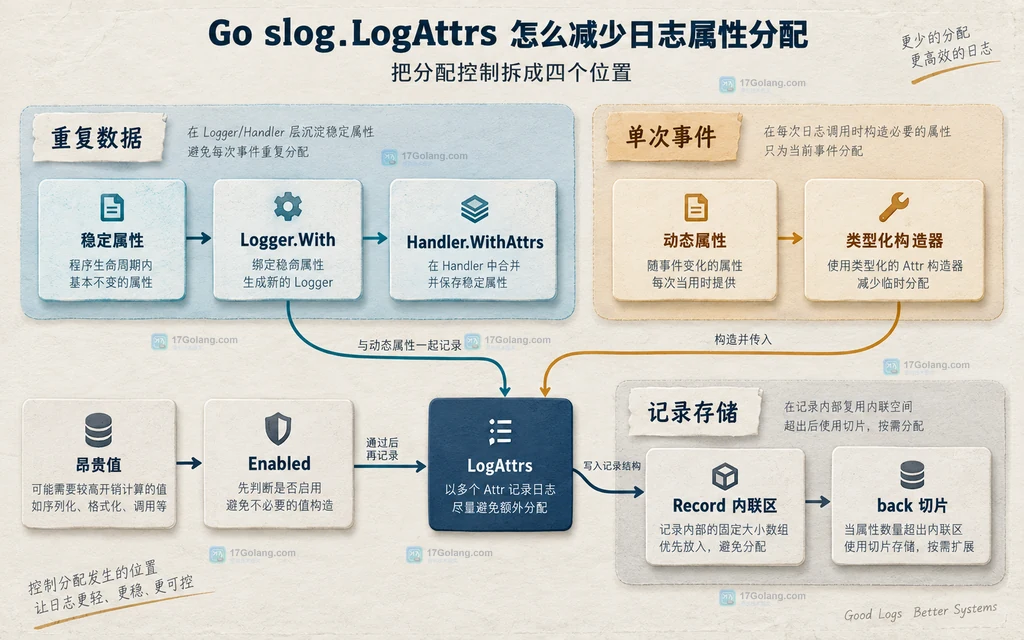
我不会为了卡在五个字段以内而随意删日志上下文,也不会把多个字段硬塞进一个字符串。更合理的顺序是:先确认字段是否真的需要;把重复字段交给 With;保留查询和排障必需的动态字段;最后再看基准数据是否值得继续优化。
用基准测试比较自己的 Handler
下面的基准同时保留 JSON 编码成本,并把输出写到 io.Discard,用于比较同一 Handler 下两种参数入口。它不代表生产环境的绝对耗时,但能回答“在当前工具链和字段组合里,LogAttrs 是否减少了分配”。
package logging_test

import (
	"context"
	"io"
	"log/slog"
	"testing"
)

var benchmarkLogger = slog.New(slog.NewJSONHandler(io.Discard, nil))
var benchmarkContext = context.Background()

func BenchmarkLogPairs(b *testing.B) {
	b.ReportAllocs() // 报告每次操作的内存分配次数和字节数。
	for i := 0; i
# 只运行这组基准,并显示内存分配指标。 go test -run '^$' -bench 'BenchmarkLog' -benchmem -count=5
观察时重点看 allocs/op 和 B/op,同时看 ns/op 是否稳定。至少重复多次,并在与生产一致的 Go 版本、Handler 选项和典型属性数量下测试。若两种写法都已经是零分配,LogAttrs 仍可能减少分支和转换时间,但收益要以测量为准。
哪些写法仍可能产生分配
- 属性超过内联容量:Record 需要后备切片保存更多 Attr。
- 使用 slog.Any:任意类型可能触发接口、反射或 Handler 格式化成本;必要时使用,但不要拿它替代所有专用构造器。
- 组属性临时切片:每次动态拼装大量组成员,可能在组值和 Record 两层产生额外存储。
- 字符串提前格式化:先用
fmt.Sprintf拼好值,再交给 slog,会把格式化成本放在日志调用之前。 - 源代码位置:开启
AddSource会增加调用栈与路径处理成本。 - 自定义 LogValuer:方法内部若创建 map、切片或字符串,LogAttrs 无法替它消除分配。
- 输出缓冲扩容:超长消息、大字符串和复杂 JSON 仍可能让 Handler 扩容。
我现在采用的热点日志模板
package requestlog

import (
	"context"
	"log/slog"
	"time"
)

type Logger struct {
	base *slog.Logger
}

func New(base *slog.Logger) *Logger {
	// 服务级固定字段在初始化时绑定一次。
	return &Logger{base: base.With(slog.String("service", "api"))}
}

func (l *Logger) Completed(ctx context.Context, method string, status int, elapsed time.Duration) {
	// 每次请求只构造真正变化的类型化属性。
	l.base.LogAttrs(ctx, slog.LevelInfo, "request completed",
		slog.String("method", method),
		slog.Int("status", status),
		slog.Duration("elapsed", elapsed),
	)
}
这套模板适合调用频率高、字段结构稳定的服务日志。低频管理任务、启动信息或一次性诊断代码,普通 Info 的交替键值写法可能已经足够清晰,没有必要为了微小收益增加重构成本。
常见问题
LogAttrs 一定比 Info 快吗?不保证。它减少了属性解析工作,但 Handler、输出和字段值可能占主要成本。
是否应该把所有字段都放到 Logger.With?不应该。只放生命周期长且重复出现的稳定字段;请求级动态字段继续放在当前日志事件中。
六个属性就必须优化吗?不必。当前实现可能为后备切片分配,但可观测性需要优先;先测量,再判断一次分配是否真是瓶颈。
Context 取消后日志会自动丢弃吗?不会。Context 主要用于向 Handler 传递信息,取消本身不会阻止日志记录。
总结:slog.LogAttrs 的价值在于让高频日志从一开始就使用明确的 Attr,减少通用参数转换。继续配合 Logger.With 复用稳定字段、Enabled 推迟昂贵求值,并在真实 Handler 上测量,才能把“更高效”变成可确认的分配改进,而不是一句没有边界的零分配承诺。
-
432 收藏
-
485 收藏
-
369 收藏
-
344 收藏
-
275 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习