
Go mail.AddressParser 怎么解析自定义字符集地址
来源:17golang原创
时间:2026-10-05 05:40:28 107浏览 收藏
要让 Go 解析邮件地址中使用自定义字符集编码的显示名,不要直接调用 mail.ParseAddress,而要创建 mail.AddressParser,并给它配置带 CharsetReader 的 mime.WordDecoder。这个回调负责把 RFC 2047 encoded-word 中的原始字节转换为 UTF-8,随后 AddressParser 才能把显示名写入 mail.Address.Name。
官方文档:https://pkg.go.dev/net/mail
CharsetReader只处理邮件头里的编码显示名,不是用来转换user@domain的。标准库默认支持 UTF-8、ISO-8859-1 和 US-ASCII;其他字符集才需要自定义转换器。
先确认故障确实来自显示名字符集
典型输入不是普通的 张三 ,而是类似下面的 RFC 2047 形式:
=?gb18030?B?...?=
其中 gb18030 是字符集标签,B 表示 Base64 编码。地址解析失败时,先拆开看两个部分:
- 如果错误发生在显示名的 encoded-word,配置
WordDecoder。 - 如果
user@domain本身不符合邮件地址语法,字符集转换器无法修复它。 - 如果输入是多个逗号分隔地址,应调用同一个解析器的
ParseList,而不是逐段手工切字符串。
AddressParser、WordDecoder 与 CharsetReader 各管什么
mail.AddressParser 负责 RFC 5322 地址结构;它的 WordDecoder 字段负责 RFC 2047 encoded-word;CharsetReader 则只在解码器遇到非默认字符集时提供“原字符集到 UTF-8”的 Reader。标准库保证传给回调的字符集名称是小写形式,而且回调返回的 Reader 与 error 至少有一个不能为 nil。
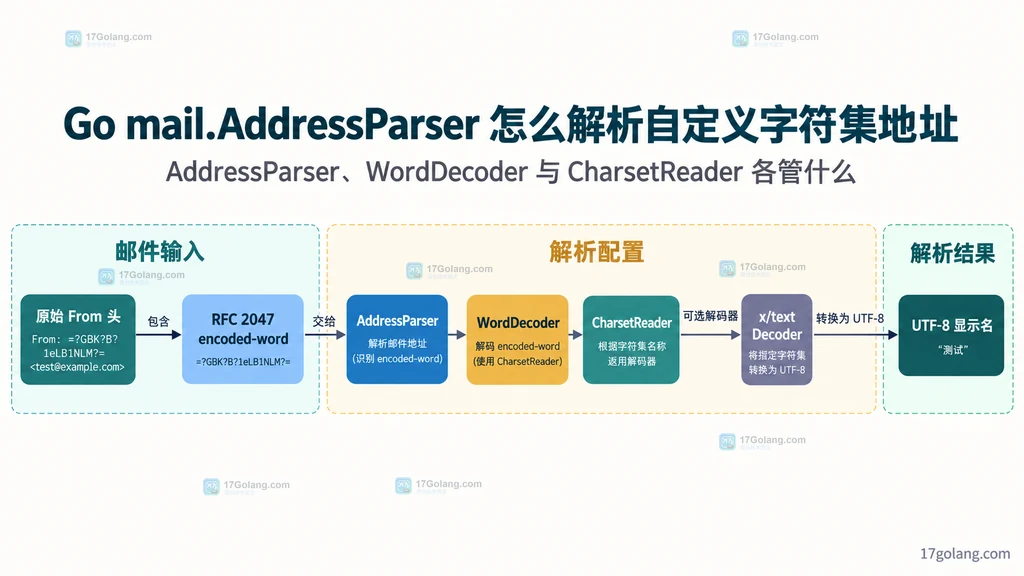
最小配置可以写成下面这样。这里使用 Go 官方维护的 golang.org/x/text,由 htmlindex.Get 识别常见字符集别名,再用 transform.NewReader 输出 UTF-8。
package mailaddr

import (
    "fmt"
    "io"
    "mime"
    "net/mail"
    "strings"

    "golang.org/x/text/encoding/htmlindex"
    "golang.org/x/text/transform"
)

// NewParser 创建支持受控旧字符集的邮件地址解析器。
func NewParser() *mail.AddressParser {
    return &mail.AddressParser{
        WordDecoder: &mime.WordDecoder{
            CharsetReader: charsetReader,
        },
    }
}

// charsetReader 只允许业务明确接受的字符集,避免无边界地兼容错误标签。
func charsetReader(charset string, input io.Reader) (io.Reader, error) {
    name := strings.ToLower(strings.TrimSpace(charset))

    allowed := map[string]bool{
        "gb18030":  true,
        "gbk":      true,
        "gb2312":   true,
        "shift_jis": true,
        "shift-jis": true,
    }
    if !allowed[name] {
        return nil, fmt.Errorf("mail address: unsupported charset %q", name)
    }

    enc, err := htmlindex.Get(name)
    if err != nil {
        return nil, fmt.Errorf("mail address: lookup charset %q: %w", name, err)
    }

    // NewDecoder 将旧字符集字节流按需转换为 UTF-8。
    return transform.NewReader(input, enc.NewDecoder()), nil
}
这里的白名单很重要:它让系统只接受确实需要兼容的邮件来源。以后新增字符集时,修改一个位置即可;未知标签会保留明确错误,而不是静默生成乱码。
封装单地址与地址列表入口
解析入口应复用同一个 AddressParser。这样 From、Reply-To 与 To 的字符集策略一致,错误信息也容易统一记录。
package mailaddr

import (
    "fmt"
    "net/mail"
)

// ParseOne 解析一个地址,并保留字段名便于定位坏邮件头。
func ParseOne(parser *mail.AddressParser, field, raw string) (*mail.Address, error) {
    addr, err := parser.Parse(raw)
    if err != nil {
        return nil, fmt.Errorf("parse %s address: %w", field, err)
    }
    return addr, nil
}

// ParseMany 解析逗号分隔的地址列表,不手工按逗号切分带引号的显示名。
func ParseMany(parser *mail.AddressParser, field, raw string) ([]*mail.Address, error) {
    addrs, err := parser.ParseList(raw)
    if err != nil {
        return nil, fmt.Errorf("parse %s address list: %w", field, err)
    }
    return addrs, nil
}
如果已经通过 mail.ReadMessage 得到 mail.Header,需要自定义字符集时,建议取出原始字段再交给自定义解析器:
// 自定义解析器必须接收到原始 To 字段,才能使用自己的 WordDecoder。
parser := mailaddr.NewParser()
recipients, err := mailaddr.ParseMany(parser, "To", msg.Header.Get("To"))
if err != nil {
    return fmt.Errorf("decode recipients: %w", err)
}
直接调用 msg.Header.AddressList("To") 很方便,但它不会让你注入这一套自定义 WordDecoder。需要兼容旧字符集时,显式使用 parser.ParseList 更清楚。
构造一个可核对的 GB18030 示例
为了避免把某段不可读字节硬编码进源码,可以先用同一字符集编码一个测试显示名,再拼成 encoded-word。这个辅助函数只用于测试或构造样例;生产代码通常直接接收上游邮件头。
package main

import (
    "encoding/base64"
    "fmt"

    "golang.org/x/text/encoding/simplifiedchinese"
    "golang.org/x/text/transform"

    "example.com/project/mailaddr"
)

// encodeGB18030Word 构造 RFC 2047 Base64 encoded-word,便于测试解析器。
func encodeGB18030Word(name string) (string, error) {
    raw, _, err := transform.Bytes(
        simplifiedchinese.GB18030.NewEncoder(),
        []byte(name),
    )
    if err != nil {
        return "", fmt.Errorf("encode test display name: %w", err)
    }

    encoded := base64.StdEncoding.EncodeToString(raw)
    return "=?gb18030?B?" + encoded + "?=", nil
}

func main() {
    word, err := encodeGB18030Word("小明")
    if err != nil {
        panic(err)
    }

    // 邮箱地址保持 ASCII,只有显示名使用 GB18030 encoded-word。
    raw := word + " "
    addr, err := mailaddr.ParseOne(mailaddr.NewParser(), "From", raw)
    if err != nil {
        panic(err)
    }

    fmt.Printf("name=%s address=%s\n", addr.Name, addr.Address)
}
核对结果时不要只看“没有报错”,还要分别检查 Name 与 Address:
name=小明 address=xiaoming@example.com
这两个字段都正确,才能说明显示名已经转成 UTF-8,邮箱地址结构也被正确解析。Go 的 net/mail 不会替你做 Unicode 规范化;如果业务要把视觉上等价的名称用于搜索或去重,应在解析成功后另行定义规范化策略。
不支持字符集时怎样回退
遇到未知字符集,最安全的默认行为是返回错误并保留原始邮件头供排查,不要猜测成 GBK、Latin-1 或 UTF-8。猜错字符集通常不会修好数据,只会把可定位的错误变成难以追踪的乱码。
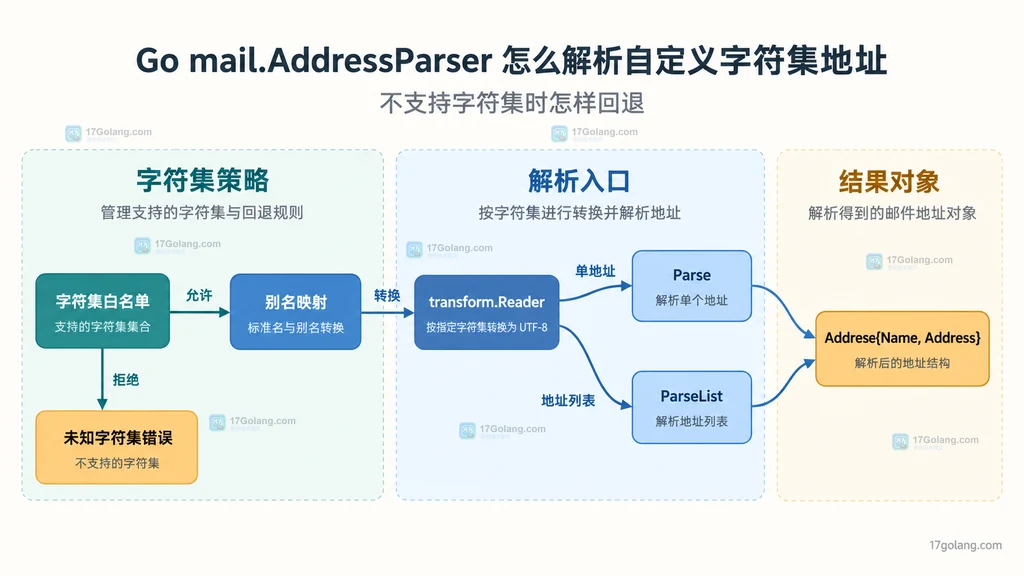
线上处理可以采用三层策略:
- 正常路径:白名单字符集转换成功,继续使用
Name和Address。 - 隔离路径:未知字符集或转换失败时,把邮件放入待处理队列,并记录字段名、字符集标签和消息标识。
- 人工回退:确认上游真实编码后再扩展白名单,随后重放原始邮件头;不要直接覆盖原始数据。
如果业务必须“邮箱地址可用就继续”,也应把显示名降级设计成显式策略,例如丢弃无法解码的显示名,只保留经过语法解析确认的地址。不要通过正则从失败字符串里盲目提取 @ 两侧内容。
上线前的核对清单
| 检查项 | 正确判断 | 异常处理 |
|---|---|---|
| 字符集标签 | 命中允许列表或标准库默认集合 | 返回带标签的错误 |
| 显示名 | Name 是预期 UTF-8 文本 | 保留原始头并隔离 |
| 邮箱地址 | Address 是预期的 user@domain | 按地址语法错误处理 |
| 地址列表 | 使用 ParseList 保留引号和逗号语义 | 不要手工 Split |
| 日志 | 记录字段名、消息标识和字符集 | 不记录完整私密邮件内容 |
常见问题
为什么设置 CharsetReader 后 UTF-8 仍然不进回调?
UTF-8、ISO-8859-1 和 US-ASCII 由 mime.WordDecoder 默认处理,不需要调用自定义回调。这是正常行为。
CharsetReader 能解析中文邮箱地址吗?
它负责 RFC 2047 显示名的字符集转换,不负责把邮箱 local-part 从任意旧字符集转换成合法地址。地址本身仍由 net/mail 按邮件地址语法解析。
为什么不直接用 strings.Split 切 To 字段?
显示名可能带引号、注释或逗号,简单切分会破坏地址结构。让 AddressParser.ParseList 处理列表,才能沿用标准库的语法解析。
是否应该接受 htmlindex 支持的全部字符集?
不建议默认全部放开。按真实邮件来源维护白名单,更容易发现错误标签、控制兼容范围,也便于回滚和审计。
核心做法可以概括为:让 AddressParser 管地址语法,让 WordDecoder 管 encoded-word,再让受控的 CharsetReader 把旧字符集转换为 UTF-8。职责分开后,单地址、地址列表、未知字符集和后续扩展都会更容易维护。
-
860 收藏
-
843 收藏
-
826 收藏
-
809 收藏
-
792 收藏
-
435 收藏
-
173 收藏
-
211 收藏
-
370 收藏
-
410 收藏
-
194 收藏
-
139 收藏
-
430 收藏
-
325 收藏
-
363 收藏
-
370 收藏
-
180 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习