
Go Scanner 连续调用 Scan 后 Bytes 为什么会变化
来源:17golang原创
时间:2026-10-05 16:40:57 136浏览 收藏
Scanner.Bytes() 返回的是最近一次 Scan 产生的 token,但这段切片可能直接指向 Scanner 正在复用的底层缓冲区。下一次 Scan 为新 token 读取或整理数据时,同一片底层数组可能被覆盖,所以之前保存的 []byte 内容也会随之变化。
只在当前循环内读取或解析 token,可以直接用Bytes();只要数据要跨越下一次Scan保存,就先复制,或者改用返回独立字符串的Text()。
先做一个会暴露问题的小工具
目标很小:把多行输入扫描成 token,并在扫描结束后统一打印。下面这段“看起来合理”的代码把每次得到的切片直接追加到结果中:
package main

import (
    "bufio"
    "fmt"
    "strings"
)

func main() {
    input := "red\ngreen\nblue\n"
    scanner := bufio.NewScanner(strings.NewReader(input))

    var tokens [][]byte
    for scanner.Scan() {
        // 错误点:这里只保存切片描述,不会复制 token 的底层字节。
        tokens = append(tokens, scanner.Bytes())
    }
    if err := scanner.Err(); err != nil {
        // 扫描结束后必须检查非 EOF 错误。
        panic(err)
    }

    for i, token := range tokens {
        // 此处打印发生在所有 Scan 调用之后,旧切片可能已经被覆盖。
        fmt.Printf("%d: %q\n", i, token)
    }
}
问题不在 append(tokens, ...) 本身。外层切片确实增长了,但追加进去的每一项仍然只是一个切片头,里面记录指针、长度和容量;它没有自动把 token 指向的字节复制一份。因输入长度、缓冲区移动和分词方式不同,旧内容可能全部变化,也可能只有部分变化,因此不要依赖某一次偶然“看起来正常”的结果。
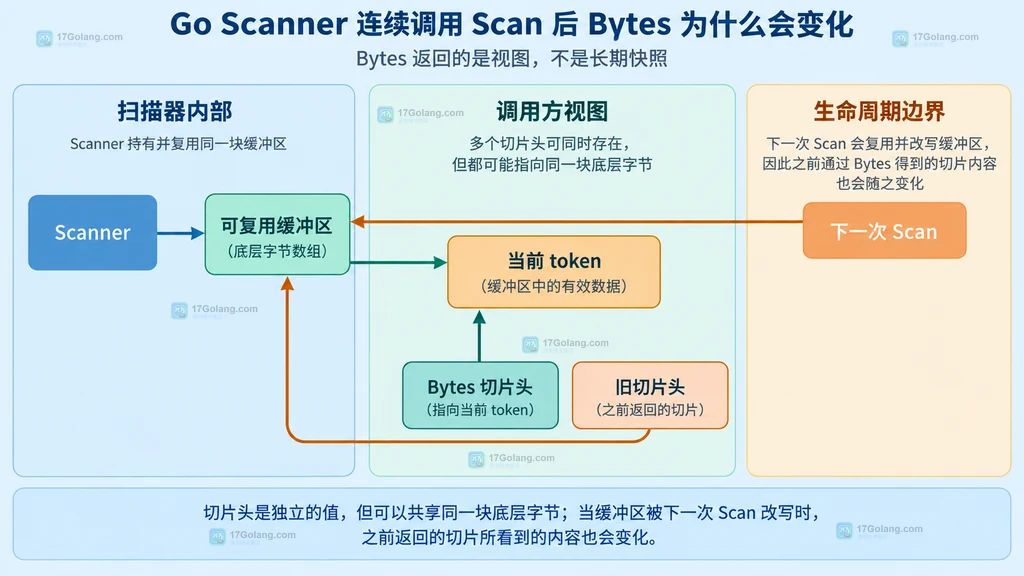
Bytes 返回的是视图,不是长期快照
Go 标准库文档对这个边界写得很直接:Bytes 不分配新内存,返回切片的底层数组可能在后续 Scan 调用中被覆盖。这里要区分三个对象:
- Scanner:持有读取状态、分词函数和可复用缓冲区。
- 当前 token:最近一次
Scan找到的字节范围。 - Bytes 返回值:描述这个范围的
[]byte切片,它不承诺拥有独立数组。
Scan 前进到下一个 token 后,Scanner 可以继续利用已有空间。旧切片仍然指向那块空间,因此它观察到的是“这块内存现在的内容”,而不是“调用 Bytes 那一刻的不可变快照”。这和 bufio.Reader.ReadSlice 一类借用缓冲区的 API 是相似的生命周期约束。
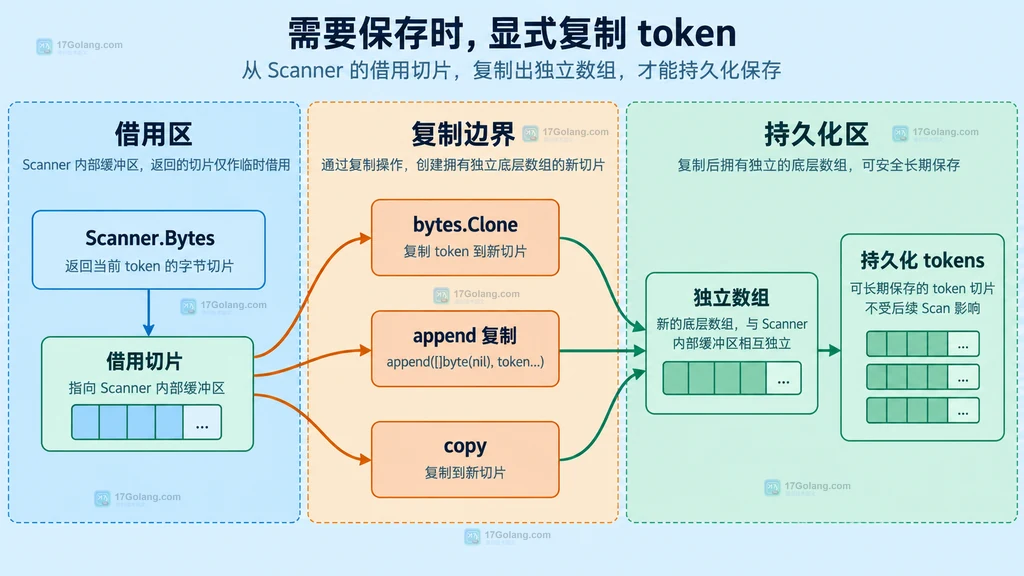
需要保存时,显式复制 token
Go 1.20 及以上可以用 bytes.Clone 清楚表达“我要拥有一份独立副本”:
package main

import (
    "bufio"
    "bytes"
    "fmt"
    "strings"
)

func main() {
    scanner := bufio.NewScanner(strings.NewReader("red\ngreen\nblue\n"))
    tokens := make([][]byte, 0, 3)

    for scanner.Scan() {
        // Clone 分配独立数组,后续 Scan 不会改写已保存的 token。
        token := bytes.Clone(scanner.Bytes())
        tokens = append(tokens, token)
    }
    if err := scanner.Err(); err != nil {
        // Err 会报告扫描期间遇到的第一个非 EOF 错误。
        panic(err)
    }

    for i, token := range tokens {
        // 预期依次得到 red、green、blue,且每项内容保持独立。
        fmt.Printf("%d: %q\n", i, token)
    }
}
如果项目需要兼容更早的 Go 版本,可以使用 append 完成同样的复制:
for scanner.Scan() {
    // 从 nil 切片开始追加,会为当前 token 创建独立存储。
    token := append([]byte(nil), scanner.Bytes()...)
    tokens = append(tokens, token)
}
另一种常见写法是 copy:
src := scanner.Bytes()
dst := make([]byte, len(src))
// copy 把当前 token 的字节写入新分配的目标切片。
copy(dst, src)
tokens = append(tokens, dst)
三种写法的关键都不是语法,而是让保存结果拥有独立底层数组。复制必须发生在下一次 Scan 之前。
Bytes、Text 和立即消费怎么选
| 做法 | 是否产生独立数据 | 适合场景 | 注意点 |
|---|---|---|---|
scanner.Bytes() | 否 | 当前循环内立即解析、比较、写出 | 不要跨越下一次 Scan 保存 |
bytes.Clone(scanner.Bytes()) | 是 | 需要保留二进制 token | 每个保存项都会分配并复制 |
scanner.Text() | 是,返回新分配字符串 | 后续按文本处理或作为 map 键 | 结果类型是 string |
如果只是把 token 解析成整数、立即写入哈希、同步发送给不保留切片的函数,直接使用 Bytes 可以避免不必要的复制。反过来,只要接收方会异步处理、放进队列、缓存到结构体或扫描结束后再使用,就应该把所有权边界写清楚并复制。
还要注意:把借用切片传给 goroutine 尤其危险。即使 goroutine 很快启动,也无法保证它在下一次 Scan 前读完。应当在启动 goroutine 之前完成复制:
for scanner.Scan() {
    // 先取得独立副本,再交给并发任务,避免与 Scanner 复用缓冲区产生数据竞争。
    token := bytes.Clone(scanner.Bytes())
    go func(data []byte) {
        // 并发任务只读取自己拥有的副本。
        process(data)
    }(token)
}
给小工具加上独立性验收
不需要比较内存地址才能判断是否修好。更稳定的验收方式是:保存第一个 token 后继续扫描,再确认保存值仍然等于原内容。下面是可放进项目的测试:
package main

import (
    "bufio"
    "bytes"
    "strings"
    "testing"
)

func TestSavedTokenIsIndependent(t *testing.T) {
    scanner := bufio.NewScanner(strings.NewReader("alpha\nbeta\n"))

    if !scanner.Scan() {
        // 第一次扫描必须成功,否则测试没有可保存的 token。
        t.Fatal("missing first token")
    }
    saved := bytes.Clone(scanner.Bytes())

    if !scanner.Scan() {
        // 继续扫描会推进 Scanner,但不应影响 saved。
        t.Fatal("missing second token")
    }
    if err := scanner.Err(); err != nil {
        t.Fatalf("scan failed: %v", err)
    }
    if string(saved) != "alpha" {
        t.Fatalf("saved token changed: %q", saved)
    }
}
这个测试验证的是业务真正关心的性质:保存值在 Scanner 前进后仍保持独立。它不会绑定 Scanner 当前实现的具体缓冲布局,因此比依赖容量、地址或某组输入的偶然表现更可靠。
常见疑问
把 Bytes 追加到 [][]byte 为什么不算复制?
因为追加的是切片描述,底层数组仍可共享。只有复制字节本身,才会形成独立数据。
每次都用 Text 就一定更好吗?
不是。只在当前循环内消费字节时,Bytes 可以少一次分配;需要长期保存文本时,Text 更直观。选择取决于生命周期和目标类型。
调用 Scanner.Buffer 能阻止旧 Bytes 变化吗?
不能。Buffer 控制初始缓冲区和最大 token 大小,不会把 Bytes 改成拥有独立数组的快照。
什么时候必须检查 Scanner.Err?
扫描循环结束后都应检查。Scan 返回 false 既可能是正常 EOF,也可能是 I/O 错误或 token 过大;Err 用来区分这些情况。
结论
Scanner.Bytes 的变化是有意的零额外分配设计,不是随机故障。把它当作“只在下一次 Scan 前有效的借用视图”就容易判断:立即消费时直接用;跨循环、跨 goroutine 或长期保存时先复制;文本场景也可直接用 Text。最后保留 Err 检查,并用内容独立性测试验收即可。
-
Golang · Go问答 | 2个月前 | 配置 · 设计模式 · 架构 · Go问答 · 代码重构 · Go 默认值 配置参数 参数校验 构造函数 option Functional Options100 收藏
-
100 收藏
-
Golang · Go问答 | 3星期前 | 错误处理 · 文件读取 · Go问答 · Go errors.Join Go deferclose Go defer Close错误 Go关闭文件返回值 Go文件读取错误处理100 收藏
-
100 收藏
-
Golang · Go问答 | 3个月前 | 并发安全 · RWMutex · sync.Map · Go问答 · RWMutex sync.Map Go问答 Go map并发读写 concurrent map writes102 收藏
-
116 收藏
-
335 收藏
-
497 收藏
-
418 收藏
-
433 收藏
-
223 收藏
-
307 收藏
-
482 收藏
-
472 收藏
-
259 收藏
-
431 收藏
-
253 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习