
Redis 把向量集合纳入核心数据类型意味着什么
来源:17golang原创
时间:2026-10-07 07:19:41 306浏览 收藏
Redis 的变化不只是“多了一个向量命令”。当前官方数据类型文档已经把 Vector Sets 列入 Redis Open Source 的数据类型列表,这说明向量相似度检索正在从额外模块或独立服务的思路,向 Redis 原生数据模型靠拢。真正的影响是:应用可以用更接近 Redis 习惯的方式保存 embedding、元素标识和可选属性,再按相似度取回结果。
官方地址:https://redis.io/docs/latest/develop/data-types/
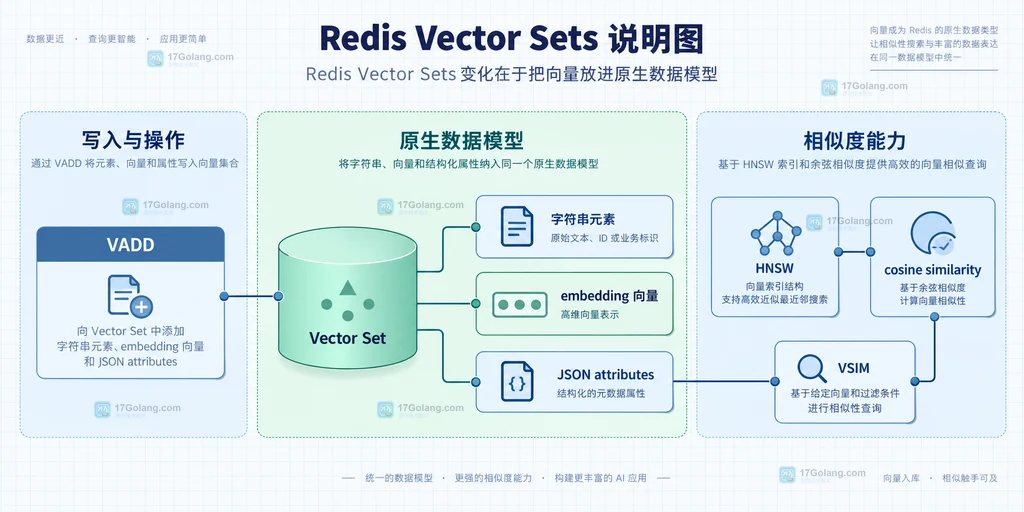
- Vector Sets 把“字符串元素 + 向量”绑定成专用数据类型,核心查询入口是 VADD 和 VSIM。
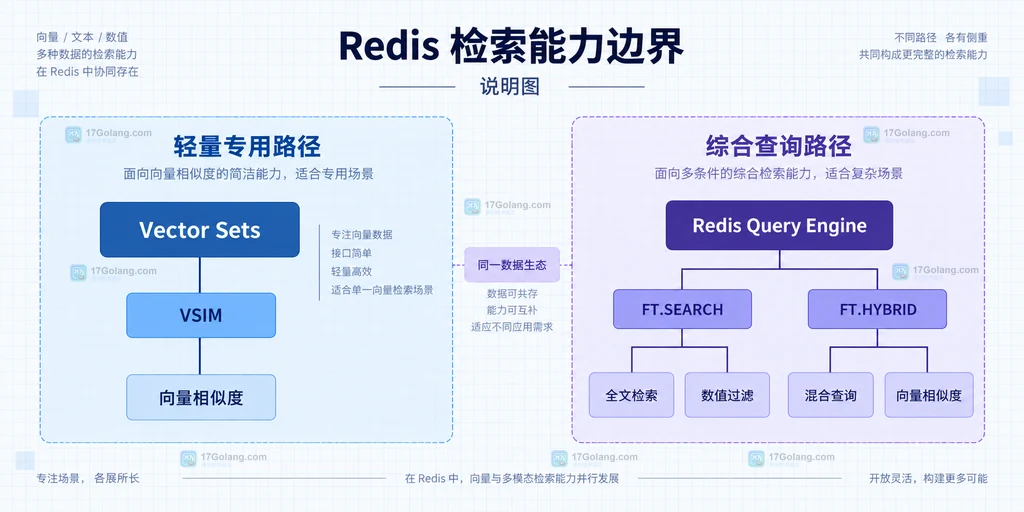
- 它适合轻量的向量相似度场景,不等于取代支持全文、数值和混合查询的 Redis Query Engine。
- 落地前要确认 Redis 版本、beta/兼容性边界、向量维度、量化方式和数据规模。
Redis Vector Sets 变化在于把向量放进原生数据模型
2025 年 4 月,Redis 官方首次公告 Vector Sets,并说明它以 Redis 8 Community Edition 的 beta 能力提供。如今文档已经把它放进数据类型体系,产品信号变得更清楚:向量不是只能藏在 Hash、JSON 或外部向量库里的二进制字段,也可以成为 Redis 直接理解的对象。
它借鉴了 Sorted Set 的使用直觉,但成员不再只关联一个 score,而是关联一组向量值。Vector Set 还可以给成员挂 JSON attributes,再让 VSIM 在相似度检索时应用简单过滤。这样,推荐候选、语义片段或相似图片的“标识—向量—少量属性”可以被放在同一个原生边界内。
从 VADD 到 VSIM,开发体验为什么更像 Redis
最小模型可以先用低维示例理解,真实 embedding 通常有数百个维度。下面只是语法示意:先用 VADD 写入元素和向量,再用 VSIM 按给定向量寻找相似成员;VCARD、VDIM 则分别帮助读取集合规模和向量维度。
# 写入一个三维示例向量,实际项目应使用模型输出的固定维度
redis-cli VADD article_vectors VALUES 3 0.12 0.33 0.54 doc:001
# 按查询向量取回前 5 个相似元素,示例不代表本机已执行
redis-cli VSIM article_vectors VALUES 3 0.10 0.30 0.50 COUNT 5
# 读取集合规模与维度,先确认数据模型没有漂移
redis-cli VCARD article_vectors
redis-cli VDIM article_vectors
这里的关键不是命令数量少,而是数据结构和相似度操作被放在同一层。官方文档还提醒,使用 FP32 blob 时要处理 little-endian;如果不想承担跨架构字节序差异,可以使用 VALUES 形式。生产接入时还要把向量维度、元素唯一标识和属性过滤表达式当成契约,而不是等到召回结果异常后再补。
Vector Sets 与 Redis Query Engine 不是替代关系
这是这条新闻最容易被误读的地方。Vector Sets 的优势是轻量、专用、API 直接;当需求主要是“给一个向量,找最相似的若干成员”,它的模型很顺手。Redis Query Engine 面向的是更完整的检索:全文、数值、向量、地理和混合查询,还能对 Hash 或 JSON 建索引。
| 需求 | 更自然的选择 | 判断依据 |
|---|---|---|
| 只做相似度召回,属性过滤简单 | Vector Sets | 接受专用数据模型,优先要低心智负担 |
| 全文 + 向量 + 数值条件 | Redis Query Engine | 需要 FT.SEARCH 或 FT.HYBRID 的查询组合 |
| 已有 Hash/JSON 索引体系 | Redis Query Engine | 希望沿用现有文档和索引边界 |
这项变化会怎样影响 AI 应用架构
第一,原型阶段可以减少“缓存、会话、向量召回各放一个系统”的拼接成本;第二,数据模型更贴近 Redis,开发者能用熟悉的 key 和命令管理候选项;第三,选型责任更明确:轻量向量召回采用 Vector Sets,复杂过滤和混合搜索仍由 Query Engine 承担。
但这不是“向量数据库问题已经被解决”。Vector Sets 的 beta 历史、命令和 API 兼容性要按目标 Redis 版本确认;向量量化会影响内存与精度,HNSW 参数会影响召回与资源开销,规模增长后还要验证持久化、复制、分片和客户端支持。新闻带来的正确动作不是立即替换现有系统,而是拿一小组真实 embedding 做版本固定的对照实验。
一份可执行的采用清单
- 固定 Redis 版本,确认目标发行版确实提供 VADD、VSIM 和所需过滤能力。
- 记录模型维度、距离度量、量化设置和元素 ID 规则,禁止同一集合混入不同维度。
- 分别测相似度召回、属性过滤和重启恢复,别只看一次查询能否返回结果。
- 当需求出现全文、数值、地理或复杂混合条件时,重新评估 Query Engine,而不是继续堆 VSIM 过滤。
常见问题
Vector Sets 是 Redis Sorted Set 的替代品吗?
不是。Sorted Set 以 score 排序,Vector Sets 以向量相似度检索成员;两者解决的排序依据不同。
Vector Sets 是否等于完整向量数据库?
不能直接画等号。它是 Redis 中面向向量相似度的专用类型,完整全文、数值、混合检索和更复杂索引需求应评估 Redis Query Engine 或其他专用方案。
为什么要先确认维度和量化?
维度决定向量是否能放入同一集合,量化会在内存占用、速度和相似度精度之间做取舍;这两项一旦写入生产数据,后续迁移成本都不低。
因此,“纳入核心数据类型”的工程含义是 Redis 给向量数据提供了更原生的落点。它让轻量相似度场景更容易开始,也让复杂检索的分工更容易被说清楚;真正的架构收益,取决于你是否把场景边界和版本验证一起写进方案。
-
117 收藏
-
426 收藏
-
171 收藏
-
113 收藏
-
195 收藏
-
203 收藏
-
科技周边 · 业界新闻 | 5小时前 | go · 工具链 · 业界新闻 · 版本升级 · 语言特性 · Go工具链 Go 1.26 go fix Green Tea GC Go升级 new(expr) 泛型约束158 收藏
-
489 收藏
-
159 收藏
-
246 收藏
-
222 收藏
-
244 收藏
-
科技周边 · 业界新闻 | 19小时前 | 云原生 · kubernetes · 业界新闻 · Kubernetes 1.35 Pod重启 restartPolicy restartPolicyRules RestartAllContainers195 收藏
-
369 收藏
-
299 收藏
-
262 收藏
-
230 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习