
用表驱动测试覆盖输入分区并生成清晰的子测试名称
来源:17golang原创
时间:2026-10-07 09:45:32 302浏览 收藏
表驱动测试最容易写成“把几个样例塞进切片再循环”,但真正决定测试质量的是两件事:样例是否覆盖了不同输入分区,以及失败时子测试名称能否直接告诉你哪个业务边界出错。一个好测试表应该让每行都代表一个明确分区,而不是随机凑几个值。
官方资料:https://pkg.go.dev/testinghttps://go.dev/blog/subtests
Go 的 t.Run 会为每个子测试建立独立名称,完整名称由顶层测试和各级子测试名称用斜杠连接。这样既能让失败互不遮挡,也能通过 go test -run 只重放某个分区。下面用“解析重试次数”这个小场景把输入、测试表和诊断名称连起来。
先从输入来源拆出测试分区
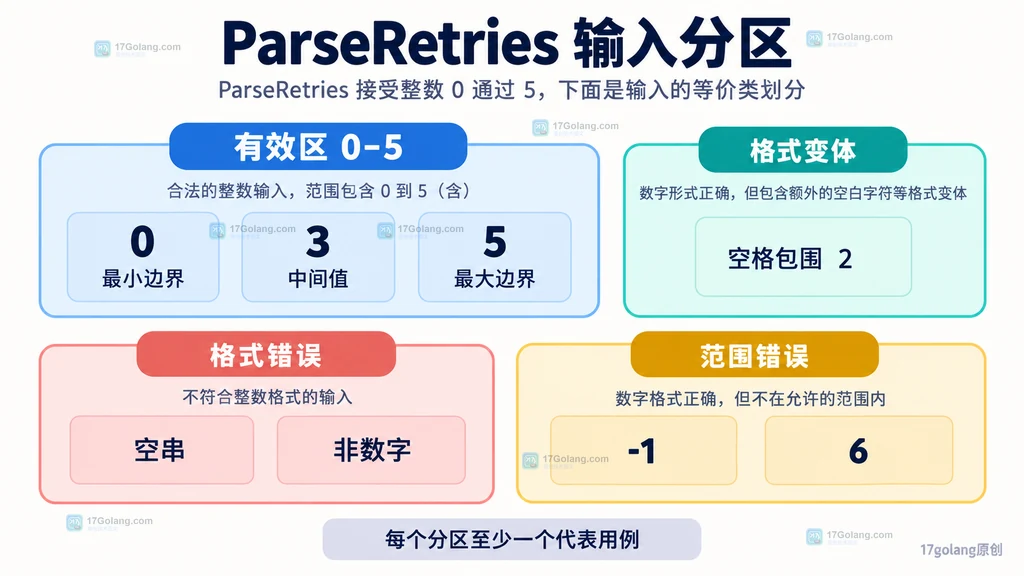
假设 ParseRetries 接收字符串配置,允许前后空格,合法范围是 0 到 5。不要先写测试代码,先列行为不同的输入集合:
- 有效区:范围中间值,例如
3; - 有效边界:最小值
0、最大值5; - 格式变体:带空格但可解析,例如
" 2 "; - 格式错误:空串、非数字;
- 范围错误:小于 0、大于 5。
同一分区中的值如果触发完全相同的判断,通常选一个代表值即可;边界两侧则要分别保留,因为很多缺陷来自 、 写反。这样得到的是行为集合,而不是样例收藏。
package retry

import (
	"errors"
	"strconv"
	"strings"
)

var ErrOutOfRange = errors.New("retries must be between 0 and 5")

func ParseRetries(raw string) (int, error) {
	// 允许配置文件里出现前后空格,但不掩盖空值或非数字。
	n, err := strconv.Atoi(strings.TrimSpace(raw))
	if err != nil {
		return 0, err
	}

	// 0 和 5 都是合法边界,范围外统一返回可识别错误。
	if n  5 {
		return 0, ErrOutOfRange
	}
	return n, nil
}
把分区名称和预期存进同一张表
测试表除了输入和预期,还应有一个稳定、可搜索的 name。名称不要写成 case1、input-3,也不要把完整输入格式化进去;应该表达“这个值为什么存在”。建议使用 分组/行为 结构,例如 valid/lower-bound、invalid/not-a-number。
package retry

import (
	"errors"
	"strconv"
	"testing"
)

func TestParseRetries(t *testing.T) {
	tests := []struct {
		name    string
		input   string
		want    int
		wantErr error
	}{
		// 每行代表一个输入分区,名称描述存在理由而不是数组序号。
		{name: "valid/middle", input: "3", want: 3},
		{name: "valid/lower-bound", input: "0", want: 0},
		{name: "valid/upper-bound", input: "5", want: 5},
		{name: "valid/surrounding-spaces", input: " 2 ", want: 2},
		{name: "invalid/empty", input: "", wantErr: strconv.ErrSyntax},
		{name: "invalid/not-a-number", input: "many", wantErr: strconv.ErrSyntax},
		{name: "invalid/below-min", input: "-1", wantErr: ErrOutOfRange},
		{name: "invalid/above-max", input: "6", wantErr: ErrOutOfRange},
	}

	for _, tc := range tests {
		t.Run(tc.name, func(t *testing.T) {
			got, err := ParseRetries(tc.input)

			// 先比较错误类别,再比较成功路径结果,失败信息更聚焦。
			if tc.wantErr != nil {
				if !errors.Is(err, tc.wantErr) {
					t.Fatalf("error = %v, want %v", err, tc.wantErr)
				}
				return
			}
			if err != nil {
				t.Fatalf("unexpected error: %v", err)
			}
			if got != tc.want {
				t.Errorf("result = %d, want %d", got, tc.want)
			}
		})
	}
}
测试直接用 strconv.ErrSyntax 标识语法错误。更大的项目可以把“是否报错”升级成错误哨兵、错误类型或错误码,但不要只用一个 wantErr bool 把所有错误混在一起,否则格式错误和范围错误互换时测试仍可能通过。
用 t.Run 让失败定位到具体分区
t.Run 的第一个参数会成为子测试名称。完整名称类似 TestParseRetries/invalid/above-max:顶层函数说明被测能力,第一层说明输入大类,叶子名称说明具体边界。看到失败行时,不必先反查输入表。
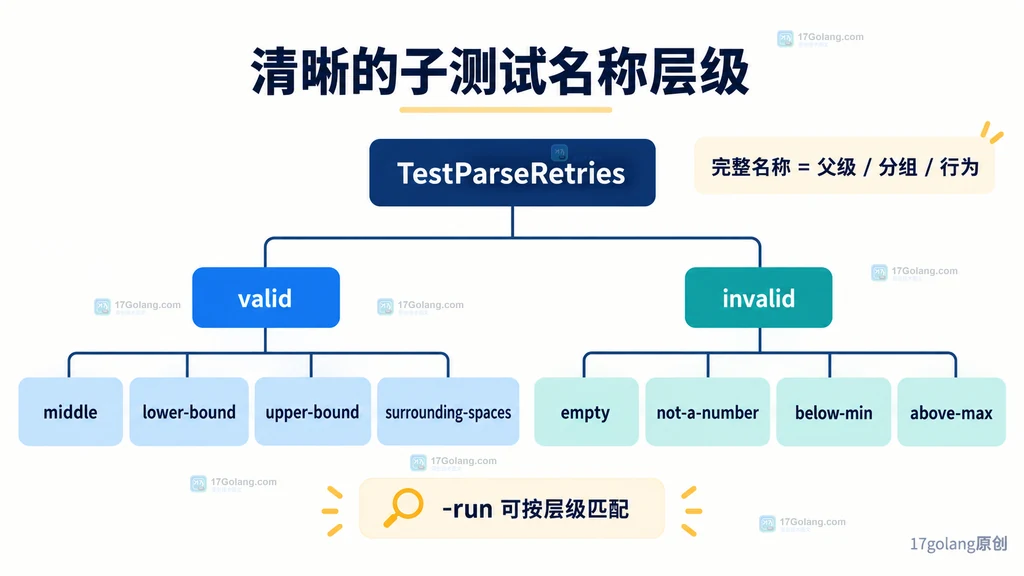
官方文档说明,子测试名称由父级和 Run 名称以斜杠组合;空格会被规范化为下划线,重复名称还会追加序号。依赖自动序号虽然能运行,却很难稳定筛选,所以测试表应主动保证名称唯一。
在子测试内部,Fatalf 只会终止当前子测试,不会阻止后续子测试继续执行。这个隔离性很适合表驱动测试:一次运行可以同时看到空串、非数字和越界值各自是否失败,而不是第一个错误就截断整张表。
用 -run 查询并重放目标分区
-run 接收正则表达式,并按斜杠拆分后匹配名称层级。名称设计得好,开发时就能从整张表逐步缩小范围:
# 运行整个 ParseRetries 测试及其全部子测试。
go test ./... -run '^TestParseRetries$' -v

# 只运行 invalid 分组,快速回归所有非法输入。
go test ./... -run '^TestParseRetries$/invalid' -v

# 只重放超过最大值这一条边界用例。
go test ./... -run '^TestParseRetries$/invalid/above-max$' -v
如果真实名称中包含斜杠,例如时区 America/New_York,斜杠也会被当成层级分隔。对一般业务测试,最省心的办法是让子测试名称只使用简短英文单词、连字符和明确的分组斜杠,不直接塞路径、URL 或用户原始输入。
扩展测试表时守住三个维护边界
第一,新增用例前先问“这是新分区,还是旧分区的又一个样例”。同一分区重复十个值会让表变长,却未必增加缺陷发现能力。第二,名称必须唯一且稳定;若一次重构只改了测试名称,CI 过滤规则和开发者常用命令也会受影响。第三,断言要对应预期语义,错误路径优先比较 errors.Is 或具体错误类型。
如果以后给子测试加 t.Parallel(),还要确认循环变量在项目所用 Go 版本中的捕获语义,并确保被测代码不共享可变全局状态。可以把并行化作为独立改动,不要在重构测试表时顺手加入,否则失败原因会混在一起。
| 检查项 | 推荐做法 | 应避免 |
|---|---|---|
| 输入覆盖 | 按有效、边界、格式错误、范围错误分区 | 只覆盖几个常见成功值 |
| 名称 | group/behavior | case1 或整段原始输入 |
| 错误断言 | 比较错误类别或错误类型 | 只检查 err != nil |
| 命令重放 | 名称层级适配 -run | 依赖重复名称的自动编号 |
相关问题
表驱动测试是不是用例越多越好?
不是。优先保证每种行为分区和边界都出现;同一分区增加样例,应该有新的缺陷假设,而不是为了数量。
子测试名称可以写中文吗?
可以,但团队还要考虑终端、CI 正则和跨平台输入便利性。简短稳定的英文语义名通常更容易复制和筛选,失败信息仍可在断言里使用中文说明。
什么时候该从表驱动测试升级到模糊测试?
当输入空间很大、组合难以穷举,并且能定义稳定的不变量时,可以用表格保留关键边界和回归样例,再用 Go fuzzing 探索未知输入;两者不是替代关系。
-
860 收藏
-
843 收藏
-
826 收藏
-
809 收藏
-
792 收藏
-
134 收藏
-
304 收藏
-
204 收藏
-
193 收藏
-
299 收藏
-
Golang · Go教程 | 1小时前 | 标准库 · 配置管理 · 错误处理 · 并发编程 · Go教程 · Go 并发初始化 共享配置 sync.OnceValue sync.OnceValues482 收藏
-
187 收藏
-
263 收藏
-
Golang · Go教程 | 2小时前 | goroutine · Context · Go教程 · 批处理 · 批处理 Timer WithTimeout Go context WithCancelCause 父子取消链441 收藏
-
336 收藏
-
Golang · Go教程 | 3小时前 | channel · select · Context · 并发编程 · Go教程 · context取消 time.NewTimer goroutine退出 Go select channel超时250 收藏
-
Golang · Go教程 | 3小时前 | channel · Context · Go教程 · Channel关闭 context取消 发送方关闭 Go数据管道 Go pipeline 多阶段并发492 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习