
用 dataclass slots 降低大量小对象的内存占用
来源:17golang原创
时间:2026-10-07 10:03:16 427浏览 收藏
当一个 Python 程序会同时保留几十万甚至更多字段固定的小对象时,普通 dataclass 为实例保留的 __dict__ 会形成可观的重复开销。Python 3.10 起可以直接写 @dataclass(slots=True),让字段进入预先声明的槽位,通常能降低这类实例的内存占用,同时保留自动生成的初始化、比较和字符串表示等能力。
slots=True适合“字段集合稳定、实例量大、不依赖运行时追加属性”的数据模型。它不是无条件优化:代码若访问obj.__dict__、动态挂属性、使用弱引用或混合复杂继承,就要先处理兼容边界。
官方文档:https://docs.python.org/3.14/library/dataclasses.html
项目目标:比较两种事件对象的批量内存
下面构建一个很小但完整的项目:同一份事件模型分别使用普通 dataclass 和 slotted dataclass,实现相同字段与方法;随后创建同等数量实例,用标准库 tracemalloc 比较 Python 分配器追踪到的当前内存和峰值内存。最后再检查序列化、动态属性、弱引用与继承。
这个例子把对象设计为三个整数属性,避免把大型字符串、图片或外部缓冲区的内存混进结论。实际节省量受 Python 版本、解释器实现、字段数量与字段值类型影响,因此文章不预设固定百分比,重点是教你在自己的环境中做同口径对比。
环境准备:确认 Python 版本和项目文件
dataclass(slots=True) 从 Python 3.10 开始提供。建议建立一个空目录,放入 models.py 和 bench_slots.py 两个文件,不需要安装第三方包。
# 确认解释器至少为 Python 3.10,weakref_slot 则需要 Python 3.11+
python3 --version

# 运行后续的批量对象内存对比脚本
python3 bench_slots.py
如果生产环境有多个 Python 解释器,务必使用应用实际启动时的那个解释器执行测试。不同运行时的对象布局和内存分配策略可能不同,不能拿开发机数字直接替代线上结论。
核心代码:只改 slots 参数,保持业务接口一致
先在 models.py 中定义两种事件类。字段顺序、类型、默认值和业务方法保持一致,让测量差异尽量只来自实例布局。
from dataclasses import dataclass


@dataclass
class Event:
    event_id: int
    kind: int
    value: int

    def weighted_value(self) -> int:
        # 两个模型保留相同业务方法,避免比较不同逻辑
        return self.value * (self.kind + 1)


@dataclass(slots=True)
class SlottedEvent:
    event_id: int
    kind: int
    value: int

    def weighted_value(self) -> int:
        # slots 只改变字段存储布局,不改变方法调用方式
        return self.value * (self.kind + 1)
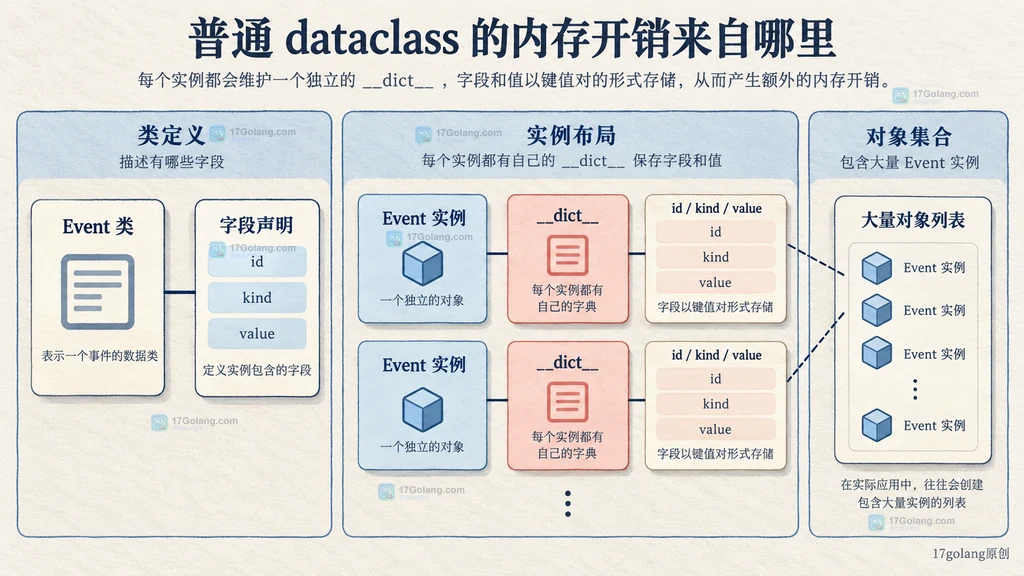
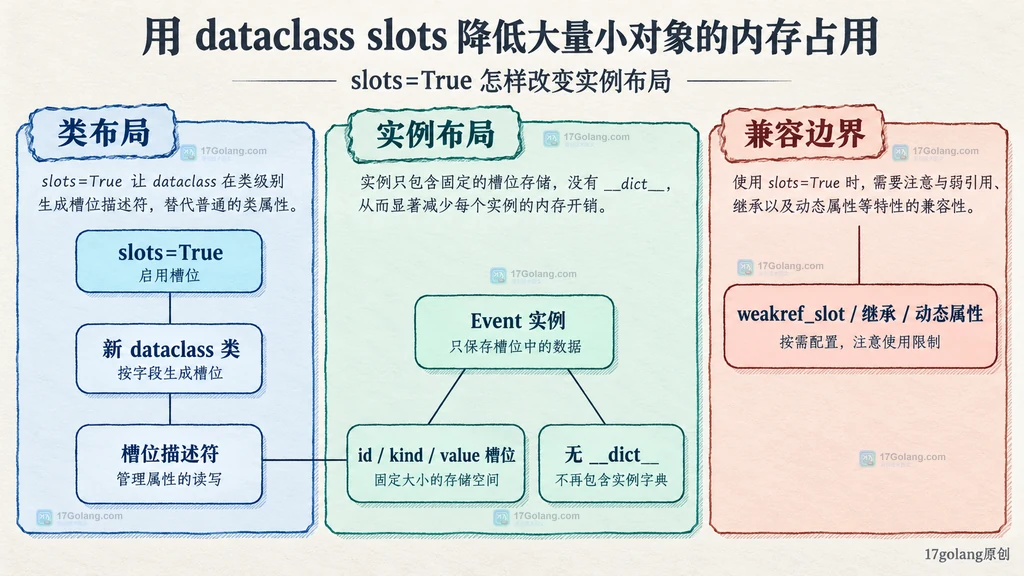
普通 Event 实例通常通过自己的 __dict__ 保存属性名到属性值的映射。SlottedEvent 的字段集合在类创建时已经确定,实例通过槽位描述符访问字段,不再自动创建实例 __dict__。Python 官方数据模型明确说明,这种布局相比每实例字典可显著节省空间,属性查找也可能更快。
本地运行:用 tracemalloc 做同口径对比
只看 sys.getsizeof(obj) 容易漏掉对象引用的 __dict__ 等分配。这里用 tracemalloc.get_traced_memory() 获取追踪到的当前值与峰值,并在对象列表仍然存活时记录数据。两种类分别启动一次追踪,避免第一组对象继续占用内存。
import gc
import tracemalloc
from collections.abc import Callable

from models import Event, SlottedEvent


COUNT = 200_000


def measure(factory: Callable[[int, int, int], object]) -> tuple[int, int, int]:
    # 先回收上一次测试留下的对象,让两组测量口径更接近
    gc.collect()
    tracemalloc.start()
    baseline, _ = tracemalloc.get_traced_memory()

    objects = [factory(i, i % 32, i * 2) for i in range(COUNT)]
    current, peak = tracemalloc.get_traced_memory()

    # 读取对象字段,避免示例只创建对象却完全不使用
    checksum = sum(item.weighted_value() for item in objects)
    tracemalloc.stop()
    return current - baseline, peak - baseline, checksum


def mib(byte_count: int) -> float:
    # 把字节转换为 MiB,便于在同一环境中比较
    return byte_count / 1024 / 1024


normal_current, normal_peak, normal_check = measure(Event)
slot_current, slot_peak, slot_check = measure(SlottedEvent)

# 校验两组对象执行了相同业务逻辑,再输出本机实测数据
assert normal_check == slot_check
print(f"普通 dataclass: current={mib(normal_current):.2f} MiB, peak={mib(normal_peak):.2f} MiB")
print(f"slots dataclass: current={mib(slot_current):.2f} MiB, peak={mib(slot_peak):.2f} MiB")
print(f"相对占用: {slot_current / normal_current:.2%}")
运行后先看两组校验值是否一致,再比较 current。peak 会包含构造过程中的短期分配,可用于观察创建阶段的峰值,但不应被解释成进程总 RSS。若模型字段引用大型容器,容器内容可能远大于对象头和属性字典,此时 slots 的相对收益自然会变小。
slots=True 怎样改变实例布局
给 dataclass 传入 slots=True 时,装饰器会生成 __slots__ 并返回一个新类。实例只为已声明字段预留位置,不再默认拥有 __dict__;这也意味着不能随意追加未声明属性。这个限制既是节省空间的来源,也是迁移时最需要检查的兼容点。
from dataclasses import asdict, fields

from models import SlottedEvent


event = SlottedEvent(event_id=7, kind=2, value=15)

# dataclasses 官方 API 仍可读取字段,不要依赖 __dict__ 或直接遍历 __slots__
print(asdict(event))
print([field.name for field in fields(event)])

try:
    event.debug_label = "temporary"  # 未声明的动态属性在 slots 模型中不可用
except AttributeError as exc:
    print(f"动态属性被拒绝: {exc}")
如果现有代码使用 vars(obj)、obj.__dict__.copy() 或 ORM/序列化框架直接扫描实例字典,应先改为 dataclasses.fields()、asdict(),或使用框架明确支持 dataclass 的接口。不要用 __slots__ 自己枚举字段:继承场景中,父类已有槽位不会重复写入子类生成的 __slots__,官方建议用 fields() 获取 dataclass 字段。
集成时重点检查三个兼容边界
| 边界 | 可能表现 | 处理建议 |
|---|---|---|
| 动态属性 | 给未声明名称赋值时抛出 AttributeError | 把稳定属性声明为字段;真正依赖动态扩展的模型不要启用 slots |
| 弱引用 | 默认 slotted 实例不能作为 weakref.ref 目标 | Python 3.11+ 使用 @dataclass(slots=True, weakref_slot=True) |
| 继承 | 继承自非 slotted 父类后实例仍可能拥有 __dict__ | 检查完整继承链;不要只看最末端类的装饰器 |
| 手写槽位 | 类已定义 __slots__ 时再传 slots=True 会报 TypeError | 让 dataclass 生成槽位,或完整地手工管理,两种方案不要叠加 |
需要弱引用时,可以单独定义下面的模型。weakref_slot=True 会加入 __weakref__ 槽位,它必须与 slots=True 一起使用,并且要求 Python 3.11 或更高版本。
from dataclasses import dataclass
from weakref import ref


@dataclass(slots=True, weakref_slot=True)
class CachedEvent:
    event_id: int
    value: int


event = CachedEvent(10, 99)
event_ref = ref(event)  # weakref_slot 为实例提供弱引用支持
assert event_ref() is event  # 确认弱引用能返回当前存活对象
验收:决定哪些模型值得改造
完成代码后,按以下结果判断是否值得上线:批量实例的 current 内存应在同一解释器中稳定下降;业务校验值必须一致;项目测试不再访问 __dict__ 或追加动态属性;需要弱引用和继承的模型要单独覆盖测试。最后在接近真实对象数量和字段值分布的压测中复测,不要只凭三字段示例推算生产节省量。
实际项目通常不必把所有 dataclass 一次性改成 slots。优先处理缓存条目、解析结果、坐标点、事件记录等高基数对象;配置对象、插件上下文和需要动态扩展的模型保留普通 dataclass,往往更稳妥。
相关问题
slots=True 会让 dataclass 变成不可变对象吗? 不会。字段仍可赋值;需要模拟只读语义时应另用 frozen=True,它解决的是修改限制,不是同一个问题。
为什么启用 slots 后节省不明显? 可能是实例数量太少、字段值引用的大对象占主导,或者父类仍提供 __dict__。应看完整对象图和真实负载,而不是只检查装饰器。
slots=True 会不会自动加速所有代码? 官方数据模型说明属性查找可能改善,但业务速度仍由算法、I/O、容器和调用模式决定。本文的主要目标是降低大量固定字段实例的内存,不应把它宣传成通用性能开关。
-
132 收藏
-
文章 · python教程 | 5小时前 | 并发 · 异常处理 · python · asyncio · CancelledError 结构化并发 ExceptionGroup Python asyncio TaskGroup asyncio gather246 收藏
-
337 收藏
-
359 收藏
-
325 收藏
-
176 收藏
-
130 收藏
-
437 收藏
-
487 收藏
-
104 收藏
-
307 收藏
-
438 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习