
生成器处理百万行 CSV:内存、编码与异常行策略
来源:17golang原创
时间:2026-10-07 13:58:57 284浏览 收藏
PHP 处理百万行 CSV,稳定方案可以概括为一种模式:流式读取 + 单行规范化 + 异常旁路。生成器负责一次只交付一行,编码转换和字段校验只作用于当前行,错误则作为结构化结果交给调用方。这样内存占用主要由“当前行、当前批次和调用方状态”决定,而不是由 CSV 总行数决定。
官方文档:https://www.php.net/manual/en/language.generators.overview.php
- 用
fgetcsv()从文件句柄逐条解析,不用file()读取整个文件。 - 显式传入
escape: '',避免依赖 PHP 8.4 起已弃用的默认值。 - 源编码由导入契约给出,整行转换一次;不要对百万行逐行猜编码。
- 异常行保留行号、错误码和字段,不要静默跳过,也不要无限堆进内存。
把模式拆成三个边界
这个模式不是“用了 yield 就结束”。第一层是输入边界:文件句柄与 fgetcsv() 只保留当前记录。第二层是行处理边界:BOM、编码、列数和字段值都在当前行完成。第三层是消费边界:调用方可以逐条写库,也可以组成固定大小批次,但不能重新把所有结果收集成大数组。
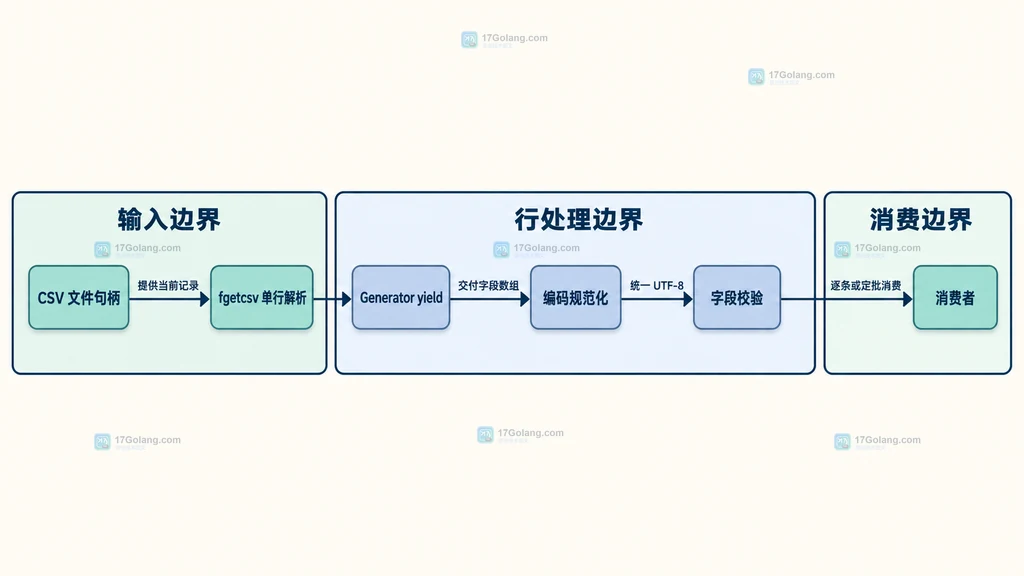
PHP 官方说明指出,Generator 可以向 foreach 提供数据而无需预先在内存中构造完整数组。不过它不保证调用方节省内存:如果后面调用 iterator_to_array(),或把每条记录继续追加到一个数组,内存仍会随行数增长。
先写一个只负责读取的最小生成器
fgetcsv() 会从文件指针读取并解析 CSV 字段。PHP 8.4 起,依赖 escape 的默认值已被弃用;官方还建议显式使用空字符串来关闭专有转义机制。下面把分隔符、包围符和转义策略写清楚,并用 try/finally 保证消费者提前结束遍历时也能释放文件句柄。
 */
function csvRecords(string $path): Generator
{
    $handle = fopen($path, 'rb');
    if ($handle === false) {
        throw new RuntimeException("无法打开 CSV:{$path}");
    }

    try {
        $line = 0;
        while (($fields = fgetcsv(
            $handle,
            length: null,
            separator: ',',
            enclosure: '"',
            escape: '' // 显式关闭专有转义,避免依赖默认值
        )) !== false) {
            ++$line;
            yield $line => ['line' => $line, 'fields' => $fields];
        }
    } finally {
        // 无论正常结束还是提前停止,都关闭文件句柄
        fclose($handle);
    }
}
length: null 表示不人为限制最长记录。它更适合字段长度不固定的导入;如果业务可以给出可信上限,也可设置上限并对超长记录单独拒绝。还要注意,CSV 的引号字段可能跨物理行,因此不要用 fgets() 加 explode(',') 代替 CSV 解析器。
编码只在输入边界转换一次
最可靠的做法是让上传方或任务配置明确源编码,例如 UTF-8、GB18030 或 Windows-1252。编码探测只能作为辅助,因为短文本和纯 ASCII 样本可能同时符合多种编码。对百万行逐行调用探测函数还会增加不必要的 CPU 开销。
下面的规范化函数先处理第一行首字段的 UTF-8 BOM,再验证或转换字段。mb_check_encoding() 用于检查字节串是否符合指定编码,mb_convert_encoding() 按已经确定的源编码转换。
 $value) {
        $value = (string) $value;
        if (!mb_check_encoding($value, $sourceEncoding)) {
            throw new UnexpectedValueException("第 {$line} 行第 {$index} 列编码无效");
        }

        $fields[$index] = $sourceEncoding === 'UTF-8'
            ? $value
            : mb_convert_encoding($value, 'UTF-8', $sourceEncoding);
    }

    return $fields;
}
如果来源无法保证编码,可以在正式读取前对文件开头的一段样本做一次候选编码判断,并把候选限定在业务允许的集合里;结果仍应写入任务元数据,不能让后续每行自行改变判断。
异常行不要抛进黑洞,改成统一结果结构
大文件导入通常不应该因为一条坏数据就丢弃全部进度,也不能把错误吞掉。可以让生成器统一产出 ok、line、data、error 和 fields。调用方据此把正常行写入业务表,把异常行写入有上限的错误文件或错误表。
 */
function validatedCsv(string $path, array $headers, string $sourceEncoding): Generator
{
    foreach (csvRecords($path) as $record) {
        $line = $record['line'];
        $fields = $record['fields'];

        try {
            $fields = normalizeFields($fields, $line, $sourceEncoding);

            // fgetcsv 将空白行表示为只有一个 null 字段的数组
            if ($fields === [null] || $fields === ['']) {
                yield $line => ['ok' => false, 'line' => $line, 'error' => 'empty_row', 'fields' => $fields];
                continue;
            }

            if (count($fields) !== count($headers)) {
                yield $line => ['ok' => false, 'line' => $line, 'error' => 'column_count', 'fields' => $fields];
                continue;
            }

            yield $line => ['ok' => true, 'line' => $line, 'data' => array_combine($headers, $fields), 'error' => null];
        } catch (UnexpectedValueException $exception) {
            // 保留行号和错误类型,便于单独修复源数据
            yield $line => ['ok' => false, 'line' => $line, 'error' => 'encoding', 'message' => $exception->getMessage(), 'fields' => $fields];
        }
    }
}
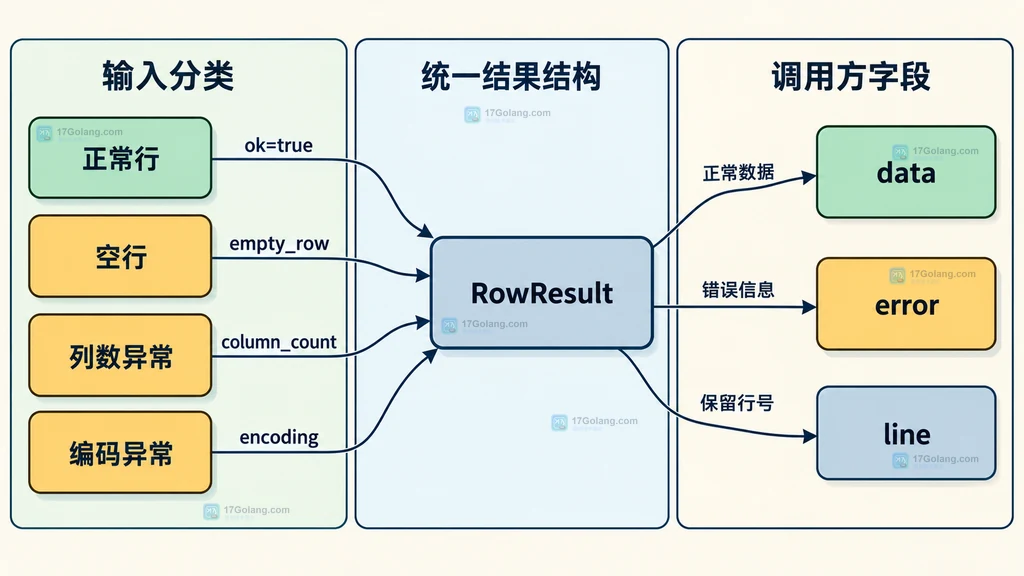
消费者决定最终内存上限
下面的消费者一次只累计 500 条正常记录,批量写入后立即清空;异常记录也应即时写出,而不是无限保存在 $errors 中。
批次大小不是越大越好。它要同时考虑数据库参数上限、事务时间、失败重试成本和单行宽度。500 只是示例;宽表或大文本字段可能需要更小批次。
四个常见反例及其后果
| 反例 | 后果 | 替代方案 |
|---|---|---|
file($path) 后再遍历 | 先把整个文件装入数组 | fopen + fgetcsv + yield |
iterator_to_array($generator) | 重新把全部结果收集到内存 | 直接 foreach 消费 |
| 每行调用编码探测 | 耗时增加且判断可能漂移 | 一次确定源编码,逐行验证和转换 |
| 把全部错误追加到数组 | 坏数据多时仍会吃满内存 | 流式写错误表,并设置失败阈值 |
什么时候应该停止整批任务
异常旁路不等于永远继续。建议至少设置三个阈值:连续异常行上限、总异常比例上限和单行字段大小上限。连续数百行列数都不对,通常意味着分隔符或编码契约选错;此时继续导入只会制造更多无效记录。阈值触发后停止任务,但保留已经写入的审计信息和最后成功行号。
落地判断清单
- 文件是否通过
fopen('rb')打开,并在finally中关闭? fgetcsv()是否显式指定分隔符、包围符和空escape?- 源编码是否来自导入契约,而不是每行重新猜测?
- 首行 BOM、空行、列数错误和字段校验失败是否都有明确错误码?
- 正常记录是否按固定批次写入,写入后立即清空?
- 错误记录是否流式落盘,并设置异常比例或连续失败阈值?
- 调用链中是否没有
file()、iterator_to_array()或全量数组收集?
常见问题
Generator 能保证百万行 CSV 一定不爆内存吗?
不能。它避免预先构造全量数组,但消费者、数据库批次、错误集合和日志缓冲仍可能增长。必须检查整条调用链。
为什么不直接用 fgets 再 explode?
CSV 包围字段可能包含分隔符、双引号甚至换行,简单分割会破坏字段边界。应使用 fgetcsv() 或兼容同一 CSV 契约的解析器。
编码可以用 mb_detect_encoding 自动解决吗?
不建议把探测当作唯一真相。优先让来源明确编码;必须探测时,只对样本做一次,并限制候选编码集合。
异常行该跳过还是停止?
单个业务字段错误可以旁路;连续列数错误、异常比例突然升高或单行超限,通常说明文件契约错误,应该停止整批任务。
最终要守住的不是某个函数,而是三个边界:文件句柄只提供当前记录,规范化只修改当前行,消费者只保留固定批次。Generator 是把这些边界连接起来的工具,而不是替调用方自动完成内存治理。
-
361 收藏
-
361 收藏
-
371 收藏
-
347 收藏
-
112 收藏
-
413 收藏
-
135 收藏
-
246 收藏
-
162 收藏
-
417 收藏
-
104 收藏
-
217 收藏
-
105 收藏
-
460 收藏
-
260 收藏
-
481 收藏
-
136 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习