
Geo 附近搜索如何加入距离排序与业务过滤
来源:17golang原创
时间:2026-10-08 21:13:51 410浏览 收藏
Redis GEO 做附近搜索时,距离排序和业务过滤要拆成两个职责:先用 GEOSEARCH ... ASC WITHDIST 取得按距离升序的空间候选,再批量读取这些成员对应的业务元数据,按营业状态、分类、库存或租户条件过滤,并始终沿用候选原顺序。不要先过滤后重新按成员名排序,也不要在要求“最近优先”时随手添加 COUNT ... ANY。
官方命令文档:https://redis.io/docs/latest/commands/geosearch/
地理数据类型说明:https://redis.io/docs/latest/develop/data-types/geospatial/
我第一次把 GEO 用到门店列表时,最不适应的不是经纬度,而是它只认识成员和坐标。门店是否营业、属于什么品类、是否有库存,都不是 GEO 命令的过滤字段。硬把所有条件塞进成员字符串,后面更新和统计都很痛苦。更稳的模型是让空间索引只保存稳定 ID,让业务属性留在 Hash 或其他索引中。
旧写法的问题:找到附近不等于找到可用结果
假设用户需要“5 公里内仍在营业、有库存的咖啡店,按距离从近到远取 10 家”。单条 GEOSEARCH 可以完成半径、数量和距离顺序,但 Redis GEO 数据类型本身没有 status=open、category=coffee 或 stock>0 这类复合业务过滤语法。
# GEO 集合只保存稳定门店 ID 与经纬度。
GEOADD poi:geo 121.4737 31.2304 1001 121.4800 31.2260 1002 121.4580 31.2190 1003

# 每个 Hash 保存会频繁变化的业务属性。
HSET poi:1001 status open category coffee stock 12 tenant t1
HSET poi:1002 status closed category coffee stock 8 tenant t1
HSET poi:1003 status open category bakery stock 5 tenant t1
这里让 GEO 成员直接等于业务主键,避免在空间结果和业务记录之间再做一层不稳定映射。坐标变化时更新 GEOADD,营业状态或库存变化时更新 Hash,两者互不覆盖。
常见的旧写法是先只取 10 个最近成员,再逐个 HGETALL,过滤完可能只剩 2 个;如果再补查下一批,不但会出现 N+1 往返,还容易打乱距离顺序。真正的问题不是命令少一个过滤参数,而是空间候选数量与最终页面条数被误当成同一件事。
新模型:空间候选与业务资格各管一件事
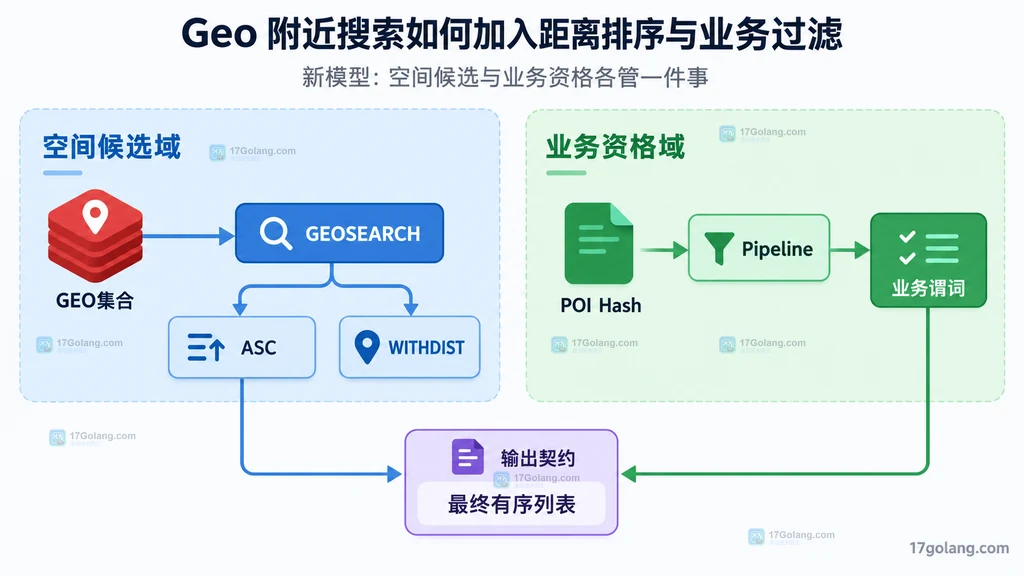
空间域负责回答“哪些对象在范围内、离中心多远”,业务域负责回答“这个对象当前是否有资格展示”。两边通过同一个 ID 关联,输出契约则要求:距离值来自 GEO,业务字段来自 Hash,最终列表保留 GEO 的 ASC 顺序。
# 从用户坐标搜索 5 公里内候选,按距离升序并返回距离。
GEOSEARCH poi:geo \
  FROMLONLAT 121.4700 31.2300 \
  BYRADIUS 5 km \
  ASC COUNT 50 WITHDIST
ASC 表示从近到远,WITHDIST 让每个候选带回距离,单位与 BYRADIUS 中使用的单位一致。COUNT 50 不是最终页面条数,而是为后续业务过滤准备的候选上限。
如果搜索中心来自一个已有成员,可把 FROMLONLAT 换成 FROMMEMBER member;范围也可以用 BYBOX 表达矩形。两组参数各自互斥:中心只能二选一,形状也只能二选一。
Go 中用 Pipeline 批量读取并保持顺序
下面示例使用 github.com/redis/go-redis/v9。关键不是某个客户端方法,而是数据流:先拿到有序 []GeoLocation,再对这些 ID 建立 Pipeline,最后仍按原切片顺序读取结果并过滤。
Go 客户端文档:https://pkg.go.dev/github.com/redis/go-redis/v9
package nearby

import (
    "context"
    "fmt"
    "strconv"

    "github.com/redis/go-redis/v9"
)

type Place struct {
    ID       string
    Distance float64
    Category string
    Stock    int
}

func SearchCoffee(
    ctx context.Context,
    rdb *redis.Client,
    longitude, latitude float64,
    finalLimit int,
) ([]Place, error) {
    // 多取一批空间候选,为营业状态和库存过滤预留余量。
    candidateLimit := finalLimit * 5
    candidates, err := rdb.GeoSearchLocation(ctx, "poi:geo", &redis.GeoSearchLocationQuery{
        GeoSearchQuery: redis.GeoSearchQuery{
            Longitude:   longitude,
            Latitude:    latitude,
            Radius:      5,
            RadiusUnit:  "km",
            Sort:        "ASC",
            Count:       candidateLimit,
            CountAny:    false, // 严格最近优先时不要启用 ANY。
        },
        WithDist: true,
    }).Result()
    if err != nil {
        return nil, fmt.Errorf("查询附近候选失败: %w", err)
    }

    pipe := rdb.Pipeline()
    attrs := make([]*redis.MapStringStringCmd, len(candidates))
    for i, candidate := range candidates {
        // Pipeline 合并网络往返,但不改变 candidates 的距离顺序。
        attrs[i] = pipe.HGetAll(ctx, "poi:"+candidate.Name)
    }
    if _, err := pipe.Exec(ctx); err != nil {
        return nil, fmt.Errorf("批量读取门店属性失败: %w", err)
    }

    result := make([]Place, 0, finalLimit)
    for i, candidate := range candidates {
        meta := attrs[i].Val()
        // 按原候选顺序过滤,保留 GEOSEARCH 的 ASC 语义。
        if meta["status"] != "open" || meta["category"] != "coffee" {
            continue
        }
        stock, err := strconv.Atoi(meta["stock"])
        if err != nil || stock
这个写法有三个直接收益。第一,业务字段可以独立更新,不必重建坐标。第二,Pipeline 把几十次 Hash 读取合并为一次网络批次。第三,应用层没有重新排序,距离相等之外的顺序仍与 Redis 返回一致。
需要注意,Pipeline 不是事务。它优化往返,并不保证 GEO 结果和随后读取的 Hash 处于同一瞬时快照。对门店营业状态这类允许短暂变化的数据通常可以接受;如果业务要求强一致,就需要重新界定数据模型和一致性成本,而不是把 Pipeline 当事务使用。
候选数量怎么定,为什么不要随手加 ANY
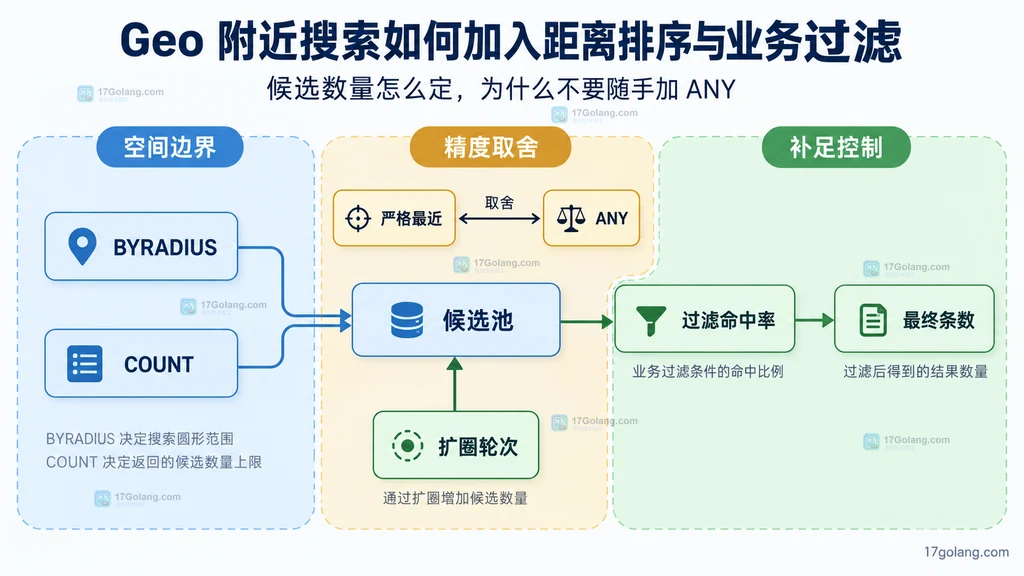
COUNT n 要求 Redis 最多返回 n 个匹配项;当不使用 ANY 时,为了找出范围内更合适的最近结果,Redis 需要投入与匹配规模和排序相关的工作。ANY 会在找到足够匹配项后尽早返回,服务器工作更少,但结果可能不是离中心最近的那一批。
因此,“附近推荐只要大致结果”和“最近门店必须严格排序”是两个不同产品语义。前者可以评估 ANY,后者应保持 CountAny: false。这不是单纯性能开关,而是结果质量开关。
候选倍数可以从历史过滤命中率反推。若最终要 10 条,符合业务条件的比例约为 40%,理论候选数至少需要 25;考虑分布波动,可以先取 40 到 50 条。不要无限放大,候选过多会增加排序、网络响应和 Hash 读取成本。
| 现象 | 调整方向 | 不要做什么 |
|---|---|---|
| 过滤后经常不足 | 提高候选倍数,或有限扩大半径 | 直接取消所有上限 |
| 业务命中率稳定 | 按命中率动态计算 COUNT | 永久写死一个过大的倍数 |
| 必须严格最近 | ASC 且不使用 ANY | 为省时打开 ANY 后仍声称严格最近 |
| 只要近似推荐 | 评估 COUNT ANY | 忽略产品对顺序的真实要求 |
如果一次候选过滤后不足,可以设计有上限的补足策略:先增加候选数,再适度扩大半径,最多执行固定轮次;每轮都去重,并继续按距离合并。终止条件应包括最终条数已满足、达到最大半径、达到最大候选数或达到最大轮次,避免热门区域和稀疏区域都陷入无边界查询。
业务过滤越来越复杂时,别让应用层无限膨胀
GEO 数据类型适合“坐标 + 简单成员”的附近查找。如果过滤条件逐渐扩展到多个标签、价格区间、评分、营业时间、权限和全文字段,应用层过量召回会越来越浪费。这时应该评估 Redis Query Engine 的 GEO 字段,把位置与可检索属性放进同一索引查询。
Redis Query Engine 地理字段说明:https://redis.io/docs/latest/develop/interact/search-and-query/advanced-concepts/geo/
两种能力不要混为一谈:Redis Geospatial 数据类型提供简单坐标索引和半径/矩形搜索;Redis Query Engine 可以索引 Hash 或 JSON 中的地理字段,并与标签、数值等查询条件组合。是否迁移取决于过滤复杂度、数据规模、部署能力和运维成本。
兼容与落地时要留意的边界
GEOSEARCH从 Redis 6.2 起提供。较旧环境要先确认命令支持,再决定是否保留旧命令兼容层。WITHDIST返回的距离单位与半径单位相同;接口字段和前端展示应明确单位,避免把公里当米。- 成员 ID 应稳定且唯一,不要把经常变化的状态拼进成员字符串。
- 删除业务对象时,要同时清理 GEO 成员和业务元数据;读取阶段也应容忍 Hash 已不存在。
- 多租户数据可以按租户拆 GEO key,减少无效候选;如果共用 key,应用层必须把租户条件作为强制谓词。
- 大范围查询即使最终只取少量结果,也可能需要更多筛选和排序工作,应限制最大半径与最大 COUNT。
我的采用建议
对门店、网点、充电桩、骑手或设备这类中等规模的附近列表,我会先采用“GEOSEARCH + Hash + Pipeline”:结构简单、更新清晰,也容易解释距离顺序。页面只要 10 条时,先根据真实命中率做 3 到 5 倍过量召回,再用指标观察候选数、过滤后条数、补足轮次和查询耗时。
如果业务过滤只是状态和一两个分类,这套方案通常够用;如果条件快速增长,或者大量候选总在应用层被丢弃,就不要继续堆倍数,应转向能够组合 GEO 与属性过滤的查询索引。真正需要优化的不是“少写一个命令”,而是让空间检索、业务资格和结果排序各自拥有清楚的职责。
相关问题
WITHDIST 会自动按距离排序吗
不会。WITHDIST 只要求返回距离;要从近到远必须显式加 ASC。
COUNT 10 为什么过滤后不足 10 条
因为 COUNT 限制的是空间候选,不是业务过滤后的最终条数。应按命中率过量召回,并设置有限补足策略。
可以把状态写进 GEO member 吗
技术上可以拼字符串,但状态一变就需要更换成员,容易制造重复和清理问题。通常应让成员保持稳定 ID,把状态放在独立业务记录中。
-
117 收藏
-
426 收藏
-
171 收藏
-
113 收藏
-
195 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习