
iter.Seq 如何惰性遍历数据库分页结果
来源:17golang原创
时间:2026-10-09 11:51:08 398浏览 收藏
可以。做法是让 iter.Seq 返回“查询配方”,把真正的 QueryContext 放在迭代函数内部,并用上一页最后一个主键作为下一页游标。调用方开始 range 时才查第一页;调用方提前 break 后,yield 会返回 false,迭代器立即结束,因此不会再查询后续页面。
我第一次改这类代码时,最大的误区是把“返回一个 Seq”和“已经实现惰性”画了等号。其实,如果创建 Seq 之前就把所有页面查进切片,外层语法再漂亮也只是延迟消费,不是延迟查询。真正需要控制的是查询发生的位置、每页游标和资源释放。
iter 官方文档:https://pkg.go.dev/iter
database/sql 官方文档:https://pkg.go.dev/database/sql
Go 官方 range-over-function 说明:https://go.dev/blog/range-functions
iter.Seq 在这里解决的是什么
iter.Seq[V] 的类型是 func(yield func(V) bool)。迭代器把值交给 yield;只要调用方还想继续,yield 就返回 true。当调用方执行 break,它会返回 false,迭代器实现必须停止生产数据并返回。
这很适合包装分页读取,因为数据库查询天然可以分批发生。与“先查完再返回 []User”相比,页级 Seq 有三个直接收益:
- 调用方不遍历,数据库就不会收到查询;
- 内存只需要容纳当前页,而不是完整结果集;
- 调用方拿到足够数据后可以停止,后续页不会白查。
不过要先说清一个边界:本文实现的是页面级惰性。每次查询仍会把一整页扫描到切片,再把这一页交给调用方,内存量级是 O(pageSize)。如果业务要求每一行都立即交付,可以把元素类型改成单行结果,但那会让 sql.Rows 在 yield 期间保持打开,资源管理会更敏感。
把查询放进 Seq,惰性才真正成立
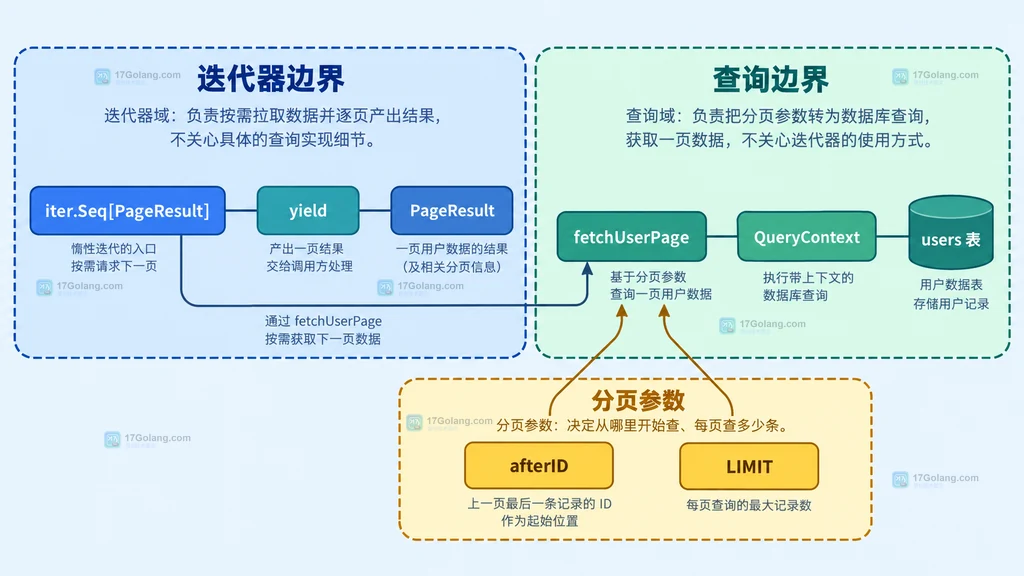
我更愿意让 Seq 产出一个明确的页结果,而不是隐藏错误。因为 iter.Seq 只有一个元素类型,可以定义 PageResult[T],其中要么有 Items,要么有 Err。发生错误时产出一次错误结果,随后立即结束。
package pager

import (
    "context"
    "database/sql"
    "fmt"
    "iter"
)

type User struct {
    ID   int64
    Name string
}

type PageResult[T any] struct {
    Items []T
    Err   error
}

func UserPages(
    ctx context.Context,
    db *sql.DB,
    pageSize int,
) iter.Seq[PageResult[User]] {
    return func(yield func(PageResult[User]) bool) {
        // 参数错误也通过序列返回,避免创建 Seq 时提前访问数据库
        if pageSize
这里最关键的不是泛型,而是 fetchUserPage 的调用位置。UserPages 被调用时只创建一个函数值;等到调用方对这个函数执行 range,迭代函数才开始运行。每次成功交付一页后,再用该页最后一个 ID 更新 afterID。
用稳定游标替代越来越大的 OFFSET
分页 SQL 使用递增、唯一且有索引的主键。以下写法采用 MySQL 风格的 ? 占位符;如果使用 PostgreSQL,需要按驱动改成 $1、$2。
func fetchUserPage(
    ctx context.Context,
    db *sql.DB,
    afterID int64,
    pageSize int,
) ([]User, error) {
    const query = `
        SELECT id, name
        FROM users
        WHERE id > ?
        ORDER BY id ASC
        LIMIT ?`

    // QueryContext 让请求取消或超时能够传递到数据库驱动
    rows, err := db.QueryContext(ctx, query, afterID, pageSize)
    if err != nil {
        return nil, fmt.Errorf("查询用户分页失败: %w", err)
    }
    defer rows.Close()

    users := make([]User, 0, pageSize)
    for rows.Next() {
        var user User
        // 每次 Next 成功后再 Scan,列顺序必须与 SELECT 保持一致
        if err := rows.Scan(&user.ID, &user.Name); err != nil {
            return nil, fmt.Errorf("扫描用户记录失败: %w", err)
        }
        users = append(users, user)
    }

    // Next 返回 false 既可能是正常结束,也可能是迭代错误
    if err := rows.Err(); err != nil {
        return nil, fmt.Errorf("遍历用户记录失败: %w", err)
    }
    return users, nil
}
database/sql 文档要求每次 Scan 前先调用 Next,并在遍历结束后检查 Rows.Err。当 Next 正常走到最终结果集末尾时,Rows 会自动关闭;这里仍然保留 defer rows.Close(),因为扫描错误、提前返回等分支也需要及时归还连接资源,而且 Close 是幂等的。
对应 SQL 的关键不是语法复杂度,而是排序键契约:
-- 使用唯一递增主键作为游标,避免页边界出现相同排序值
SELECT id, name
FROM users
WHERE id > ?
ORDER BY id ASC
LIMIT ?;
如果排序字段不唯一,例如只按 created_at,同一时间戳的多条记录可能跨页重复或遗漏。应使用复合游标,例如 (created_at, id),查询条件与排序都写成同一组键。
调用方怎样消费页面和错误
调用方只需要遍历 Seq。下面的例子最多处理 120 条记录;一旦达到目标就退出,因此不会为了凑完整结果集继续访问数据库。
func consumeUsers(ctx context.Context, db *sql.DB) error {
    processed := 0

    // 每次循环收到一页,页面大小决定单次查询和内存上限
    for result := range UserPages(ctx, db, 50) {
        if result.Err != nil {
            return result.Err
        }

        for _, user := range result.Items {
            // 这里替换为真实业务处理,并把失败返回给上层
            if err := handleUser(ctx, user); err != nil {
                return err
            }
            processed++
            if processed >= 120 {
                // break 只结束内层循环,所以用 return 结束整个消费函数
                return nil
            }
        }
    }
    return nil
}
这个例子特意使用 return,因为普通 break 只会跳出最内层的用户循环,外层分页循环还会继续。如果消费逻辑只有一层 for result := range ...,直接 break 就会让 Seq 的 yield 返回 false。
提前 break 时,后续页面为什么不会再查
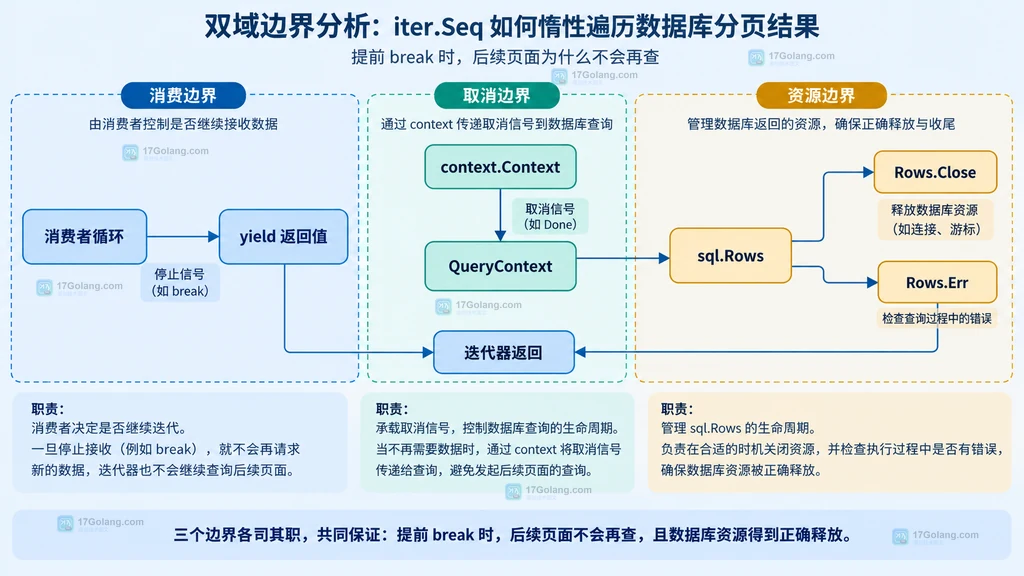
range-over-function 的关键约定是:调用方不再需要值时,传给 Seq 的 yield 会返回 false。所以生产者中必须写成 if !yield(v) { return },不能忽略返回值。忽略它不仅会多查页面,也违反了迭代器应当停止生产的约定。
本例把每页的 sql.Rows 完整读取并关闭后,才调用 yield。因此调用方处理数据时不会占着当前查询的 Rows,连接更容易归还到池里。代价是调用方即使只使用本页第一条记录,本页剩余记录也已经被扫描;但后续页面仍然没有查询。
context.Context 是另一条停止路径。请求超时或上游取消后,正在执行的 QueryContext 可以收到取消信号,具体取消行为取决于数据库与驱动。无论是 Query 返回错误,还是 Rows 迭代期间出现错误,代码都把错误装入一个 PageResult 后结束 Seq。
常见写法为什么不够惰性
| 写法 | 问题 | 更合适的做法 |
|---|---|---|
| 创建 Seq 前查完全部页面 | 只是延迟消费,查询和内存都不惰性 | 把 QueryContext 放进 Seq 函数体 |
| 使用 OFFSET 不断翻页 | 页码越大,数据库可能需要跳过越多记录 | 使用有索引的稳定 keyset 游标 |
| 忽略 yield 的 bool 返回值 | 调用方退出后生产者仍可能继续查询 | 每次 yield 后立即判断并 return |
| 只判断 rows.Next,不检查 rows.Err | 无法区分正常结束与驱动迭代错误 | 循环后检查 Rows.Err |
| 把数据库错误写日志后吞掉 | 调用方可能误以为结果已经完整 | 通过 PageResult 或 Seq2 显式传递错误 |
另一个常见问题是复用同一个 Seq。Go 官方文档说明迭代器通常应允许多次遍历,但也存在只能单次使用的序列。本文的 UserPages 每次遍历都会从 afterID=0 开始并重新查询数据库,所以技术上可以重复遍历;但每次看到的是当时数据库状态,不保证两次结果相同。
并发写入时要接受哪些边界
普通 keyset 分页保证的是按游标向前推进,不是跨多次查询的固定快照。遍历期间如果有新记录插入,ID 大于当前游标的记录可能在后续页出现;记录被删除后自然不会出现;如果排序键会被更新,记录还可能移动到游标前后。
我会按业务要求选方案:
- 允许读取“前进中的当前数据”:直接使用普通 keyset,成本最低;
- 必须固定上界:开始时先记录最大 ID,后续查询增加
id ; - 必须获得一致快照:在数据库能力和隔离级别允许时,用只读事务包住整个遍历,并评估长事务对连接池、MVCC 和清理的影响;
- 需要跨请求续传:不要隐藏游标,改成显式分页 API,把最后键编码成可持久化游标。
尤其要注意,长时间持有事务会占用连接并扩大数据库侧成本。iter.Seq 只改善 Go 调用接口,不会自动解决数据库快照、锁、隔离级别或连接池容量问题。
什么时候我会选择 Seq,什么时候不会
当分页只在一个函数调用内完成、消费端天然用 for range、并且提前停止很常见时,我会选择 iter.Seq。它让“需要多少就取多少”的意图很直接,也能把游标更新和 Rows 清理集中在一个实现里。
如果调用方需要把游标保存到消息队列、HTTP 响应或定时任务状态中,我会使用显式的 FetchPage(cursor) API。若错误本身是主要控制信号,也可以考虑 iter.Seq2[T, error],按行产出值与错误。接口形式应服从资源生命周期,而不是为了使用新语法强行套 Seq。
相关问题
能不能直接返回 iter.Seq[User]?
可以,但要决定错误怎样传递。常见做法是使用 iter.Seq2[User, error],或像本文一样让 iter.Seq 的元素是带错误字段的结果对象。
pageSize 应该设置多大?
没有统一答案。需要结合单行大小、数据库往返延迟、连接占用时间和消费速度压测。先选一个保守值,再观察每页延迟与进程内存,而不是追求页数最少。
为什么不在 Seq 外面 defer rows.Close?
因为每一页都有独立的 Rows,而且资源应在该页扫描完成后立即关闭。把单页查询封装进辅助函数,能让 defer rows.Close() 在每次辅助函数返回时生效,不会堆积到整个分页结束。
调用方 break 后当前 SQL 一定会被取消吗?
本文在 yield 前已经完成当前页查询并关闭 Rows,所以 break 影响的是后续页。若采用逐行 yield、当前 Rows 仍然打开,迭代器返回路径必须关闭 Rows;是否能取消数据库中的进行中操作还取决于 Context、驱动和数据库能力。
-
417 收藏
-
467 收藏
-
107 收藏
-
276 收藏
-
258 收藏
-
483 收藏
-
118 收藏
-
242 收藏
-
444 收藏
-
117 收藏
-
315 收藏
-
316 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习