
Java Vector API 怎样批量计算浮点数组
来源:17golang原创
时间:2026-10-09 11:58:59 319浏览 收藏
批量计算两个 float[],最直接的 Vector API 写法是:用 FloatVector.SPECIES_PREFERRED 选择当前平台偏好的向量宽度,按 SPECIES.length() 个元素加载数组,执行逐 lane 运算,再写回输出数组。数组末尾不足一个向量的部分,可以用普通标量循环,也可以用 VectorMask。
下面以 out[i] = a[i] * scale + b[i] 为例。它足够简单,能把加载、计算、写回和尾部处理都讲清楚。Vector API 仍位于 jdk.incubator.vector 模块中,编译和运行都要显式添加模块;API 处于孵化阶段,升级 JDK 时应重新编译和回归测试。
OpenJDK JEP 508:https://openjdk.org/jeps/508
FloatVector 官方 API:https://docs.oracle.com/en/java/javase/27/docs/api/jdk.incubator.vector/jdk/incubator/vector/FloatVector.html
VectorSpecies 官方 API:https://docs.oracle.com/en/java/javase/27/docs/api/jdk.incubator.vector/jdk/incubator/vector/VectorSpecies.html
最小配方:加载、计算、写回
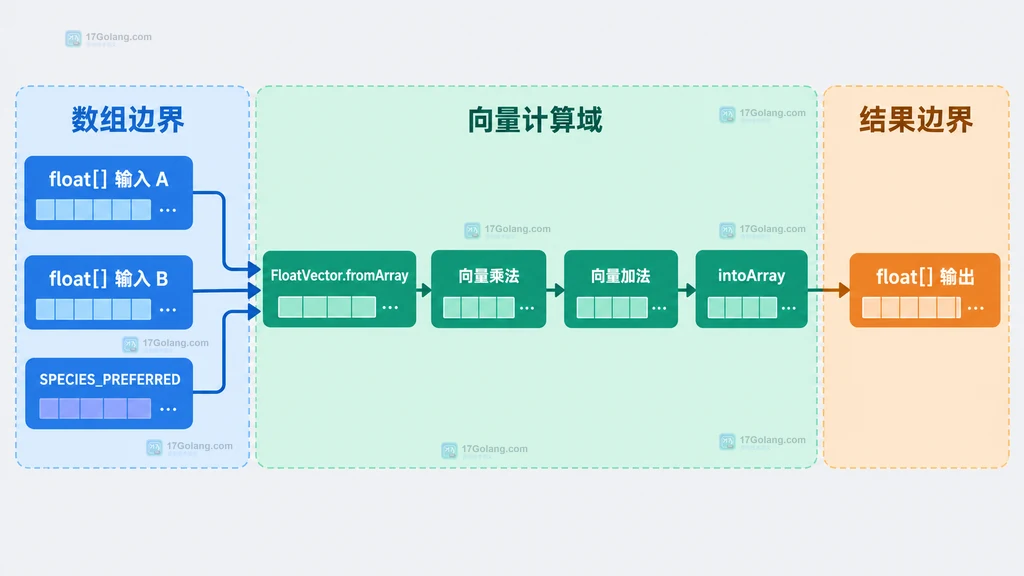
先看最小可用方法。SPECIES_PREFERRED 表示当前运行平台对 float 较合适的 species;它同时决定向量形状和 lane 数量。代码不要假设一定是 128、256 或 512 位,而应始终通过 species 查询长度。
import jdk.incubator.vector.FloatVector;
import jdk.incubator.vector.VectorSpecies;

public final class FloatBatch {
    // 保存为 static final,便于 JIT 针对稳定 species 优化热点代码
    private static final VectorSpecies SPECIES =
            FloatVector.SPECIES_PREFERRED;

    public static void scaleAdd(
            float[] a,
            float[] b,
            float scale,
            float[] out) {

        // 输入与输出长度必须一致,避免隐式截断或越界
        if (a.length != b.length || a.length != out.length) {
            throw new IllegalArgumentException("数组长度必须一致");
        }

        int i = 0;
        int upperBound = SPECIES.loopBound(a.length);

        // 完整向量区一次处理 SPECIES.length() 个 float
        for (; i
FloatVector.fromArray 从指定偏移量加载连续的 float 元素。mul(scale) 会把标量广播到各 lane 后逐 lane 相乘,add(vb) 再把相同 lane 位置的值相加,最后 intoArray 写回输出数组。
这里没有创建临时 float[]。Vector 对象是不可变的值式对象,方法会返回新的逻辑向量值;在热点代码中,JIT 有机会把这些操作映射到硬件 SIMD 指令并消除不必要的对象开销。是否真的得到性能收益,仍要以目标 CPU 和实际 JVM 的基准结果为准。
四个关键 API 怎么配合
| API | 作用 | 使用要点 |
|---|---|---|
SPECIES_PREFERRED | 取得平台偏好的 FloatVector species | 不要把 lane 数写死 |
SPECIES.length() | 返回当前 species 的 lane 数 | 作为循环步长 |
SPECIES.loopBound(length) | 返回不超过 length 的最大完整向量边界 | 保证无掩码加载不会越界 |
fromArray / intoArray | 在数组与向量之间加载、写回 | 偏移量以数组元素为单位 |
以 256 位的 FloatVector 为例,一个 float lane 是 32 位,因此一个向量有 8 个 lane。不过代码不应该依赖这个示例数字:同一份程序换到不同架构或 JVM 后,首选 species 可能不同。
数组长度不是 lane 整数倍怎么办
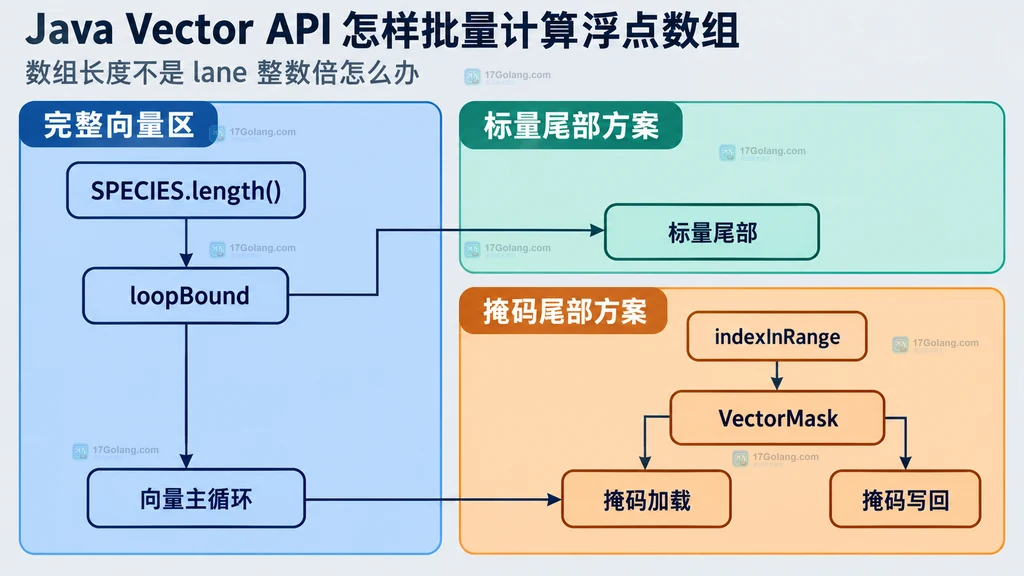
loopBound 把数组分成完整向量区和尾部。例如数组长度是 19、species 长度是 8,那么完整向量区到 16,最后 3 个元素交给尾部逻辑。最容易维护的写法就是前面的标量循环。
如果希望尾部也保持同一套向量表达式,可以用 indexInRange 创建掩码。掩码中只有仍位于数组范围内的 lane 会参与加载和写回。
import jdk.incubator.vector.FloatVector;
import jdk.incubator.vector.VectorMask;

public static void scaleAddMasked(
        float[] a,
        float[] b,
        float scale,
        float[] out) {

    // 先拒绝长度不一致,掩码只负责尾部,不负责修复输入契约
    if (a.length != b.length || a.length != out.length) {
        throw new IllegalArgumentException("数组长度必须一致");
    }

    int i = 0;
    int upperBound = SPECIES.loopBound(a.length);

    // 完整区仍使用无掩码操作,代码与常见热点路径保持简单
    for (; i  mask = SPECIES.indexInRange(i, a.length);
        FloatVector va = FloatVector.fromArray(SPECIES, a, i, mask);
        FloatVector vb = FloatVector.fromArray(SPECIES, b, i, mask);
        va.mul(scale).add(vb).intoArray(out, i, mask);
    }
}
标量尾部和掩码尾部都正确。前者直观,适合大多数数组计算;后者在表达式复杂、希望复用同一条向量公式时更整齐。不要仅凭“全程向量化”就判断掩码版本更快,尾部最多只有 SPECIES.length() - 1 个元素,额外的掩码构造和硬件支持差异可能让收益很小。
编译和运行要加 incubator 模块
假设完整类名为 FloatBatchDemo,编译与运行都要添加 jdk.incubator.vector。它是 incubator 模块,不等同于普通的 java.base API。
# 编译时把 Vector API 模块加入模块图
javac --add-modules jdk.incubator.vector FloatBatchDemo.java

# 运行时也必须添加同一个模块
java --add-modules jdk.incubator.vector FloatBatchDemo
如果使用 Maven 或 Gradle,编译任务、测试任务和生产启动参数都需要保持一致。只给 IDE 添加模块,而忘记 CI 或容器启动命令,是最常见的部署问题之一。
一个便于本地核对的入口可以同时计算向量版本和标量参考版本,再比较每个元素。浮点运算要注意舍入差异:如果换成 fma,融合乘加可能只进行一次舍入,结果与分开的乘法加法在少数输入上可能有细微差别。
import java.util.Arrays;

public static void main(String[] args) {
    float[] a = {1f, 2f, 3f, 4f, 5f, 6f, 7f, 8f, 9f, 10f};
    float[] b = {10f, 9f, 8f, 7f, 6f, 5f, 4f, 3f, 2f, 1f};
    float[] actual = new float[a.length];
    float[] expected = new float[a.length];

    // 向量版本与标量参考版本使用同一个表达式
    scaleAdd(a, b, 0.5f, actual);
    for (int i = 0; i
几个实用变体
只对一个数组做缩放
删除第二个数组的加载,把核心表达式改成 va.mul(scale) 即可。其余循环边界和尾部逻辑不变。
两个数组逐元素相乘
将表达式改成 va.mul(vb)。参与同一运算的向量必须使用相同 species,这样对应 lane 才有明确配对关系。
乘加改用 fma
可以构造缩放向量后调用 va.fma(scaleVector, vb)。融合乘加通常更贴近硬件指令,但浮点舍入语义与 mul().add() 可能不同,必须按业务容差验证。
原地写回输入数组
如果算法允许,out 可以与 a 指向同一个数组。每轮先完成当前向量加载再写回相同区间,因此简单逐块计算通常可行;一旦存在跨区间读取、重排或重叠偏移,就要重新分析别名影响。
兼容性和性能容易踩的坑
- API 仍在孵化:包名、模块参数和部分接口可能随 JDK 演进,升级时要重新编译。
- 不是所有平台都更快:官方文档明确说明,没有专用 SIMD 支持的平台仍能正确运行,但未必有特殊性能收益。
- 小数组可能不划算:方法调用、边界处理和预热成本可能抵消并行 lane 的收益。
- 内存带宽可能成为瓶颈:表达式很简单而数组很大时,搬运数据的成本可能比算术更重要。
- 标量循环也可能被自动向量化:HotSpot 已能优化部分简单循环,Vector API 的优势要通过对照基准确认。
- species 要稳定:官方文档建议把 species 放在
static final字段中,利于运行时编译器优化。
测量时建议使用 JMH,至少包含预热、多个 fork、不同数组长度和正确的结果消费。不要用一次 System.nanoTime() 就得出结论,也不要只测恰好是 lane 整数倍的数组。基准应同时保留标量版本、标量尾部向量版本和掩码尾部版本。
完整实现该怎么选
| 需求 | 推荐写法 |
|---|---|
| 先得到最清楚的可维护代码 | loopBound 加标量尾部 |
| 尾部也要复用复杂向量表达式 | indexInRange 加 VectorMask |
| 跨不同 CPU 部署 | SPECIES_PREFERRED,不要写死向量位宽 |
| 追求确定的吞吐提升 | 针对真实数据和目标机器做 JMH 对照 |
| 不能接受孵化 API 变动 | 保留标量实现或封装 Vector API 适配层 |
对大多数项目,第一版直接选择 SPECIES_PREFERRED + loopBound + 标量尾部 就够了。它的边界清楚、异常条件明确,也最容易与标量参考实现做逐元素比对。等基准确认尾部或表达式确实值得调整,再引入掩码或 fma。
相关问题
Vector API 会自动使用 AVX 或 NEON 吗?
在受支持的平台上,JIT 会尽力把向量操作映射到相应 SIMD 指令;具体指令、宽度和效果取决于 CPU、JVM 与操作类型,不能只从 Java 源码断言。
为什么不用固定的 SPECIES_256?
固定 species 适合明确针对某类硬件的代码。通用应用优先使用 SPECIES_PREFERRED,让同一份源码适配当前平台偏好的形状。
float[] 长度为零能运行吗?
可以。loopBound(0) 不会进入向量主循环,标量尾部也不会执行,输出仍是空数组。
怎样确认结果没有浮点误差问题?
先保留标量参考实现,对典型值、极值、NaN 和无穷大进行对照。若采用融合乘加或不同运算顺序,使用符合业务要求的绝对或相对误差,而不是只做位级相等判断。
-
479 收藏
-
337 收藏
-
128 收藏
-
149 收藏
-
202 收藏
-
418 收藏
-
435 收藏
-
308 收藏
-
265 收藏
-
370 收藏
-
457 收藏
-
278 收藏
-
文章 · java教程 | 19小时前 | Java · 异常处理 · AutoCloseable Java try-with-resources suppressed exception 关闭顺序 getSuppressed197 收藏
-
462 收藏
-
212 收藏
-
446 收藏
-
414 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习