
单次迭代器被重复 range 会发生什么
来源:17golang原创
时间:2026-10-09 12:22:24 270浏览 收藏
我第一次把一个基于 bufio.Scanner 的 iter.Seq 保存到变量里时,很自然地以为它和切片一样:第一次循环做预览,第二次循环再做正式处理。结果第二次 range 什么也没拿到。后来我才意识到,iter.Seq 只描述“怎样把值交给 yield”,并没有承诺数据源可以倒带。
单次迭代器完整消费后再次range,通常不会产生任何值;如果第一次提前停止,第二次调用可能从底层流的剩余位置继续。是否能从头再来,取决于迭代器实现和数据源,而不是iter.Seq这个类型本身。
同一个 Seq 类型,为什么会出现三种结果
Go 的标准定义很短:
type Seq[V any] func(yield func(V) bool)
每次 for v := range seq,本质上都会再次调用 seq,并传入一个新的 yield 函数。问题在于,seq 被调用时会不会重新创建读取状态。由此会出现三类表现:
- 可重复来源:每次调用都从切片、树或其他可重放容器重新开始,两次循环都能看到完整序列。
- 单次来源已耗尽:底层文件流、网络流或 Scanner 已经读到结尾,第二次循环没有值。
- 单次来源提前停止:第一次因
break停下,第二次调用可能接着读取尚未消费的数据,而不是重头开始。
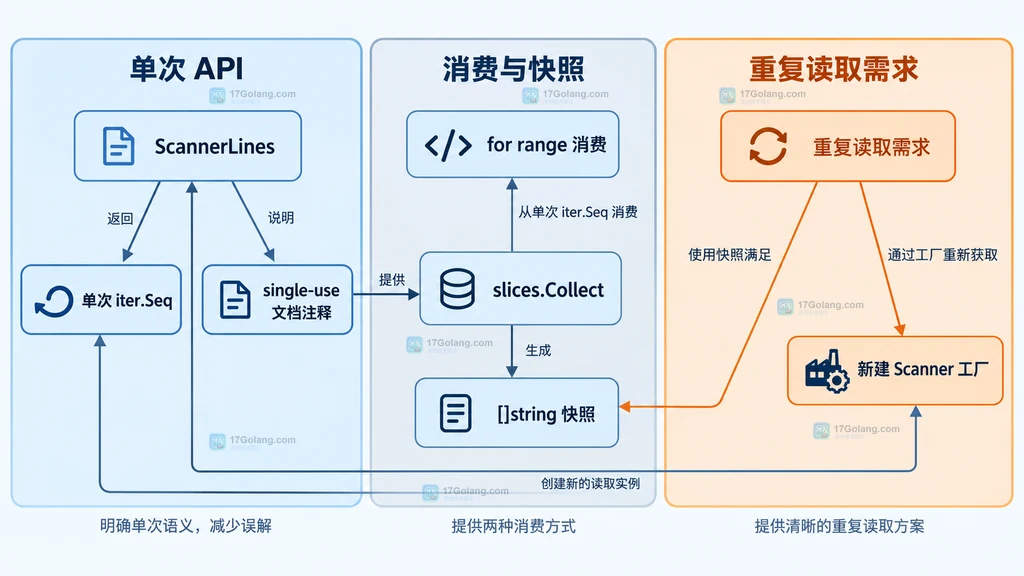
官方 iter 文档把后一类称为 single-use iterator。这不是异常,也不会因为重复 range 自动触发 panic;它只是说明这个序列背后的数据流不能可靠地回到起点。
切片迭代器为什么通常可以重复 range
先看一个我现在会放心重复使用的实现。关键不是它返回了 iter.Seq,而是遍历切片的状态位于迭代函数内部:
func Values[V any](items []V) iter.Seq[V] {
    return func(yield func(V) bool) {
        for _, item := range items {
            if !yield(item) {
                return
            }
        }
    }
}

seq := Values([]string{"alpha", "beta", "gamma"})

for v := range seq {
    fmt.Println("first:", v)
}

for v := range seq {
    fmt.Println("second:", v)
}
每次调用 seq 都会创建一个新的切片 range,所以两轮都会从下标 0 开始。即使第一轮提前 break,第二轮也仍从头遍历。这种“可重复”来自实现,而不是编译器为 Seq 提供了缓存。
不过它也不是数据快照。若两次循环之间修改了原切片,第二次看到的是修改后的内容。需要稳定快照时,应主动复制数据,而不是把“可重复调用”误解成“内容永远不变”。
Scanner 放在外面时,Seq 就只剩一次机会
下面这个封装看上去几乎一样,但读取状态保存在外部 Scanner 中。每次调用 seq,使用的仍是同一个 Scanner:
// ScannerLines returns lines from s.
// It returns a single-use iterator.
func ScannerLines(s *bufio.Scanner) iter.Seq[string] {
    return func(yield func(string) bool) {
        for s.Scan() {
            if !yield(s.Text()) {
                return
            }
        }
    }
}
如果第一轮一直读到 Scan 返回 false,Scanner 已经到达末尾,第二轮自然没有数据。如果第一轮读取一个值后就 break,yield 会返回 false,迭代器随即返回;下一次 range 再调用同一个序列时,Scanner 通常会继续扫描后面的行。
seq := ScannerLines(scanner)

for line := range seq {
    fmt.Println("preview:", line)
    break
}

// 这里可能从下一行继续,而不是重新输出第一行。
for line := range seq {
    fmt.Println("rest:", line)
}
我觉得最容易踩坑的地方就在这里:第二次循环不一定“总是空”,也不一定“总是重头开始”。官方文档使用“提前停止后再次调用可能继续数据流”的措辞,正是因为具体行为属于迭代器契约。调用方不应靠猜测来编写业务逻辑。
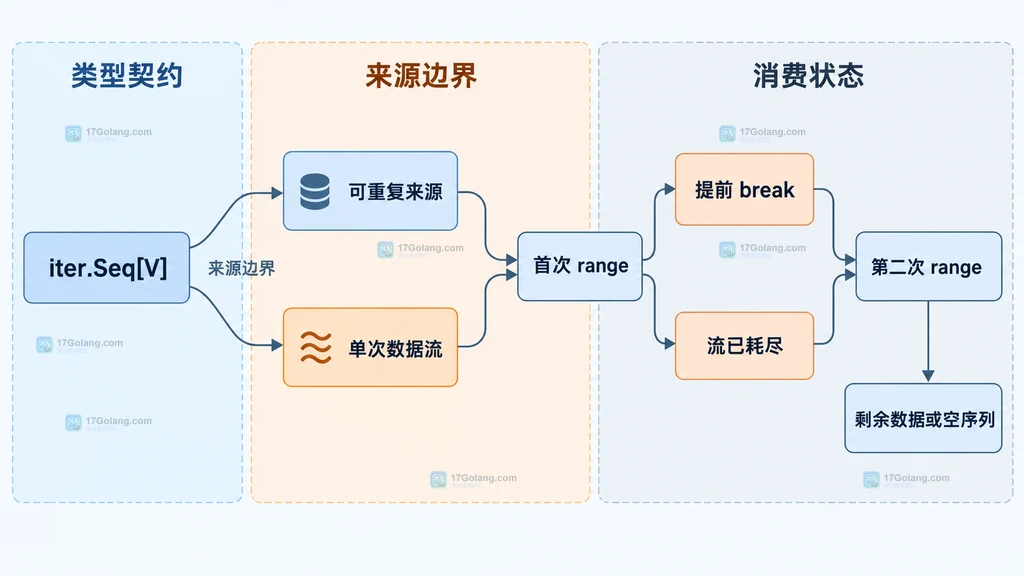
需要重复读取时,别让调用方猜
实际项目里,我会先问一个很具体的问题:第二个消费者需要的是同一批值,还是需要重新读取外部资源?答案不同,设计也不同。
数据量可控:先收集成快照
如果序列不大,最直接的做法是只消费单次迭代器一次,再重复遍历切片:
lines := slices.Collect(ScannerLines(scanner))

for _, line := range lines {
    inspect(line)
}

for _, line := range lines {
    process(line)
}
代价是额外内存,但语义最清楚。还要注意,slices.Collect 已经把单次序列消费掉了;收集之后应使用 lines,不要再期待原序列从头输出。
数据量较大:提供创建新数据源的工厂
如果文件很大,不适合全部放进内存,可以让每次遍历显式创建新的 Reader 或 Scanner。把“重新开始”设计成一个动作,比把它隐藏在共享状态里更安全:
func Lines(data []byte) iter.Seq[string] {
    return func(yield func(string) bool) {
        scanner := bufio.NewScanner(bytes.NewReader(data))
        for scanner.Scan() {
            if !yield(scanner.Text()) {
                return
            }
        }
    }
}
这里 Scanner 在每次调用迭代函数时创建,所以同一个 Seq 可以重新开始。如果真实来源是文件,则工厂还要承担打开与关闭文件、返回打开错误和读取错误;不要为了做出“可重复”的表象而悄悄吞掉这些错误。
API 注释要明确写出 single-use
iter.Seq 的类型签名无法表达“只可消费一次”。因此,返回单次迭代器的函数或方法必须在文档注释中说明这一点。官方文档给出的惯例就是写明 It returns a single-use iterator.。
对调用者还应补充三件事:
- 完整消费后再次调用是否保证为空;
- 提前停止后能否继续,以及继续的位置;
- 读取错误从哪里获得,资源由谁关闭。
如果把 push iterator 转成 iter.Pull,也不会因此获得回卷能力。它仍在消费同一个底层序列;没有读到结尾就不再需要值时,应调用返回的 stop,通常写成 defer stop()。
我会怎样验证这个边界
这类 API 的测试不需要依赖具体文件路径,准备三个可预测的值即可。我通常至少覆盖下面四种情况:
- 可重复迭代器完整消费两次,两次结果都等于完整输入。
- 单次迭代器完整消费后再调用,第二次结果为空。
- 单次迭代器读取一个值后提前停止,再调用时符合文档约定。
- 调用方提前停止后,底层资源能够清理,错误仍可被观察。
这里不要只断言“循环执行了”,而要断言两轮分别得到了哪些值。这样一旦有人把 Scanner 从迭代函数内部挪到外部,测试会直接暴露 API 语义已经从可重复变成单次。
几个容易混淆的问题
重复 range 单次迭代器会报错吗?
通常不会。完整耗尽后再次调用一般只是没有值;提前停止后的表现由实现决定。自定义迭代器也可以设置自己的状态检查,因此最终仍以该 API 的文档为准。
把 Seq 保存到变量就等于保存了数据吗?
不等于。保存的是一个函数值,它可能捕获切片,也可能捕获正在前进的 Reader、Scanner 或网络流。要保存数据,应显式收集或复制。
两个 goroutine 可以同时 range 同一个 Seq 吗?
不能仅凭 iter.Seq 类型认定并发安全。若它共享 Scanner、Reader 或其他游标,并发调用很可能竞争同一状态;必须由具体实现明确提供同步保证。
什么情况下应该直接返回切片?
当数据量可控、调用方明确需要多次遍历,而且延迟或流式处理并不重要时,切片往往更容易理解。迭代器适合惰性产生值,但不该用来隐藏资源生命周期。
结论
重复 range 的关键不是语法,而是状态放在哪里。状态在每次调用内部重新创建,序列通常可以从头再来;状态留在外部不可回卷的数据流中,它就是单次迭代器。完整消费后第二次通常为空,提前停止后第二次可能继续剩余数据。
我现在的取舍很简单:一次处理就明确标注 single-use;需要重复消费就收集为快照;需要重新读取大数据源就提供创建新 Reader 的工厂。把这个边界写进 API,远比让调用方通过第二次 range 的结果来猜更可靠。
-
295 收藏
-
171 收藏
-
269 收藏
-
257 收藏
-
390 收藏
-
388 收藏
-
448 收藏
-
195 收藏
-
153 收藏
-
142 收藏
-
497 收藏
-
105 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习