
Linux BPF ring buffer 怎样向用户态传递事件
来源:17golang原创
时间:2026-10-09 14:23:15 348浏览 收藏
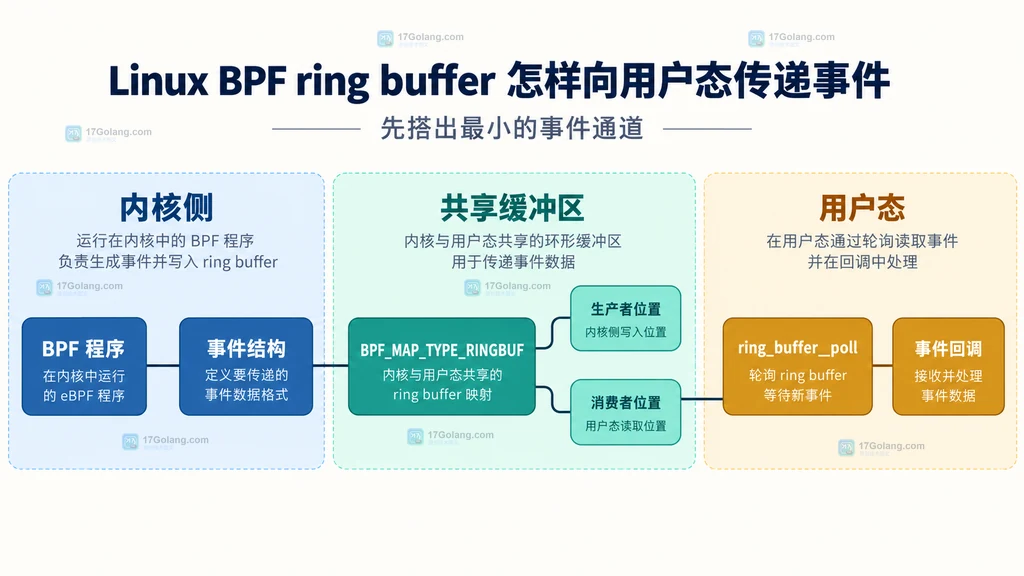
Linux BPF ring buffer 向用户态传递事件的基本做法是:创建一个 BPF_MAP_TYPE_RINGBUF map,BPF 程序把结构化记录写入其中,用户态用 libbpf 的 ring_buffer__new() 注册回调,再通过 ring_buffer__poll() 消费事件。内核侧可以选 bpf_ringbuf_output() 复制写入,也可以用 bpf_ringbuf_reserve() 直接预留记录,填写后调用 bpf_ringbuf_submit()。
高频、固定大小事件通常适合 reserve/submit;动态长度或从 perf buffer 迁移时,output 更直接。无论哪种方式,ring buffer 满时都不会阻塞等待,程序必须接受写入失败并记录丢事件。
我真正需要的不是“打印”,而是一条事件通道
刚开始写 BPF 观测程序时,我也习惯先用调试输出确认探针是否触发。但一旦要长期运行,用户态需要的是字段稳定、可批量消费、能统计丢失的事件通道,而不是一串难解析的文本。ring buffer 正好把这条边界拆开:BPF 程序负责采集和提交,用户态负责等待、解析和持久化。
官方内核文档给出的两个设计动机很实用:一个 ring buffer 可以跨 CPU 共享内存,提高利用率;多生产者共享同一缓冲区时,还能按预留顺序保留跨 CPU 事件的全局顺序。它以 BPF map 的形式存在,因此可继续使用 map 的内省和 libbpf 工具链。
先搭出最小的事件通道
map 不需要 key 和 value,max_entries 表示缓冲区大小,并且必须是 2 的幂。内核态和用户态还要共享同一份事件结构定义;实际项目通常把结构体放进共同头文件,避免两边字段尺寸漂移。
// common.h:内核态和用户态共享的事件布局。
struct event {
    __u32 pid;
    char comm[16];
};

// BPF 对象中的 ring buffer map;容量必须是 2 的幂。
struct {
    __uint(type, BPF_MAP_TYPE_RINGBUF);
    __uint(max_entries, 256 * 1024);
} events SEC(".maps");
这里的 256 KiB 只是便于理解的起点,不是通用最佳值。容量应结合事件大小、峰值事件率和用户态最坏处理延迟估算,并用丢事件指标调整。
BPF 侧用 reserve/submit 写入固定大小事件
对固定大小事件,我更愿意用 reserve/submit。bpf_ringbuf_reserve() 成功后直接返回 ring buffer 数据区中的记录指针,BPF 程序原地填写,不需要先在栈上准备完整结构再复制一次。代价是预留大小必须让验证器在加载时确定。
SEC("tracepoint/syscalls/sys_enter_execve")
int handle_exec(struct trace_event_raw_sys_enter *ctx)
{
    struct event *e;

    // 空间不足时立即失败,不阻塞当前内核执行路径。
    e = bpf_ringbuf_reserve(&events, sizeof(*e), 0);
    if (!e) {
        // 生产代码可在单独的计数 map 中累加 dropped 指标。
        return 0;
    }

    // 只写用户态真正需要的稳定字段,降低单条记录大小。
    e->pid = bpf_get_current_pid_tgid() >> 32;
    bpf_get_current_comm(&e->comm, sizeof(e->comm));

    // submit 让记录对消费者可见;此后不能再访问 e。
    bpf_ringbuf_submit(e, 0);
    return 0;
}
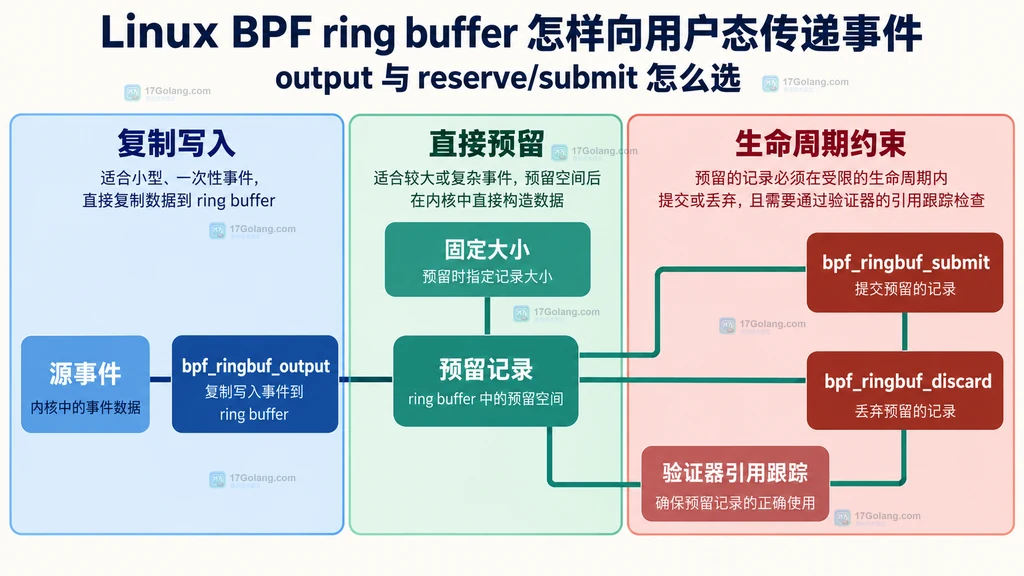
成功 reserve 的记录必须在所有分支上以 bpf_ringbuf_submit() 或 bpf_ringbuf_discard() 结束。验证器会跟踪这类引用,遗漏释放路径通常会导致程序无法通过验证。discard 不会把内容交给消费者,适合预留后发现过滤条件不满足,或者需要放弃一组临时记录的情况。
用户态用 libbpf poll 并校验记录长度
用户态先通过 skeleton 取得 map 文件描述符,再创建 ring buffer manager。每当有记录可消费,libbpf 会调用回调。回调收到的是裸数据指针和长度,所以解析前应先检查 len,不要直接假定两边结构完全一致。
#include#include #include static int on_event(void *ctx, void *data, size_t len) { const struct event *e = data; // 长度不足说明用户态布局与记录不匹配,跳过本条避免越界读取。 if (len pid, e->comm); return 0; } static int consume_events(struct demo_bpf *skel) { struct ring_buffer *rb; int err = 0; // 由 skeleton 中的 ring buffer map 创建用户态消费者。 rb = ring_buffer__new( bpf_map__fd(skel->maps.events), on_event, NULL, NULL ); if (!rb) return -1; while (!stop) { // 100 毫秒超时让循环能定期检查退出标志。 err = ring_buffer__poll(rb, 100); if (err == -EINTR) break; if (err
上面的 demo_bpf 和 stop 代表项目自己的 skeleton 类型与退出标志。完整程序还需要负责 open、load、attach、信号处理和 skeleton 销毁;这里刻意只保留事件消费边界。
output 与 reserve/submit 怎么选
bpf_ringbuf_output() 接收一块已经准备好的数据并复制到 ring buffer。它多一次复制,但允许记录长度在运行时决定,也更接近 bpf_perf_event_output() 的调用方式,迁移旧程序时往往更省改动。
bpf_ringbuf_reserve() 直接提供 ring buffer 内存,省掉复制,也绕开 BPF 栈空间偏小带来的临时存储问题。不过预留大小必须是验证器可知的常量,而且成功预留后必须严谨收尾。我的选择通常是:固定结构、高频事件用 reserve;长度不固定或先求迁移简单时用 output。
| 维度 | bpf_ringbuf_output | reserve/submit |
|---|---|---|
| 数据准备 | 先在其他位置准备 | 直接填写 ring buffer 记录 |
| 额外复制 | 有 | 避免一次复制 |
| 记录长度 | 可在运行时确定 | 预留大小需可由验证器确定 |
| 生命周期 | 单次调用 | reserve 后必须 submit/discard |
| 适合场景 | 迁移、可变长度事件 | 固定结构、高频采集 |
生产环境里最容易忽略的三个坑
ring buffer 满了不会等待
官方语义是空间不足时预留失败,不会阻塞内核执行路径。只有检查返回值还不够,最好用单独的 per-CPU 计数 map 记录 dropped 次数,否则用户态看到的“事件减少”无法区分业务真的变少还是缓冲区溢出。
poll 更快不等于回调可以做重活
用户态回调如果同步写慢磁盘、发网络请求或做复杂格式化,消费者位置推进会变慢,最终反过来增加丢事件。更稳妥的做法是让回调只完成长度校验、轻量复制和入队,再由普通工作线程处理重任务。
共享 ring buffer 有顺序优势,也有争用代价
单个 ring buffer 是多生产者、单消费者结构,可以保留跨 CPU 的预留顺序,也共享内存。但极高写入压力下,所有生产者共享同一资源可能产生争用。内核文档说明 ring buffer 还能与 map-in-map 组合,按 CPU、进程组或其他键分片;是否分片应由顺序要求和压力指标决定,而不是默认照搬。
完整落地清单
- 用共同头文件固定事件布局,新增字段时考虑兼容和长度检查。
- 让
max_entries保持为 2 的幂,并根据峰值速率与消费延迟估算容量。 - 所有 reserve 成功路径最终都调用 submit 或 discard。
- 预留失败时增加 dropped 指标,不在 BPF 程序里阻塞重试。
- 用户态回调先验证 len,再访问字段,并保持处理轻量。
- 退出时中断 poll、释放 ring buffer manager,再销毁 skeleton。
相关问题
BPF ring buffer 能保证所有事件都不丢吗?
不能。缓冲区空间不足、NMI 上下文预留锁竞争或用户态消费过慢都可能导致预留失败。可靠做法是监控丢失计数,并根据业务决定扩容、降采样或减少事件字段。
一定要用 ring_buffer__poll 吗?
不一定。官方设计支持 epoll 通知,也允许为极低延迟做忙轮询。大多数常驻观测程序用带超时的 poll 更容易兼顾延迟、CPU 占用和优雅退出。
ring buffer 与 perf buffer 的主要差别是什么?
perf buffer 通常按 CPU 分配,而 BPF ring buffer 可以让多个 CPU 共享同一缓冲区,从而改善内存利用率,并更自然地保存跨 CPU 的事件顺序。是否迁移仍要结合现有用户态库、顺序要求和性能数据判断。
把 BPF 事件送到用户态,核心不是记住几个 helper 名称,而是守住三条边界:事件结构两端一致、每次预留都有结束动作、空间不足有可观察的丢失指标。做到这三点,ring buffer 才能从演示代码变成可长期运行的观测通道。
-
279 收藏
-
384 收藏
-
462 收藏
-
252 收藏
-
422 收藏
-
193 收藏
-
220 收藏
-
227 收藏
-
180 收藏
-
331 收藏
-
386 收藏
-
261 收藏
-
233 收藏
-
179 收藏
-
文章 · linux | 23小时前 | 容器 · Linux · 容器隔离 mount namespace PID namespace linux namespace network namespace268 收藏
-
490 收藏
-
297 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习