
用 MultipartReader 限制每个表单字段的读取量
来源:17golang原创
时间:2026-10-09 16:56:59 305浏览 收藏
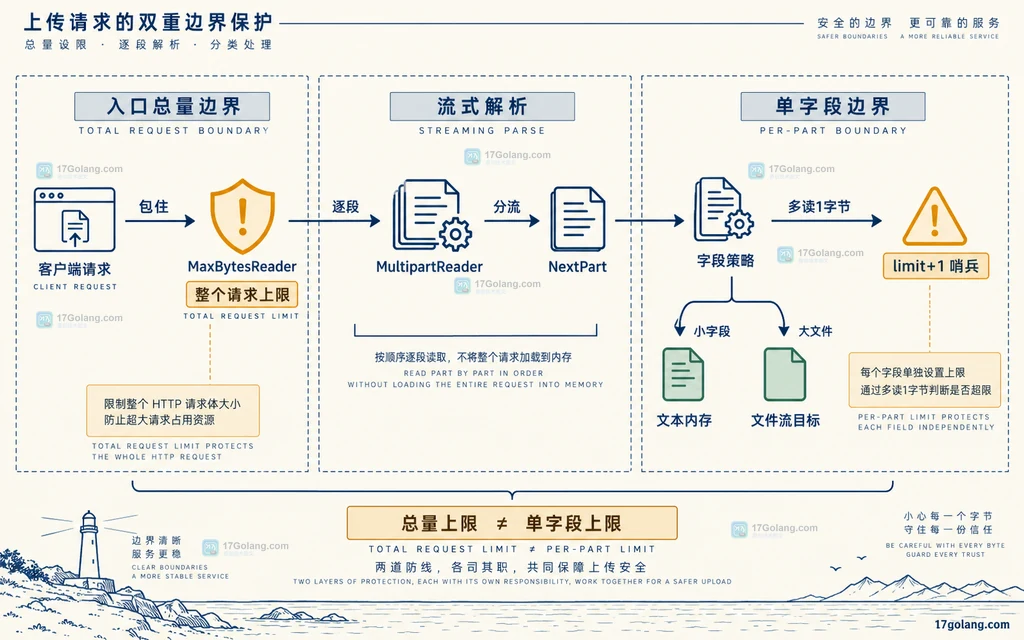
上传接口只限制 Content-Length 或只给 ParseMultipartForm 设置 maxMemory,都不能准确表达“备注最多 4 KiB、头像最多 2 MiB、附件最多 16 MiB”这样的逐字段策略。前者可能缺失或不可信,后者主要决定文件内容在内存与磁盘之间如何存放,并不是每个字段的业务上限。
直接做法:先用 http.MaxBytesReader 限制整个请求体,再调用 Request.MultipartReader() 流式遍历每个 Part。每个字段只读取“上限 + 1”字节:多出的 1 字节是超限哨兵,用来避免 io.LimitReader 静默截断。
官方文档:https://pkg.go.dev/net/http#Request.MultipartReader
- 整包上限:防止客户端持续发送超大请求体。
- Part 数量上限:防止大量微小字段拖垮解析和业务循环。
- 字段白名单与单字段上限:每个名称采用独立策略。
- 下游配额:对象存储、磁盘、数据库与扫描服务还要有自己的限制。
先明确双层字节边界
字段上限不能替代整包上限。即使每个已知字段都有限制,攻击者仍可能发送大量未知字段、重复字段或巨大的 multipart 头。反过来,只有整包上限也不够,因为一个合法大小的请求仍可能把全部预算集中到本应很小的文本字段。
| 边界 | 推荐工具 | 防护对象 | 超限结果 |
|---|---|---|---|
| 整个请求体 | http.MaxBytesReader | 正文、boundary、头部与所有 Part | *http.MaxBytesError |
| 单个文本字段 | io.LimitReader(limit+1) | 备注、标题、JSON 元数据 | 长度大于 limit |
| 单个文件字段 | io.CopyN(limit+1) | 头像、附件、导入文件 | 复制量大于 limit |
| 字段数量 | 循环计数器 | 大量小 Part | 计数超过上限 |
为什么必须读取 limit+1
io.LimitReader(part, limit) 在读满 limit 字节后表现为 EOF。它不会告诉你原字段是刚好等于 limit,还是后面还有数据。若直接把读取结果当成完整字段,超长内容会被静默截断,业务可能在不知情的情况下保存半段 JSON、半个 UTF-8 字符或不完整文件。
func readSmallField(part io.Reader, limit int64) ([]byte, error) {
	// 多读一个字节作为超限哨兵,避免静默截断。
	data, err := io.ReadAll(io.LimitReader(part, limit+1))
	if err != nil {
		return nil, fmt.Errorf("读取字段: %w", err)
	}
	if int64(len(data)) > limit {
		return nil, errPartTooLarge
	}
	return data, nil
}
这个模式适合小文本字段,因为最终仍会在内存中形成一个切片。文件字段应边读边写,不要用 io.ReadAll。
完整处理器:逐段读取并执行字段白名单
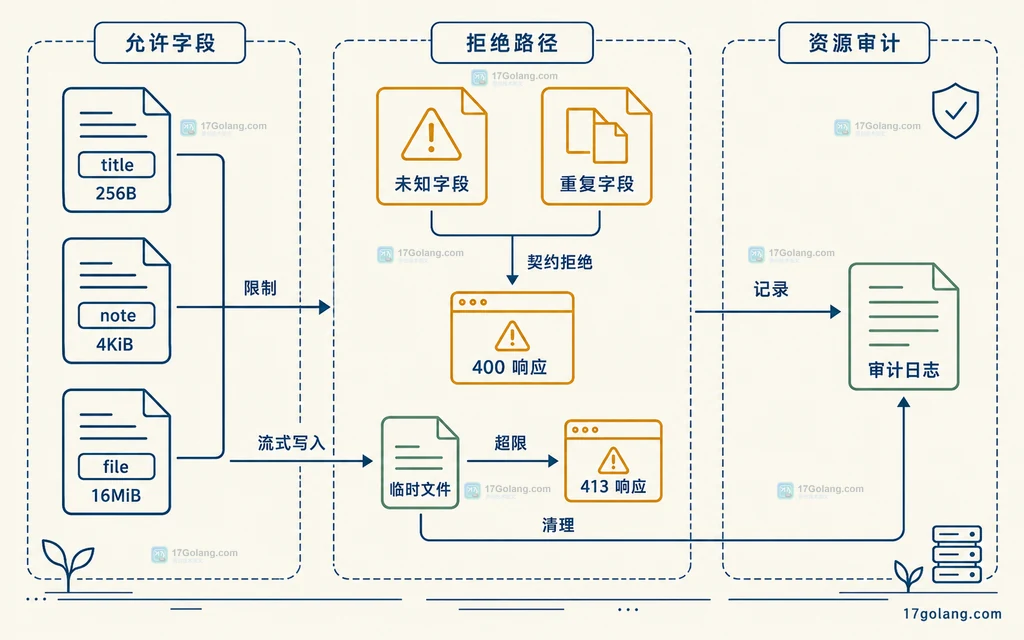
下面的示例只接受 title、note 和 file 三个字段。文本字段进入内存,文件字段写入服务端生成名称的临时文件;任何未知字段、重复字段或超限内容都会让整个请求失败。
package upload

import (
	"errors"
	"fmt"
	"io"
	"mime/multipart"
	"net/http"
	"os"
)

const (
	maxRequestBytes = 20
MultipartReader() 仅在请求是 multipart/form-data 或 multipart/mixed 时返回 Reader。它按需消费底层请求体,适合流式处理;不要在同一个请求上先调用 ParseMultipartForm,再尝试走这条流式路径。
把每个 Part 的生命周期收在一次循环内
循环中不要直接 defer part.Close(),否则所有 defer 会拖到函数结束才执行。把单个 Part 的处理封装到函数里,可以在每轮结束时关闭,并让错误路径保持清晰。
func readUpload(mr *multipart.Reader) (uploadInput, error) {
	var out uploadInput
	seen := make(map[string]bool)

	for count := 0; ; count++ {
		if count >= maxParts {
			return out, errTooManyParts
		}

		part, err := mr.NextPart()
		if errors.Is(err, io.EOF) {
			break // 所有 Part 已处理完成。
		}
		if err != nil {
			return out, fmt.Errorf("读取下一个字段: %w", err)
		}

		name := part.FormName()
		if name == "" {
			part.Close()
			return out, fmt.Errorf("%w: empty name", errUnknownField)
		}
		if seen[name] {
			part.Close()
			return out, fmt.Errorf("%w: %s", errDuplicate, name)
		}
		seen[name] = true

		// 单次调用负责处理并关闭当前 Part。
		if err := consumePart(part, name, &out); err != nil {
			if out.TempFile != "" {
				os.Remove(out.TempFile) // 失败时清理已创建的临时文件。
			}
			return out, err
		}
	}

	if out.Title == "" || out.TempFile == "" {
		return out, errors.New("缺少 title 或 file 字段")
	}
	return out, nil
}
字段白名单不仅是输入校验,也是一条权限边界:客户端不能通过额外字段偷偷触发尚未设计的业务分支。对是否允许同名字段重复,也应显式决策,不要默认只取第一个或最后一个。
文本与文件采用不同的读取策略
func consumePart(part *multipart.Part, name string, out *uploadInput) error {
	defer part.Close() // 当前字段处理结束后立即释放 Part。

	switch name {
	case "title":
		if part.FileName() != "" {
			return errors.New("title 不能是文件字段")
		}
		data, err := readSmallField(part, maxTitleBytes)
		if err != nil {
			return fmt.Errorf("title: %w", err)
		}
		out.Title = string(data)
		return nil

	case "note":
		if part.FileName() != "" {
			return errors.New("note 不能是文件字段")
		}
		data, err := readSmallField(part, maxNoteBytes)
		if err != nil {
			return fmt.Errorf("note: %w", err)
		}
		out.Note = string(data)
		return nil

	case "file":
		if part.FileName() == "" {
			return errors.New("file 必须带文件名")
		}
		path, err := copyLimitedFile(part, maxFileBytes)
		if err != nil {
			return fmt.Errorf("file: %w", err)
		}
		out.TempFile = path
		return nil

	default:
		return fmt.Errorf("%w: %s", errUnknownField, name)
	}
}
Part.FileName() 会返回 Content-Disposition 中的文件名,并经过基础路径处理,但客户端文件名仍是不可信元数据。不要把它直接拼接成服务端磁盘路径;示例使用 os.CreateTemp 生成服务端名称。
文件流式落盘时也使用加一哨兵
func copyLimitedFile(src io.Reader, limit int64) (path string, retErr error) {
	f, err := os.CreateTemp("", "upload-*")
	if err != nil {
		return "", fmt.Errorf("创建临时文件: %w", err)
	}
	path = f.Name()

	// 任意失败都删除不完整文件,成功时由上层接管生命周期。
	defer func() {
		if closeErr := f.Close(); retErr == nil && closeErr != nil {
			retErr = fmt.Errorf("关闭临时文件: %w", closeErr)
		}
		if retErr != nil {
			os.Remove(path)
		}
	}()

	// CopyN 尝试复制 limit+1 字节,额外字节用于证明超限。
	written, err := io.CopyN(f, src, limit+1)
	if err != nil && !errors.Is(err, io.EOF) {
		return "", fmt.Errorf("写入临时文件: %w", err)
	}
	if written > limit {
		return "", errPartTooLarge
	}
	return path, nil
}
不能只相信 Part 头部里的长度或原始文件名。真正的限制必须建立在从 part 读取到的字节上。若下游直接支持流式上传,也可以把临时文件替换为对象存储 Writer,但仍要保留 limit+1 计数、取消上传和失败清理。
把超限错误稳定映射为 HTTP 413
单字段超限是自定义错误;总请求体超限来自 MaxBytesReader,其错误类型为 *http.MaxBytesError。使用 errors.As 可以在包装后仍识别它。
func writeUploadError(w http.ResponseWriter, err error) {
	var maxErr *http.MaxBytesError
	switch {
	case errors.Is(err, errPartTooLarge), errors.As(err, &maxErr):
		// 413 表示请求内容超过服务器允许的大小。
		http.Error(w, "上传内容超过限制", http.StatusRequestEntityTooLarge)
	case errors.Is(err, errTooManyParts),
		errors.Is(err, errUnknownField),
		errors.Is(err, errDuplicate):
		// 字段结构不符合接口契约,返回 400。
		http.Error(w, "表单字段不符合要求", http.StatusBadRequest)
	default:
		// 不向客户端泄露内部路径和底层错误细节。
		http.Error(w, "上传处理失败", http.StatusInternalServerError)
	}
}
错误响应只给出稳定的客户端信息,详细原因写入结构化日志。日志可记录请求 ID、认证主体、字段名、策略上限、实际读取字节数和拒绝原因,但不要记录文件内容、令牌或完整隐私字段。
还需要哪些生产加固
请求超时与慢速上传
字节限制不能阻止客户端极慢地发送合法大小的数据。服务器还应配置 ReadHeaderTimeout,并根据部署方式设置请求体读取时限或入口网关超时。超时策略要覆盖反向代理和应用服务器两个层级。
内容类型与内容扫描
扩展名和客户端 Content-Type 都不可信。根据业务需要读取有限前缀进行文件类型识别,并在保存前执行恶意内容扫描。扫描服务同样需要输入上限和超时,不能因为主接口已经限流就省略。
临时目录与配额
为上传临时目录设置独立磁盘配额、权限和清理任务。服务端生成文件名,创建时使用仅进程可访问的权限。成功转存后删除临时文件,失败路径也必须清理。
并发与下游容量
单请求 20 MiB 并不代表一百个并发请求也安全。为上传路由设置并发上限,并把内存、磁盘、对象存储连接数和扫描队列一起纳入容量计算。
发布前测试清单
- 字段大小分别测试 limit-1、limit、limit+1 三个边界。
- 验证未知字段、空字段名、重复字段和字段数超限。
- 验证总请求体超过 MaxBytesReader 上限时返回 413。
- 验证文件字段被伪装成文本、文本字段被伪装成文件时拒绝。
- 模拟客户端中途断开,确认临时文件被删除。
- 模拟磁盘写满、对象存储失败和扫描超时,确认错误可观测。
- 执行多并发与慢速上传测试,确认内存、句柄和磁盘可控。
常见问题
只用 MaxBytesReader 可以吗?
不够。它限制总请求体,不能阻止某个小字段吞掉全部预算,也不能约束字段名、重复次数和字段总数。
io.LimitReader 超限会返回错误吗?
不会。达到限制后会像读到 EOF 一样停止,所以应读取 limit+1,再检查是否真的出现额外字节。
为什么不用 ParseMultipartForm 的 maxMemory?
maxMemory 主要控制文件内容在内存与磁盘间的存放方式,并非每个字段的独立业务上限。流式处理更适合精细策略和大文件。
NextPart 能自动防住所有恶意输入吗?
标准库有头部和 Part 数量等实现级限制,但业务仍需设置总请求体、字段数量、字段白名单和单字段上限。
可靠的 multipart 上传不是给一次读取套一个总长度,而是建立可组合的边界:入口用 MaxBytesReader 限制整包,解析层用 MultipartReader 逐段消费,字段层用 limit+1 证明是否超限,业务层再执行白名单、审计和下游配额。这样才能让内存、磁盘和处理时间都保持可预测。
-
285 收藏
-
255 收藏
-
459 收藏
-
282 收藏
-
381 收藏
-
Golang · Go教程 | 33分钟前 | go · Go教程 · net/http · WriteTimeout SSE 流式响应 SetWriteDeadline Go ResponseController446 收藏
-
251 收藏
-
373 收藏
-
186 收藏
-
148 收藏
-
103 收藏
-
435 收藏
-
240 收藏
-
465 收藏
-
311 收藏
-
276 收藏
-
144 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习