
Python Pydantic字段校验器before与after怎么选择
来源:17golang原创
时间:2026-10-13 20:00:29 469浏览 收藏
原始输入要先处理用 before,类型明确后的规则优先用 after
Pydantic v2 中,字段校验器 before 处理类型解析之前的原始输入,适合把约定允许的外部表示规范化;after 处理内部类型校验成功后的值,适合业务约束。我的默认选择是 after:能用字段类型和 Field 约束完成的部分就不重写,只有确实需要兼容一种输入表示时才增加 before。两者不是互斥方案,同一个字段可以各承担一项明确职责。
官方文档入口:https://pydantic.dev/docs/validation/latest/。本文使用 Pydantic v2 的 field_validator,不使用 v1 的 validator(pre=True) 写法;项目应固定已发布依赖版本。下面以请求中的 limit 字段说明选型,是代码设计示例,并非真实线上故障记录或实测报告。
先把生产入口的输入契约写清楚
如果我要设计一个列表查询接口,会先回答“允许什么”,而不是先写一个万能转换函数。本例接受整数,或者带首尾空格的 ASCII 十进制数字字符串;拒绝布尔值、浮点数、列表、空字符串和 null。数值必须在 1 到 200 之间,而且只能按 10 的倍数申请。这个倍数要求是示例业务政策,不是 Pydantic 自带规则。
“能转换成整数”与“符合接口契约”并不相同。比如 bool 在 Python 中与 int 有类型继承关系,随意调用 int(value) 会扩大可接受输入。我更愿意让 before 仅处理明确批准的文本格式,其余输入交给严格整数类型判断;这样代码的兼容范围可以解释,也方便将来收紧契约。
| 需要完成的工作 | 选择 | 原因 |
|---|---|---|
| 识别原始输入是文本还是其他对象 | before | 此时还能看到外部表示 |
| 要求整数以及上下限 | 字段类型与 Field | 不必在自定义函数重复实现 |
| 检查整数是否为指定倍数 | after | 可直接围绕已通过类型检查的整数编写规则 |
| 检查当前用户能否申请该额度 | 业务授权层 | 字段格式正确不代表用户有权限 |
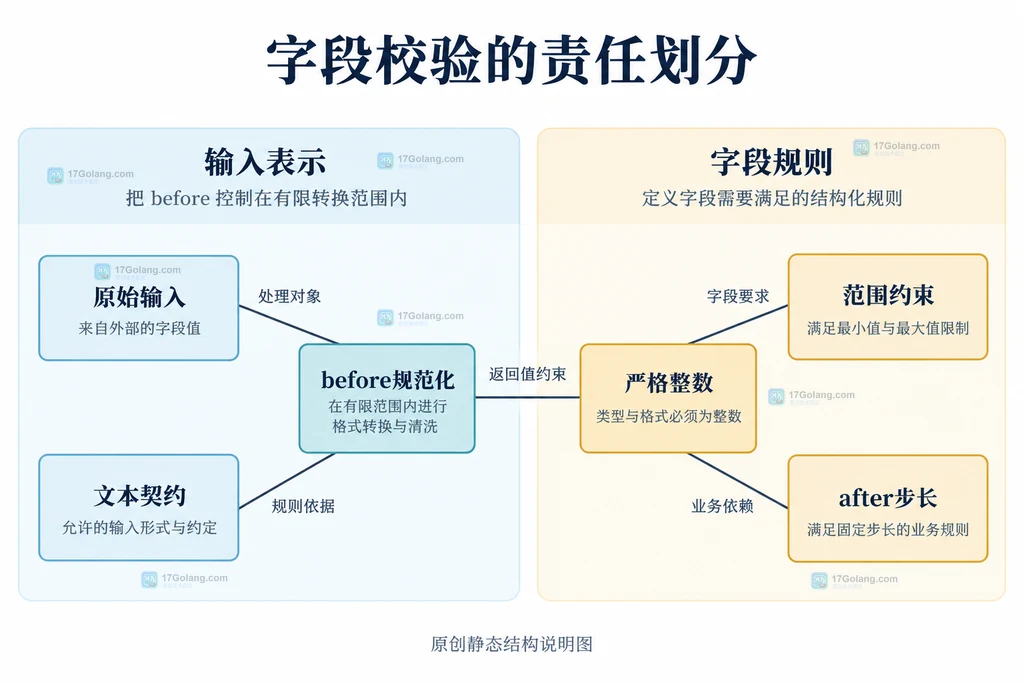
把 before 控制在有限转换范围内
下面示例使用 Python 3.10 及以上语法。before 的参数写为 Any,提醒自己不能假设输入已经是整数;after 则使用 int。两个函数都显式返回值。strict=True 限制字段类型转换,但不禁止自定义 before 主动完成已批准的字符串转换。
import re
from typing import Any

from pydantic import BaseModel, ConfigDict, Field, field_validator


class PageRequest(BaseModel):
    # 拒绝拼错的额外字段;这不是身份认证配置
    model_config = ConfigDict(extra="forbid")

    limit: int = Field(strict=True, ge=1, le=200)

    @field_validator("limit", mode="before")
    @classmethod
    def normalize_limit(cls, value: Any) -> Any:
        # 只允许明确约定的文本表示,不把任意对象强制转成整数
        if isinstance(value, str):
            text = value.strip()
            if not re.fullmatch(r"[0-9]{1,3}", text):
                raise ValueError("limit必须是1到3位十进制数字文本")
            return int(text)
        return value

    @field_validator("limit", mode="after")
    @classmethod
    def check_page_step(cls, value: int) -> int:
        # 类型和上下限交给字段约束,这里只表达业务步长
        if value % 10 != 0:
            raise ValueError("limit必须为10的倍数")
        return value


# 设计示例:文本先规范化,业务代码接收整数
request = PageRequest.model_validate({"limit": " 30 "})
print(request.limit)
按示例代码的规则,“ 30 ”应得到整数 30;15 会被步长规则拒绝,250 不符合字段上限,True 与 30.0 不满足本例严格整数契约。这些是预期行为说明,不是执行记录。字符串 “030”在本例中允许,并规范化为 30;如前导零具有业务含义,就不该使用这种整数转换。
我不建议为了让 after 接收原始字符串而改变其职责。进入 after 时值已经经过字段内部校验;反过来,before 返回了整数也不等于整个字段已经合格,后面的字段约束仍然适用。不要在函数末尾漏掉 return,否则你交给后续逻辑的值会变成 None。
格式校验不应该承担权限或持久化副作用
在生产接口中,我会把 PageRequest 当成输入数据边界,而不是授权凭证。即使 limit 合格,也需要结合当前用户、租户和业务状态判断能否执行查询。这些条件可能随请求上下文变化,不能靠一个字段装饰器就承诺安全。
before 尤其不适合“先改输入对象,之后发现有错再抛异常”。原始对象可能被其他逻辑复用,联合类型也可能有多个候选。示例只生成新的整数,不原地修改外部列表或字典。校验器里也不应顺手发送通知、扣减额度或写数据库;失败与重复调用会让这类副作用难以控制。
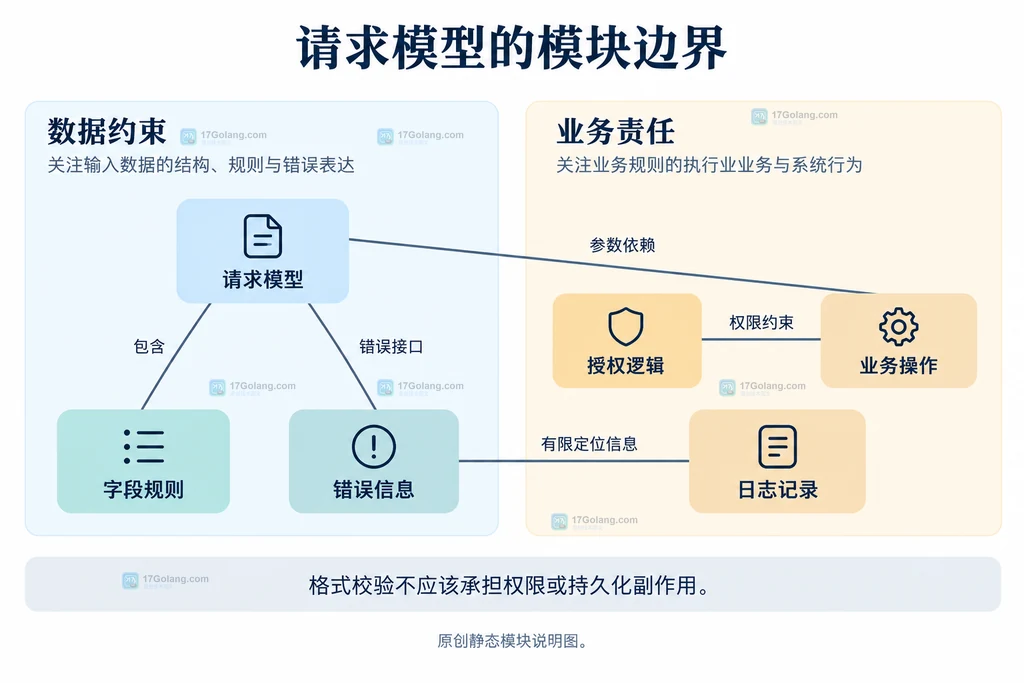
错误日志只记录定位所需的信息
拒绝输入时,我更倾向记录请求标识、字段位置和错误类型,而不是把整个请求及校验异常原样打印。Pydantic 的错误信息可能包含输入值;下面主动提取有限字段,避免日志把本来无需保存的输入内容带出去。请求标识由服务自身生成或可信入口提供,这里仅展示示例。
import logging
from pydantic import ValidationError

logger = logging.getLogger("request-validation")


def parse_page(payload: dict[str, object], request_id: str) -> PageRequest:
    try:
        return PageRequest.model_validate(payload)
    except ValidationError as exc:
        # 不记录input、ctx或异常完整字符串,仅保留字段位置和类型
        issues = [
            {"field": ".".join(map(str, item["loc"])), "type": item["type"]}
            for item in exc.errors()
        ]
        logger.info("invalid_page request_id=%s issues=%s", request_id, issues)
        # 交给接口层统一转换响应,避免此处吞掉失败
        raise
上面的函数与 PageRequest 放在同一模块使用。接口层可以为客户端提供稳定的字段错误提示,但不要把内部堆栈暴露给用户。校验器中对于预期输入错误使用 ValueError;v2 不再把校验器里的 TypeError 自动包装成 ValidationError,调用错误类型或方法导致的 TypeError 应当按程序错误定位,而不是全部伪装成客户端输入失败。
准备采用时还应考虑什么
before 的灵活性也是维护成本:允许一种新输入表示,就多一项长期兼容承诺。我的选择是让转换范围尽量小,避免添加多层隐式转换。after 适合清楚的业务判断,但不要返回与字段类型不一致的值,也不要默认“返回后框架一定再替你检查一遍”。简单范围优先用字段约束,特殊规则才写函数。
- 分别定义整数、字符串、布尔值、浮点数与空值的处理政策。
- 给上下限和特殊规则各安排自己的责任,不重叠实现。
- 错误反馈与日志保留字段位置,避免保留整份敏感输入。
- 业务授权、数据库事务和外部调用放到模型之外。
没写 mode 时是哪种?
field_validator 默认是 after。为了代码审阅时直观,本文仍把 mode 显式写出来。
默认值会自动经过这些校验器吗?
默认情况下不校验字段默认值。若以后把 limit 改成有默认值的字段,需要按需求设置 validate_default=True,并让默认值同样符合规则。当前示例是必填字段,没有默认值。
可以用 assert 拒绝非法输入吗?
可以触发 AssertionError,但 Python 的 -O 优化模式会跳过 assert。生产输入契约不应依赖它;显式 raise ValueError 更容易看清,也不受该开关影响。
官方校验器说明:https://pydantic.dev/docs/validation/latest/concepts/validators/;默认值规则:https://pydantic.dev/docs/validation/latest/concepts/fields/;严格模式:https://pydantic.dev/docs/validation/latest/concepts/strict_mode/。对这个示例,我会保留小范围 before 和明确的 after,而不是让任何一个函数包办输入格式、权限及持久化。
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习