
云原生 systemd 崩溃重启 怎样处理
来源:17golang原创
时间:2026-10-22 07:38:36 329浏览 收藏
云原生 systemd 崩溃重启 怎样处理
systemd 服务崩溃后反复重启,先查看原始退出原因,再同时检查重启策略和启动限流。合理配置可以给短暂故障留下恢复机会,却不能修好错误配置、缺失文件或应用异常。遇到启动次数过多的限制,也不应只反复执行 reset-failed。
官方手册入口:https://www.freedesktop.org/software/systemd/man/latest/systemd.service.html。下面构建一个独立的演示单元,用可控的非零退出说明处理过程;不是生产故障复盘,也不是新版本发布消息。所有运行状态均为预期说明,没有在本文环境实际执行。
一、先准备隔离环境和独立名称
示例适用于由 systemd 管理系统服务、具有 sudo 权限的 Linux 测试机。普通容器内不一定运行 systemd,macOS 也不能直接照做。请先确认 /bin/sh 与 /bin/sleep 存在,并确认 restart-boundary-demo.service 这个名称未被使用;如已存在,不要覆盖。
# 查看本机版本与名称归属,不修改已有服务
systemctl --version
systemctl cat restart-boundary-demo.service
# 确认示例用的两个程序可执行;路径不同应同步调整单元
test -x /bin/sh
test -x /bin/sleep
不存在的单元可能返回非零退出码,这是确认名称未占用时需要解释的结果,不应当作服务故障。还要确认本机手册支持下面的配置项;在线 latest 手册不代表所有发行版都安装了相同版本。
二、配置一个会失败但不会无限启动的单元
用管理员编辑器新建 /etc/systemd/system/restart-boundary-demo.service,内容如下。该示例不接触业务数据、不监听端口,命令故意以 23 退出,用于模拟应用失败,不是真正的进程崩溃信号。
[Unit]
Description=Restart boundary demonstration
# 60秒窗口内只允许有限次数启动,包含手动启动
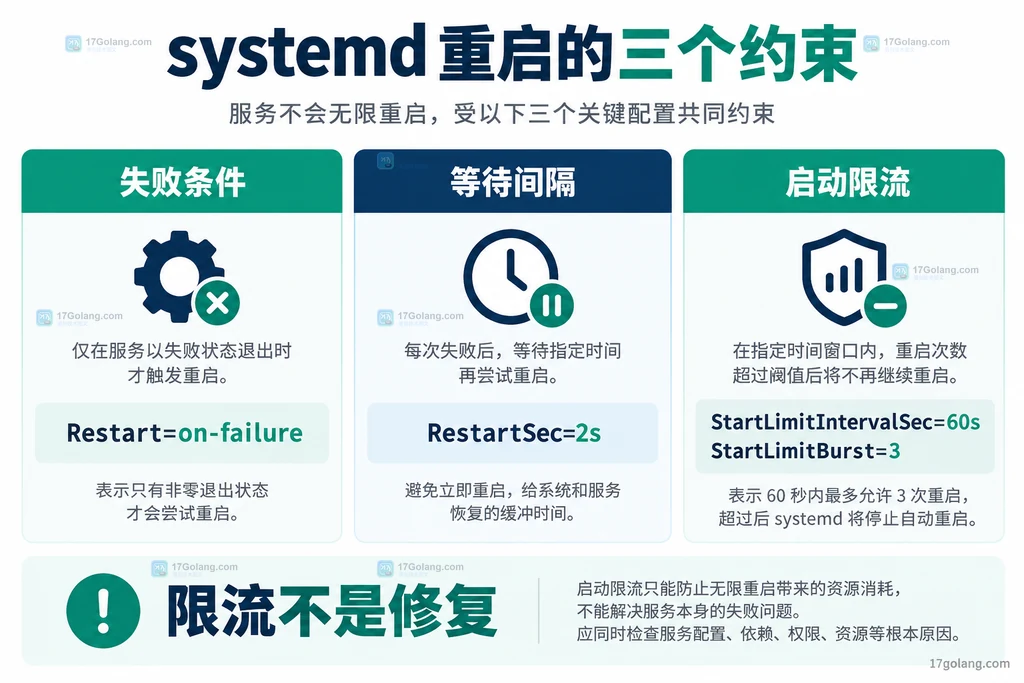
StartLimitIntervalSec=60s
StartLimitBurst=3

[Service]
Type=simple
# 仅用于隔离演示:有意制造非零退出,不替换生产命令
ExecStart=/bin/sh -c 'exit 23'
Restart=on-failure
# 自动重启前等待,避免过于密集地启动
RestartSec=2s
Restart=on-failure 处理非零退出等失败情况,并不等同于任意退出都重启。RestartSec 是等待间隔,不是业务健康检查。启动限流放在 [Unit],重启策略放在 [Service],不要混淆各自职责。
60 秒和 3 次只是本演示取值,并非生产推荐常数。在真实服务里,应结合启动耗时、依赖故障持续时间和报警安排决定。取消限流并不能解决持续崩溃,只会让资源和日志压力更难控制。
三、加载单元,观察第一条错误而非最后一条提示
# 重新读取单元文件;此命令本身不会修复或重启进程
sudo systemctl daemon-reload
# 仅启动独立演示单元,不设置开机自启
sudo systemctl start restart-boundary-demo.service
# 查看状态和最近记录;failed时status可能返回非零
sudo systemctl status restart-boundary-demo.service --no-pager
sudo journalctl -u restart-boundary-demo.service -n 50 --no-pager
启动后立即查看,可能正处在再次启动的等待中;稍后查看,可能已经停止重试。预期应能找到非零退出对应的记录,以及重试或启动限制信息,但日志措辞、顺序和可见条数依版本及权限不同。不要只凭一次 start 命令返回成功就认为进程持续可用。
在生产排障时,同样应从应用最初的错误找原因:配置解析失败、资源缺失和异常退出需要分别处理。后面的“启动过快”类提示通常描述的是重试后果,而不是最初根因。日志含敏感字段时应先脱敏再分享。
四、区分等待重启、触发限流和主动停止
自动重启仍受单元启动频率限制约束,而且手动启动也计入限制。达到限制后,systemd 不会仅因配置了重启策略就继续无限尝试。窗口经过后可以由后续启动请求重新尝试;不要把它理解成时间一到就必然自动恢复。
管理员主动执行 stop,与进程自身异常退出不是同一个事件。主动停止不会被普通自动重启策略立即拉起。若服务停止后又启动,要考虑其他激活来源,例如相关 socket、timer 或外部管理程序;本演示没有创建这些配套单元。
也要分清“进程还在”和“业务正常”。进程死锁却没有退出时,单靠 on-failure 不会把它变成故障检测器。是否使用看门狗,需要应用配合及额外设计,不能直接加入一个超时数字就声称完整支持。
五、修复命令,再清理失败状态并启动
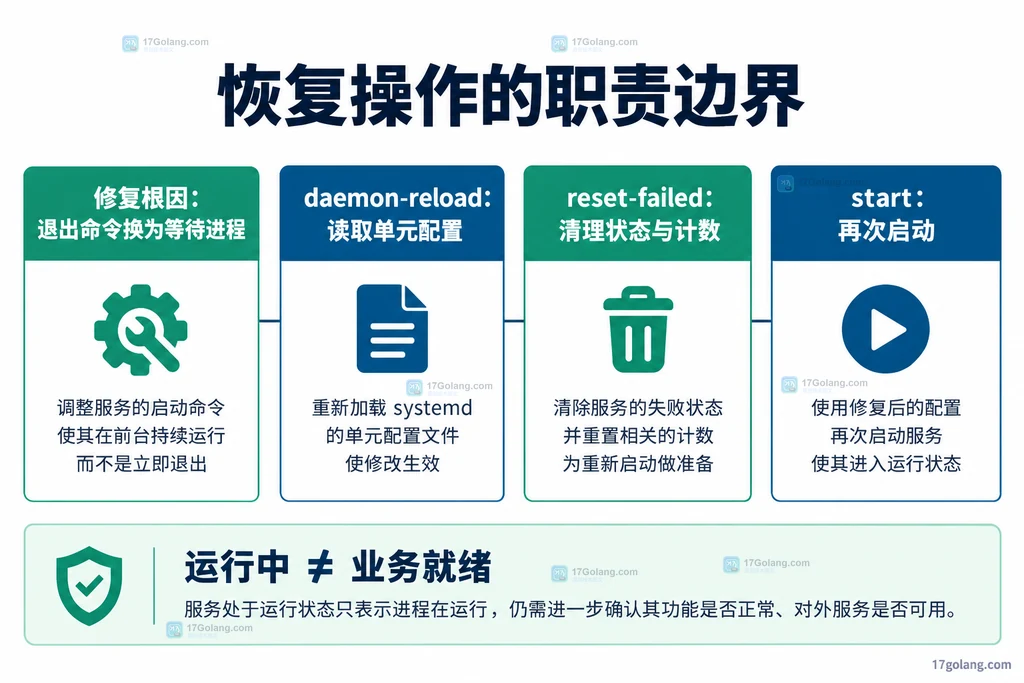
先保留必要的失败记录,再把本演示文件的 ExecStart 行替换为下面这一行,其他内容不变。务必替换原行,不要简单追加第二个 ExecStart。本例的等待进程只用于说明“不再立即退出”,不提供业务能力。
# 用持续等待替换故意失败的命令,仅用于演示
ExecStart=/bin/sleep 300
# 修复配置后才重新读取,避免重启同一个错误命令
sudo systemctl daemon-reload
# 先停止可能尚在重试的演示单元,收束旧进程
sudo systemctl stop restart-boundary-demo.service
# 清理指定单元失败状态与计数,不使用全局reset-failed
sudo systemctl reset-failed restart-boundary-demo.service
sudo systemctl start restart-boundary-demo.service
# 查看新进程是否处于运行中;它会在300秒后正常退出
sudo systemctl status restart-boundary-demo.service --no-pager
reset-failed 用于清理状态和相关计数,不会修改错误命令,也不代替 start。等待进程正常结束时,on-failure 不会因为这次正常退出而重启它;这正好与前面的非零退出形成对比。若执行路径错误或权限有问题,仍需根据新日志处理,不应把失败状态清空当作修复完成。
六、收尾只处理演示单元,再迁移到真实服务
# 演示结束只停止此单元,不影响其他系统服务
sudo systemctl stop restart-boundary-demo.service
# 必要时清理其失败标记;不代表删除日志
sudo systemctl reset-failed restart-boundary-demo.service
确认不再使用后,仅删除自己新建的 /etc/systemd/system/restart-boundary-demo.service 文件,再执行 daemon-reload。不要删除系统提供的服务目录,也不要对真实业务单元做批量清理。本示例没有执行 enable,因此没有为它建立开机自启链接。
迁移到真实应用时,应保留发行版提供的原单元,通过适当的覆盖配置调整策略,并核对最终生效内容。若应用由容器编排器管理,先确定谁负责进程生命周期,不要让多个层级互相重启、掩盖真正的故障归属。
常见疑问是“改成 always 是否更可靠”。答案取决于服务是否允许正常结束,它不是通用补丁;管理员主动停止也不能简单类比为进程自然退出。另一个疑问是“清空失败状态能否解决崩溃”,答案是否定的:修复根因、重新加载配置、恢复启动各有独立作用。
参考:systemd.service 重启语义、systemd.unit 启动限流、systemctl 状态管理。部署时以本机对应版本手册为准。
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
400 收藏
-
200 收藏
-
364 收藏
-
397 收藏
-
329 收藏
-
科技周边 · 业界新闻 | 14小时前 | 云原生 · kubernetes · Kubernetes Cilium Cilium NetworkPolicy NetworkPolicy 云原生网络策略138 收藏
-
182 收藏
-
322 收藏
-
科技周边 · 业界新闻 | 14小时前 | Java · 可观测性 · 业界新闻 · 版本迁移 · golang 可观测性 OpenTelemetry 语义约定 Java Agent 2.32.0 迁移预览431 收藏
-
科技周边 · 业界新闻 | 14小时前 | 云原生 · 配置管理 · kubernetes · 业界新闻 · 云原生 Kubernetes 配置更新 ConfigMap 滚动重启 kubelet subPath117 收藏
-
472 收藏
-
436 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习