
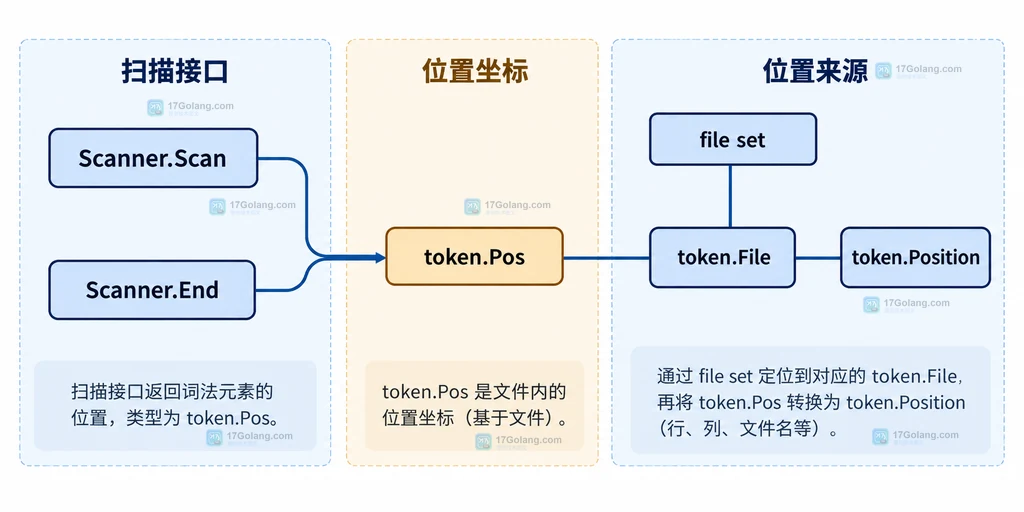
如果你在 Go 代码里看到 Scanner.End() 和自己记录的 PositionEnd 不一致,先不要修改偏移量。go/scanner 的 End 返回的是 token.Pos,它是绑定在 token.File 上的抽象位置;而 token.Position 才包含文件名、字节偏移、行号和列号。两者没有直接可比性,正确做法是用同一个 token.File 把它转换后再比较。
结论:先确认比较的是同一种类型,再确认所有位置都来自同一个token.File。每次Scan后调用s.End(),需要可读位置时使用file.Position(s.End());不要把它和源字符串的 rune 下标混用。
先把两个结束位置放回同一坐标系
Scanner.End 是 Go 1.27 增加的方法,语义是“最后一个已扫描 token 紧邻其后的那个位置”。Scan 返回的起点是 token.Pos,End 返回的终点仍然是 token.Pos。如果要打印或比较行列,应通过初始化扫描器时使用的 file 转成 token.Position。
package main

import (
	"fmt"
	"go/scanner"
	"go/token"
)

func main() {
	// src 的长度必须与 token.File 的 Size 一致;这里的位置以字节偏移为基础。
	src := []byte("name := 42")
	fset := token.NewFileSet()
	file := fset.AddFile("demo.go", fset.Base(), len(src))

	var s scanner.Scanner
	// 只扫描 Go token,不需要注释时可以保持 mode 为 0。
	s.Init(file, src, nil, 0)

	for {
		start, tok, lit := s.Scan()
		end := s.End()
		// token.Pos 先统一转换成 token.Position,再比较偏移和行列。
		startPos := file.Position(start)
		endPos := file.Position(end)
		fmt.Printf("%s..%s %s %q\\n", startPos, endPos, tok, lit)
		if tok == token.EOF {
			break
		}
	}
}
这里的关键不是把 End 强行改成某个整数,而是让起点、终点都经过同一份 token.File 转换。token.Pos 还受到 file set 基准值影响,直接和 len(src) 或另一个 file set 中的值比较,结果自然可能看起来“偏了”。
为什么不能把 End 当成 rune 下标
token.File 的 Offset 是从零开始的字节偏移,Column 是从一开始的列号;UTF-8 中文或其他多字节字符会让字节数、rune 数和列号不相等。因此,用 len(lit) 推导终点只适合非常受限的 ASCII 场景,不能作为通用规则。
// endPos 是 token 结束位置,不是字节切片的下一个 rune 下标。
endPos := file.Position(s.End())
if endPos.Offset < 0 || endPos.Offset > len(src) {
	// 位置异常时先检查 token.File、src 长度和 file set 是否配套。
	panic("scanner position is outside source")
}

// 需要截取源文本时,Offset 才能用于 []byte;不要用 Column 当切片下标。
tokenBytes := src[startPos.Offset:endPos.Offset]
_ = tokenBytes
另外,Scanner.Init 要求 file.Size() == len(src),否则会 panic。若你的 PositionEnd 是业务代码里自定义的字段,先记录它的来源:是 Scan 返回的 token.Pos、file.Position 的结果,还是对原始字符串再次计算出的偏移。
合成分号、EOF 和 BOM 会改变你的直觉
普通标识符或运算符的结束位置通常就是 token 后面的字节位置,但扫描器还会返回 EOF、自动插入的分号,以及多行块注释中的合成分号。它们不是“多扫了一次字符”,而是扫描器定义的 token 结果。
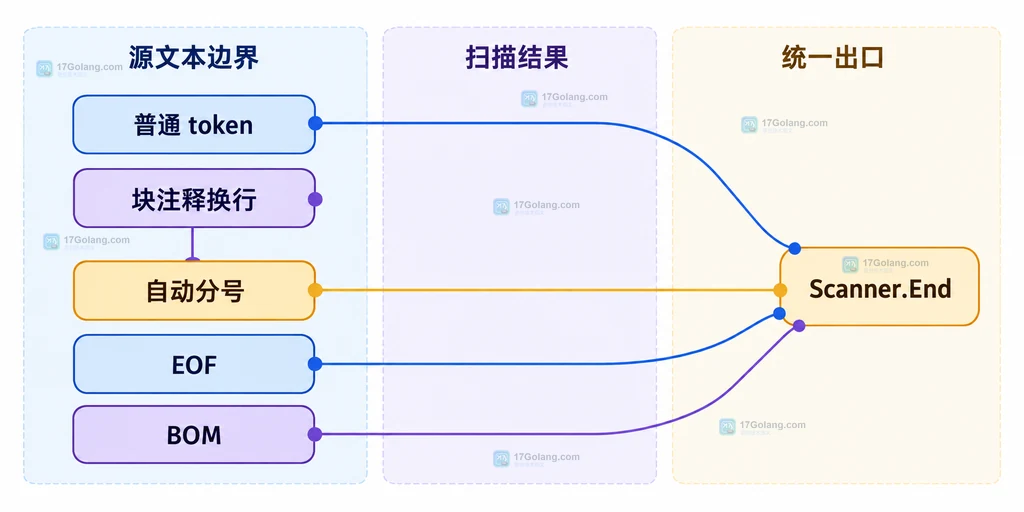
几个容易误判的情况如下:
- 初始化后还没有调用
Scan:s.End()应为token.NoPos。 - 扫描到 EOF:结束位置通常停在源末尾,EOF 本身没有可见字节。
- 源文件末尾的分号或换行:分号 token 的结束位置和 EOF 的位置可能不同。
/* ...\n ... */中触发的合成分号:End对应的是合成分号结束处,不是整个注释结束处。- 文件开头有 BOM:扫描器会处理它,但第一次可见 token 的位置仍应以
token.File的字节坐标解释。
// 用 token 类型和 End 一起记录,避免只看一个裸位置猜测边界。
for {
	start, tok, lit := s.Scan()
	end := s.End()
	fmt.Printf("tok=%s start=%v end=%v lit=%q\\n", tok, file.Position(start), file.Position(end), lit)
	if tok == token.EOF {
		break
	}
}
排查 PositionEnd 不一致时按这四项检查
- 确认版本:
Scanner.End从 Go 1.27 开始提供,旧版本不能按同一 API 解释。 - 确认类型:不要把
token.Pos、token.Position.Offset、rune 下标和列号放在同一列比较。 - 确认坐标系:起点和终点必须由同一个
token.File、同一个源字节串和同一个 file set 转换。 - 确认 token:把
tok和lit一起记录,特别检查 EOF、自动分号、多行注释和 BOM。
如果四项都一致,file.Position(s.End()) 仍与预期不同,优先检查你预期的“结束”到底是 token 结束、注释结束、行结束还是文件结束。Scanner.End 只承诺最后一次 Scan 返回 token 的结束位置,并不替业务代码定义另一种 PositionEnd。
相关问题
Scanner.End 调用前能得到文件末尾吗?
不能把未扫描状态的 End 当成文件末尾;初始化后未调用 Scan 时它返回 token.NoPos。如果需要文件末尾,应使用 file.Base() + file.Size() 对应的 file 坐标,并明确这不是最后一个已扫描 token 的结束位置。
为什么 End 和 lit 长度相加不相等?
因为 lit 是 UTF-8 字符串,长度可能按字节计算,而你比较的值可能是列号或 rune 数;另外合成 token 没有一段原始字节可直接对应。统一使用 token.File.Position 的 Offset,再结合 token 类型判断。




