
我第一次把 TXT 记录接进 Go 服务时,最容易误判的是返回值:看起来只是一个 []string,但它同时受 DNS 记录边界和 TXT 记录内部字符串片段影响。先把边界分清,再决定要不要拼接、索引或脱敏记录,后面的代码会稳定很多。
结论:net.LookupTXT返回 TXT 记录组成的字符串切片;如果一条 TXT 记录内部包含多个字符串片段,Go 会把它们拼接成一个字符串。生产代码需要可取消的Resolver.LookupTXT,并把每个返回元素保留为一条结果处理。
官方地址:https://pkg.go.dev/net@go1.27.3#LookupTXT
先分清切片元素和 TXT 内部片段
官方文档给了两个关键语义:查询结果是 TXT 记录的字符串切片;单条 TXT 记录如果有多个字符串片段,会在返回前连接成一个字符串。因此,返回切片的一个元素不一定等于 DNS 报文中的一个片段,但通常对应一条逻辑 TXT 记录。
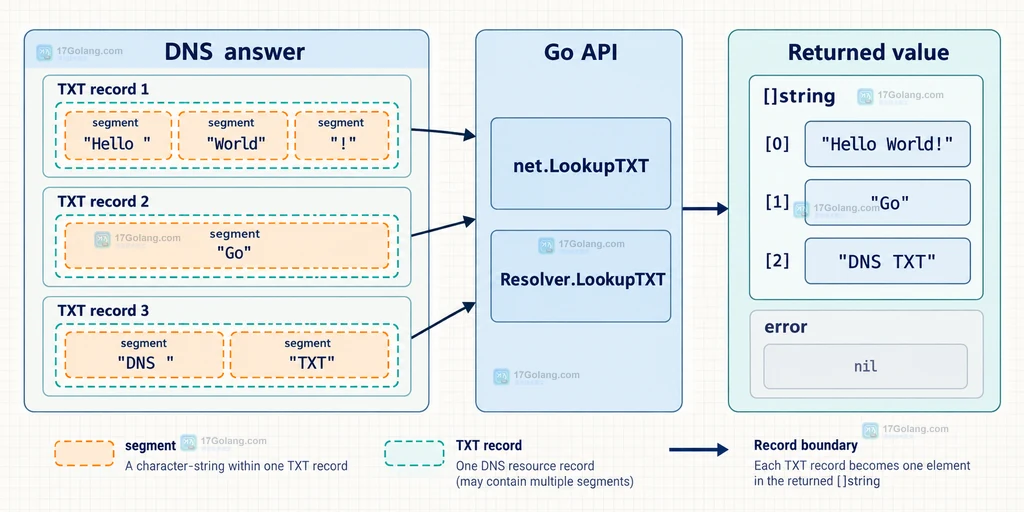
这也是我后来不再直接用 strings.Join(records, "") 的原因。连接所有切片元素会把多条独立记录也压成一段文本,调用方就失去了逐条审计和单条失败定位的依据。
package main

import (
	"fmt"
	"net"
)

func main() {
	// 这里只演示返回值的组织方式;真实查询应优先使用带超时的 Resolver。
	records, err := net.LookupTXT("example.com")
	if err != nil {
		// DNS 错误要保留给调用方,不要把空切片误当成“没有配置”。
		fmt.Println("lookup TXT failed:", err)
		return
	}

	for index, value := range records {
		// 每个切片元素单独输出,保留逻辑记录的边界。
		fmt.Printf("record[%d]=%q\n", index, value)
	}
}
示例里的 example.com 只是占位域名,重点是处理模型:先判断错误,再把每个元素作为独立值交给后续逻辑。不要根据某个域名当前返回几条记录,反推 API 永远只会返回一条。
用 Resolver 和 context 把查询边界收紧
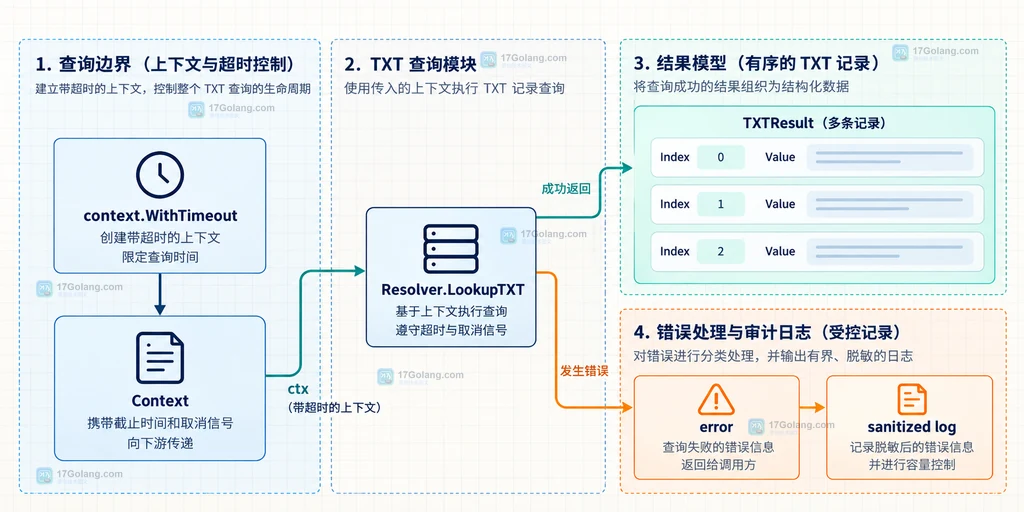
包级函数内部使用 context.Background()。在服务端请求、定时任务或批量检查里,我更习惯直接使用 Resolver.LookupTXT,这样可以把上游请求的取消和超时传进去。查询超时不是“空结果”,应当沿着错误分支记录。
package main

import (
	"context"
	"fmt"
	"net"
	"time"
)

// TXTResult 给每条返回记录一个稳定序号,避免后续日志只剩一段拼接文本。
type TXTResult struct {
	Index int
	Value string
}

func lookupTXT(ctx context.Context, name string) ([]TXTResult, error) {
	resolver := net.Resolver{}
	values, err := resolver.LookupTXT(ctx, name)
	if err != nil {
		// 原样返回 DNS 错误;调用层再决定怎样记录和重试。
		return nil, fmt.Errorf("lookup TXT %q: %w", name, err)
	}

	results := make([]TXTResult, 0, len(values))
	for index, value := range values {
		// 不在这里拼接多条记录,保留每条值的独立边界。
		results = append(results, TXTResult{Index: index, Value: value})
	}
	return results, nil
}

func main() {
	// 超时只覆盖本次 DNS 查询,避免后台任务无限等待。
	ctx, cancel := context.WithTimeout(context.Background(), 3*time.Second)
	defer cancel()

	results, err := lookupTXT(ctx, "example.com")
	if err != nil {
		fmt.Println(err)
		return
	}
	for _, result := range results {
		fmt.Printf("record[%d]=%q\n", result.Index, result.Value)
	}
}
这里的结构体不代表 DNS 新协议,只是应用层的承接模型。它让后续代码可以增加来源、检查状态或脱敏字段,同时不破坏原始记录之间的边界。
展示文本可以拼接,但内部结果不要先拼接
有些页面确实需要把多条 TXT 值展示成一行,这属于展示层决定,不应在查询层完成。查询层保留 []TXTResult,展示层再明确使用分隔符;这样读者能看出原本有几条记录,也不会误以为拼接后的字符串就是一条 DNS 记录。
package main

import (
	"fmt"
	"strings"
)

type TXTResult struct {
	Index int
	Value string
}

func displayLine(results []TXTResult) string {
	parts := make([]string, 0, len(results))
	for _, result := range results {
		// 用可见分隔符表达“多条记录”,避免和单条记录内部拼接混淆。
		parts = append(parts, fmt.Sprintf("[%d] %s", result.Index, result.Value))
	}
	return strings.Join(parts, " | ")
}
如果业务协议要求解析 TXT 内容,例如识别某种配置语法,应把解析器放在更下一层,并先保留原始值。本文不把 TXT 查询结果直接当作 SPF、DKIM 或其他规则文本解析,因为那会引入另一套语义和安全边界。
生产环境要处理错误、空结果和日志边界
在我实际接入后台检查任务时,最有用的不是把所有值打印出来,而是把四种状态分开:
| 状态 | 建议处理 | 不要做什么 |
|---|---|---|
| 查询成功且有值 | 保留每个元素,按需进入业务解析 | 不默认合并成一条 |
| 查询成功但为空 | 记录“无 TXT 记录”并交给业务判断 | 不当成网络失败 |
| 超时或 DNS 错误 | 保留错误类型和查询目标摘要 | 不伪装成空结果 |
| 值过长或含敏感配置 | 限制日志长度并脱敏 | 不把完整 TXT 值写进公共日志 |
package main

import "strings"

func logValue(value string, limit int) string {
	if limit < 0 {
		// 负数配置没有合理含义,按空结果处理,避免切片越界。
		limit = 0
	}
	value = strings.TrimSpace(value)
	if len(value) <= limit {
		return value
	}
	// 日志只保留前缀并标记截断,完整值仍由受控业务流程处理。
	return value[:limit] + "…"
}
截断函数只是日志示例,不等于通用的敏感信息识别器。对真实配置还要按业务字段做脱敏,不能因为 TXT 查询来自 DNS 就默认它是公开、无害的数据。
我最后固定下来的排查顺序
- 先确认调用的是包级
net.LookupTXT还是带上下文的Resolver.LookupTXT。 - 再确认返回切片的每个元素是否被当成独立记录保留,是否有不必要的全量拼接。
- 遇到空切片时,区分“查询成功但无记录”和“查询失败”。
- 遇到一条记录内容看起来被拆成几段时,回到官方语义:同一 TXT 记录的多个字符串片段会被 Go 拼接。
- 最后检查日志:设置超时、值长度上限和脱敏策略,不把原始配置随意打进公共日志。
这样组织后,net.LookupTXT 只是查询入口,[]string 是原始结果承载,TXTResult 才是应用层可以审计和扩展的边界。需要展示时再拼接,需要解析时再进入业务层,问题会比“一次 Join 后全靠猜”容易定位。
相关问题
net.LookupTXT 返回的一个字符串就是一个 TXT 片段吗?
不一定。单条 TXT 记录内部有多个字符串片段时,Go 会先把它们连接后再返回;返回切片元素更适合按逻辑记录理解。
为什么不直接用 net.LookupTXT?
包级函数适合简单调用,但它内部使用背景上下文。服务端和后台任务通常需要超时、取消和更清晰的错误边界,因此可以使用 Resolver.LookupTXT。
查询没有错误但切片为空,是否代表 DNS 故障?
不能这样推断。空结果和错误是不同状态,应让业务决定“未配置”是否可接受,并保留必要的查询摘要。
官方资料:https://pkg.go.dev/net@go1.27.3#LookupTXT、https://pkg.go.dev/net@go1.27.3#Resolver.LookupTXT




