
Go goavro 解码后为什么还返回未消费的字节
来源:17golang原创
时间:2026-10-25 07:23:23 449浏览 收藏
Go goavro 解码后为什么还返回未消费的字节
使用 goavro 的 NativeFromBinary 解码 Avro 二进制数据时,第二个返回值不是“多余垃圾”,而是当前 schema 只消费了一条数据后,输入缓冲区中尚未读取的部分。单条消息的调用方应检查它是否为空;连续记录、长度帧或容器文件则要把它交给下一层边界处理。
官方地址:https://github.com/linkedin/goavro
排障时先记住一个判断式:err != nil 表示本次解码失败,err == nil && len(remaining) > 0 只表示还有输入没有被这一条 Avro datum 消费。两者不能混为一谈。
先看清 NativeFromBinary 的三个返回值
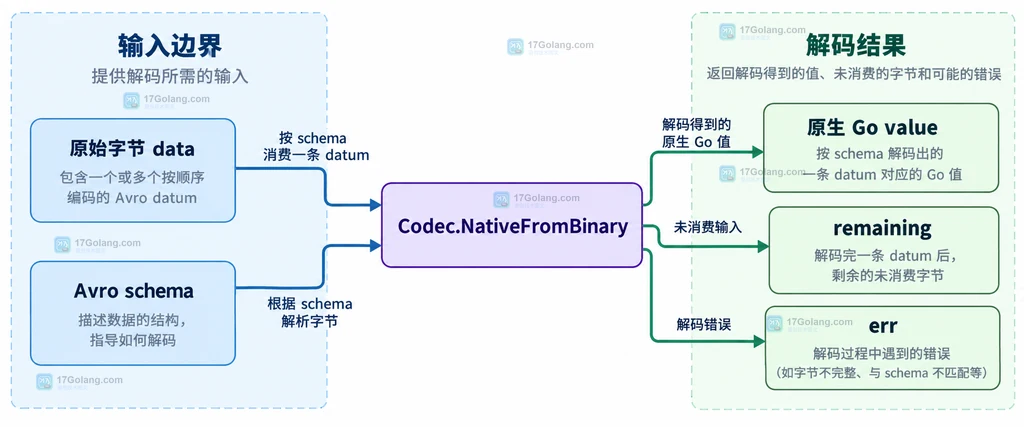
goavro 的二进制解码接口会返回原生 Go 值、剩余字节和错误。它按照传入的 schema 读取一个 datum,不负责替调用方猜测整个字节流的消息边界。
codec, err := goavro.NewCodec(schema)
if err != nil {
    return err
}

value, remaining, err := codec.NativeFromBinary(data)
if err != nil {
    // 本次 datum 没有完整解出,先记录输入边界和 schema 版本。
    return fmt.Errorf("解码 Avro 数据失败: %w", err)
}

// remaining 是本次 datum 没有消费的输入,不等于解码器自动发现了垃圾。
fmt.Printf("value=%#v, remaining=%d bytes\n", value, len(remaining))
如果 remaining 的长度为零,当前输入恰好只包含一条按该 schema 解出的数据。如果它不为零,优先确认调用方原本传入的是一条消息还是一段连续缓冲区,再决定是继续解码还是拒绝输入。
区分单条数据与连续数据
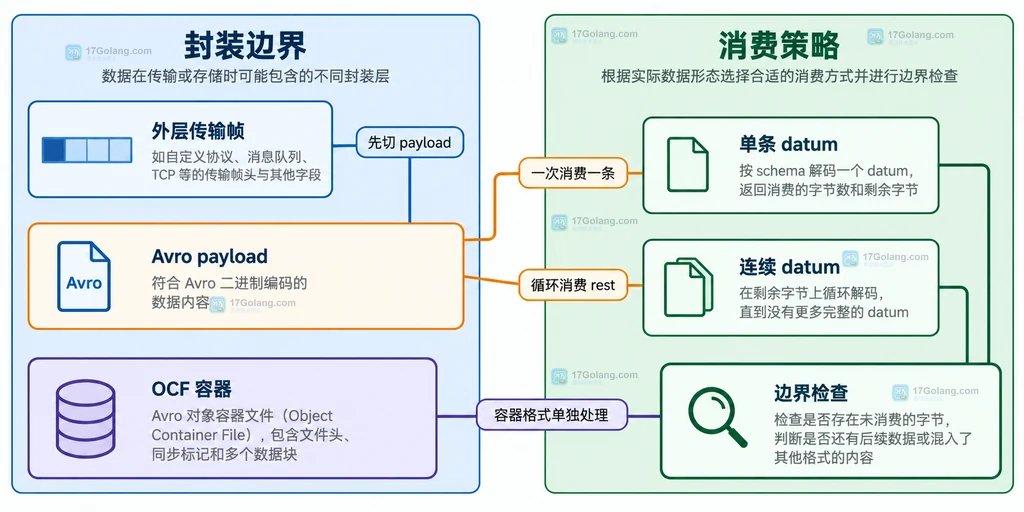
很多“解码后还有字节”的日志来自批量读取:生产端把多条 Avro datum 拼在一个缓冲区里,消费端却只调用了一次 NativeFromBinary。这时剩余字节可能就是下一条记录的开头。
buf := data
for len(buf) > 0 {
    value, rest, err := codec.NativeFromBinary(buf)
    if err != nil {
        // 失败时保留当前缓冲区长度,便于判断是截断还是 schema 不匹配。
        return fmt.Errorf("连续 Avro 数据解码失败,剩余 %d 字节: %w", len(buf), err)
    }
    if len(rest) == len(buf) {
        // 没有消费任何字节时退出,避免异常输入造成死循环。
        return fmt.Errorf("解码没有推进输入位置")
    }

    handle(value)
    buf = rest
}

// 循环结束才表示这一段输入中的字节全部被消费。
return nil
这段循环只适合“多条独立 datum 直接拼接”的输入。若上游有长度前缀、消息头、压缩块或其他传输协议,应先由帧解析器切出一条完整 payload,再把 payload 交给 goavro;不要把协议头也塞进 Avro decoder。
为单条消息建立边界检查
如果业务协议明确规定一条消息对应一个 Avro datum,剩余字节应当作为边界异常处理。这样能尽早发现重复拼包、错误切片或把下一层数据误传给当前解码器。
value, remaining, err := codec.NativeFromBinary(payload)
if err != nil {
    // 解码错误优先于边界错误,避免掩盖真正的 schema 或截断问题。
    return fmt.Errorf("Avro payload 无法解码: %w", err)
}
if len(remaining) != 0 {
    // 单条消息协议不允许把下一帧静默吞进当前 payload。
    return fmt.Errorf("Avro payload 包含未消费字节: %d", len(remaining))
}

return useRecord(value)
这里的“拒绝”不是说 remaining 一定损坏,而是当前接口的契约只接受单条消息。若确实需要批量传输,应该把批量边界写进协议或改用适合容器格式的读取方式,而不是放宽这个检查。
排查 schema、帧头和容器文件混入
确认剩余字节的来源,可以按下面顺序快速判断:
| 现象 | 优先判断 | 处理方式 |
|---|---|---|
| 每次都剩下稳定长度 | 前置头、长度字段或固定尾部仍在缓冲区 | 先剥离协议帧,再传 Avro payload |
| 剩余字节像下一条记录 | 多条 datum 被拼接而只解了一条 | 循环消费 rest,或按消息边界拆分 |
| 一开始就返回 error | schema 不匹配、数据截断或输入不是该编码 | 核对 writer schema、reader schema 与 payload 起点 |
| 把整个 OCF 文件当作裸二进制解码 | 容器头、同步标记和块结构未被处理 | 使用容器文件对应的读取路径,不直接套单条接口 |
Avro 二进制编码本身不携带足够的自描述边界信息,读取方依赖正确的 schema;goavro README 也将 NativeFromBinary 定义为 byte slice 到 native Go data 的转换入口。因此,出现剩余字节时,先把“数据格式”和“传输封装”分层,比盯着返回值本身更有效。
形成上线排障与回滚动作
在生产环境,建议把以下信息和一次解码失败绑定记录:输入总长度、当前消费前后的长度、schema 标识或版本、消息帧类型、消费位点以及错误文本。不要把完整业务 payload 写入普通日志,尤其是其中可能包含用户数据时。
- 先判断
err:有错误时先处理 schema、截断或 payload 起点问题。 - 再判断
len(remaining):单条契约要求为零,批量契约则继续沿正确边界消费。 - 若发布后剩余长度突然变化,暂停新 schema 的流量,保留旧 reader 配置读取兼容数据。
- 核对生产者和消费者的 schema、帧协议及压缩设置;确认后再恢复流量并关闭临时告警。
回滚时不要只回退 Go 代码而保留新的消息封装:解码器版本、writer schema 和外层帧协议必须作为一组配置复查。这样才能区分“正常的下一条记录”与“错误地把两层数据粘在一起”。
常见问题
remaining 非空是不是一定代表数据损坏?
不是。它可能是下一条独立 datum,也可能是外层协议尾部;只有在单条消息契约下才应直接判为边界异常。
能不能直接把 remaining 丢掉?
只有在明确确认它是协议允许的尾部并且不承载下一条数据时才可以。批量输入中丢弃它会造成静默数据丢失。
为什么换一个 schema 后剩余长度会变化?
Avro 二进制数据依赖 schema 解释字段和容器结构。schema 不匹配时可能直接报错,也可能在某个边界前停止,因此应同时核对写入 schema 与读取 schema,不能只看剩余长度。
总结
goavro 返回的 remaining 是“本次调用尚未消费的输入”。单条消息检查它必须为空;连续 datum 应循环消费并检测推进;带长度、压缩或容器结构的输入则要先处理外层边界。把数据、schema 和传输封装分层,基本就能快速定位这类排障问题。
-
502 收藏
-
502 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
205 收藏
-
431 收藏
-
436 收藏
-
296 收藏
-
377 收藏
-
166 收藏
-
247 收藏
-
233 收藏
-
234 收藏
-
474 收藏
-
399 收藏
-
402 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习