
Apache Kafka KRaft 模式怎样管理集群元数据
来源:17golang原创
时间:2026-10-29 02:40:19 125浏览 收藏
Apache Kafka 的 KRaft 模式把集群元数据交给 controller 组成的 Raft 仲裁组管理,而不是再依赖 ZooKeeper 保存 controller 状态。topic、partition、broker 注册和配置变更先进入集群元数据日志,由多数 controller 确认后,再由 broker 加载成自己的元数据视图。
官方地址:https://kafka.apache.org/40/operations/kraft/
- controller quorum 的多数派决定元数据是否还能提交,3 个 controller 通常可容忍 1 个故障。
- 元数据日志与 snapshot 负责持久化和快速恢复,broker 只应用已经提交的元数据。
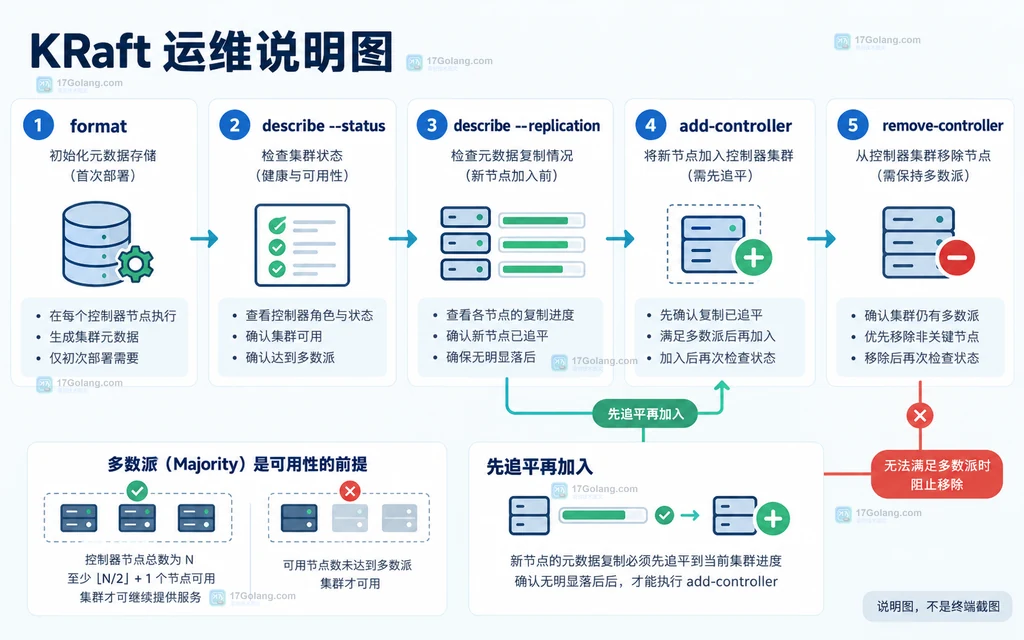
- 动态 quorum 扩容要先让新 controller 追平,再执行 add-controller;排障先看状态、复制延迟和高水位。
KRaft 把集群元数据交给 controller quorum
KRaft 的核心不是“每个 broker 自己保存一份配置”,而是把集群级变化集中到一个元数据分区。active controller 接收管理请求,把变更追加到 __cluster_metadata 日志;其他 controller 通过 Raft 复制,达到多数派后才算提交。broker 再从这个提交点加载 MetadataImage,因此 controller 选举和元数据提交是同一条控制链路。
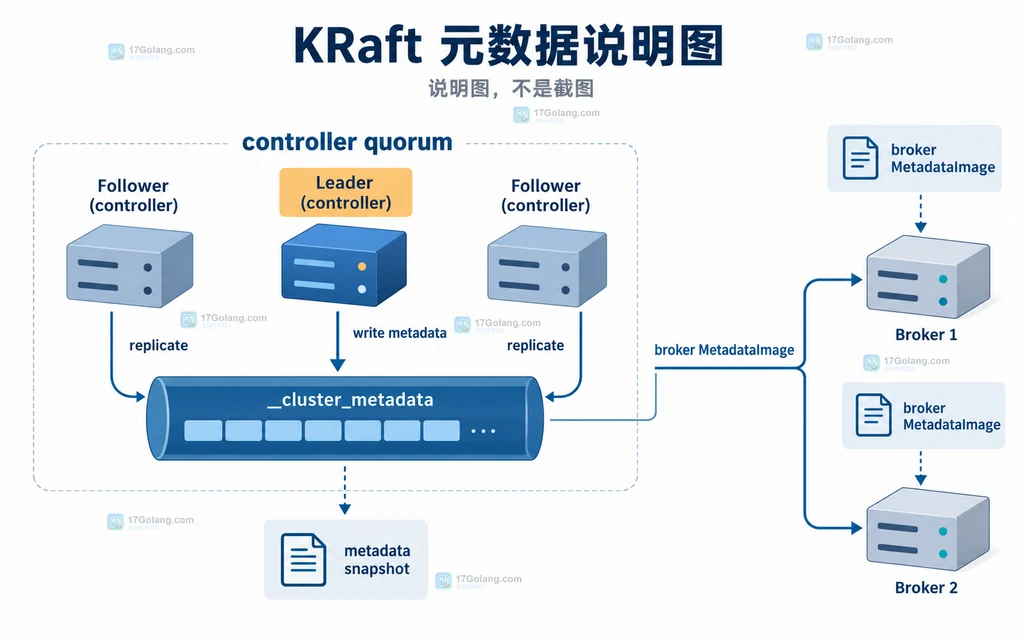
这里要把两类复制分开看:controller quorum 复制的是集群元数据,broker 的数据副本仍由 topic partition 的副本机制负责。前者不可用时,创建 topic、调整副本和许多管理动作会受影响;它不等于所有业务消息都已经丢失。
初始化时先固定 cluster ID 和元数据目录
新集群首先要让 controller 使用同一个 cluster ID,并在元数据目录中生成自己的身份文件和初始快照。生产环境通常把 controller 与 broker 分离,避免 combined mode 把两种故障域绑在一起。下面是初始化一个独立 controller 的示意命令,变量只是示例占位符:
# 生成一次集群标识,所有节点格式化时必须使用同一个值
CLUSTER_ID="$(bin/kafka-storage.sh random-uuid)"

# 首个 controller 以 standalone voter 启动,创建初始元数据快照
bin/kafka-storage.sh format \
  --cluster-id "${CLUSTER_ID}" \
  --standalone \
  --config config/controller.properties

# 新增到已有集群的节点不要重新创建一套初始 voter
bin/kafka-storage.sh format \
  --cluster-id "${CLUSTER_ID}" \
  --config config/server.properties \
  --no-initial-controllers
真正上线前要确认 metadata.log.dir 位于持久磁盘,并把 cluster ID、node.id、controller listener 和 quorum 引导地址纳入配置管理。误删元数据目录后直接格式化,会产生一个看似能启动、实际缺少已提交元数据的新成员。
先看 quorum 状态,再判断元数据是否健康
不要只看 broker 进程是否存活。KRaft 的管理判断至少要关注 leader、HighWatermark、最大 follower lag 和当前 voters。官方工具可以从 broker 或 controller endpoint 查询:
# 查看元数据仲裁的领导者、高水位和 voter 列表
bin/kafka-metadata-quorum.sh \
  --bootstrap-server localhost:9092 \
  describe --status

# 查看每个成员是否追上元数据日志;lag 持续增长才是风险信号
bin/kafka-metadata-quorum.sh \
  --bootstrap-server localhost:9092 \
  describe --replication
如果没有多数 controller,新的元数据记录不能稳定提交;如果某个 follower lag 持续升高,先检查网络、磁盘和 controller 进程,而不是马上删除它。恢复判断应以日志追平和仲裁状态为准。
动态 quorum 的扩缩容边界
Kafka 3.9 引入动态 controller quorum 后,controller 成员不必永久写死在每个配置文件里。新增 controller 的顺序应是:格式化并启动新节点、用 describe --replication 确认它追平 active controller、再执行 add-controller。移除时则要确认剩余成员仍能形成多数派;Kafka 4.4 的发布说明还提供了 controller 注销相关命令和 API。
静态 quorum 和动态 quorum 不是运行中随意切换的开关。可以用下面的命令确认当前 feature level:
# kraft.version 为 1 或更高通常表示已启用动态 quorum
bin/kafka-features.sh \
  --bootstrap-controller localhost:9093 \
  describe
| 观察项 | 它说明什么 | 处理边界 |
|---|---|---|
| Current Leader | 当前 Raft 元数据领导者 | 异常时先查选举与网络 |
| HighWatermark | 已提交的元数据位置 | 以多数派提交为准 |
| MaxFollowerLag | 最慢成员的复制落后量 | 持续增长先查磁盘和链路 |
| Current Voters | 当前参与投票的 controller | 移除前确认剩余多数派 |
常见问题
KRaft 元数据日志和业务消息日志是一回事吗?
不是。元数据日志描述集群结构和控制面变化,业务消息仍在各个 topic partition 的数据日志中复制。
为什么新 controller 启动了却不能立刻加入 quorum?
启动只代表节点可用,加入前还要让它追上已提交的元数据。先看 replication lag,再执行成员变更。
controller 是不是越多越好?
不是。多数派越大,故障容忍度会增加,但选举和复制的协调成本也会上升;常见部署先从 3 个 controller 评估。
-
472 收藏
-
385 收藏
-
395 收藏
-
343 收藏
-
129 收藏
-
123 收藏
-
170 收藏
-
331 收藏
-
307 收藏
-
161 收藏
-
344 收藏
-
130 收藏
-
416 收藏
-
257 收藏
-
497 收藏
-
284 收藏
-
123 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习