
PHP DOMDocument::loadHTML 怎样处理不完整 HTML
来源:17golang原创
时间:2026-10-29 03:54:26 300浏览 收藏
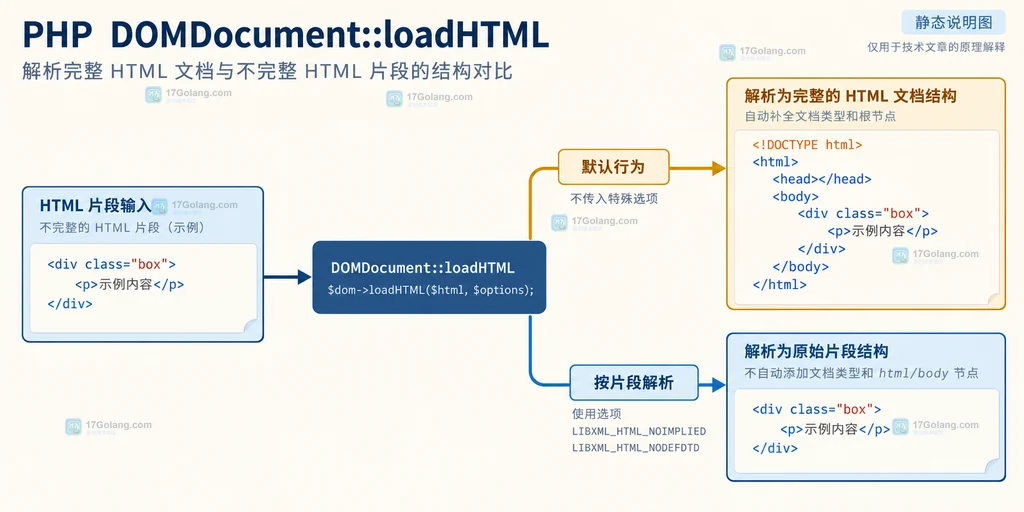
接口返回的 HTML 往往不是一份完整网页:可能只有一段 ,也可能在传输中少了闭合标签。DOMDocument::loadHTML() 的特点是容忍不少不完整标记并尝试恢复 DOM,但它不是“原样保存器”。默认情况下,libxml 可能补出 html、body 和 doctype;如果输入本来只是片段,后续用 saveHTML() 取结果时就容易误判。
- 缺少闭合标签通常可以被恢复,空字符串却会单独触发警告,必须先区分两种输入。
- 完整文档和片段的选项不同:片段常用
LIBXML_HTML_NOIMPLIED | LIBXML_HTML_NODEFDTD,再按需加LIBXML_NONET。 loadHTML()按 HTML 4 规则解析;需要 HTML5 规范行为时,应评估 PHP 8.4 引入的Dom\HTMLDocument。
不完整 HTML 能加载,但结果不一定只是原字符串
先看一个只有片段、且缺少闭合标签的输入:
PHP DOM';
$dom = new DOMDocument();
// loadHTML 会尝试恢复树结构;返回值只说明解析是否成功,不代表输出等于输入。
$ok = $dom->loadHTML($html);
echo $ok ? $dom->saveHTML() : 'parse failed';
?> 这个调用的重点不是“补标签的算法”,而是输入契约。官方手册明确说明 HTML 不必像 XML 那样完全良构;遇到坏标记时仍可能成功,同时产生 E_WARNING。因此,应用应把 bool 返回值、最终 DOM 和解析警告分开记录。
完整文档和 HTML 片段要分开判断
如果要处理的是完整页面,默认包装通常可以接受;如果只是把一段内容交给 XPath 或 DOM 查询,就应该显式声明“不要替我补文档外壳”。常用选项如下:
| 场景 | 建议选项 | 关注点 |
|---|---|---|
| 完整 HTML 文档 | 默认或按需加 LIBXML_NONET | 检查隐式节点和默认 doctype 是否符合下游预期 |
| HTML 片段 | LIBXML_HTML_NOIMPLIED | LIBXML_HTML_NODEFDTD | 不要把输出当成可独立打开的完整页面 |
| 不可信外部输入 | 限制网络访问,并单独做安全清洗 | loadHTML() 不是 sanitizer |
片段解析可以这样写。LIBXML_HTML_NOIMPLIED 关闭隐式 html/body 等节点,LIBXML_HTML_NODEFDTD 防止没有 doctype 时自动补默认 doctype;二者是“输出形状”控制,不是内容安全策略。
DOM';
$dom = new DOMDocument('1.0', 'UTF-8');

// 只想保留片段节点;NONET 避免解析时访问网络资源。
$flags = LIBXML_HTML_NOIMPLIED | LIBXML_HTML_NODEFDTD | LIBXML_NONET;
$ok = $dom->loadHTML($fragment, $flags);

if (!$ok) {
    throw new RuntimeException('HTML fragment parse failed');
}

// 片段可能没有可直接序列化的完整文档外壳,取节点时要按业务目标检查。
echo $dom->saveHTML();
?>
把警告变成可判断的解析结果
开发环境直接显示 libxml 警告很有用,线上则更适合临时切换到内部错误列表。关键是调用结束后恢复原来的错误模式,避免影响同一请求中的其他 XML/HTML 代码。
loadHTML($html, LIBXML_NONET);
$errors = libxml_get_errors();

// 先保存错误信息,再清理全局列表并恢复调用方的设置。
libxml_clear_errors();
libxml_use_internal_errors($previous);

if (!$ok || $dom->documentElement === null) {
    throw new RuntimeException('HTML produced no usable document');
}

foreach ($errors as $error) {
    error_log(trim($error->message));
}
?>
不要只用 LIBXML_NOERROR 把问题“静音”。它会隐藏错误报告,却不会让 DOM 结构更准确;真正需要的是确认页面是否成功构成目标节点,再决定是否接受可恢复警告。
字符集与 HTML5 规则是另外两条边界
DOMDocument 使用 UTF-8。输入来自接口或文件时,先确认字符串编码;仅仅把 DOMDocument 构造函数写成 UTF-8,并不能自动修复已经按其他编码读取的字节。可以在进入解析器前完成明确的转码,并让源 HTML 的字符集声明与实际内容一致。
还要留意解析模型:PHP 手册提醒 loadHTML() 使用 HTML 4 解析器,而现代浏览器使用 HTML5 规则,同一个不完整结构在两边可能得到不同 DOM。PHP 8.4 起,若业务要求遵循 HTML5 规范,可评估 Dom\HTMLDocument::createFromString();这不是把旧代码机械替换成新类,而是一次解析语义迁移。
最后,解析成功不代表输入安全。若 HTML 来自用户或第三方,仍需使用专门的允许列表清洗策略;不要把 loadHTML()、LIBXML_NOERROR 或 LIBXML_NONET 当作 XSS 过滤器。
常见问题
为什么少一个闭合标签仍然返回 true?
HTML 解析器允许一定程度的容错,会尝试修复树结构。返回 true 只说明解析器接受了输入,不代表闭合关系和浏览器完全相同;需要继续检查目标节点和警告列表。
片段解析为什么多出了 html 和 body?
这是 libxml 为文档补出的隐式节点。处理片段时组合 LIBXML_HTML_NOIMPLIED 与 LIBXML_HTML_NODEFDTD,再根据实际节点读取结果,不要依赖字符串比较。
PHP 8.4 还应该继续使用 loadHTML 吗?
兼容旧项目和 HTML 4 容错场景仍可使用;如果必须和 HTML5 浏览器解析规则一致,应评估 Dom\HTMLDocument,并针对 XPath、序列化和异常输入补回归测试。
实际排查时,可以按“输入是否为空 → 返回值 → libxml 错误 → 目标节点 → 解析标准”顺序检查。这样既能利用 loadHTML() 对不完整 HTML 的容错,也不会把它的自动修复误当成稳定的 HTML5 语义。
-
371 收藏
-
347 收藏
-
112 收藏
-
298 收藏
-
387 收藏
-
284 收藏
-
文章 · php教程 | 29分钟前 | PHP · 迁移 · php password_hash password_needs_rehash PASSWORD_DEFAULT PASSWORD_ARGON2ID PASSWORD_BCRYPT273 收藏
-
377 收藏
-
497 收藏
-
220 收藏
-
482 收藏
-
464 收藏
-
133 收藏
-
337 收藏
-
250 收藏
-
378 收藏
-
196 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习