
PHP grapheme_strpos 的偏移量为什么不按字节计算
来源:17golang原创
时间:2026-10-31 02:11:44 139浏览 收藏
grapheme_strpos 的 offset 与返回位置都以字素簇为单位,因为它面向Unicode文本的字素边界,而非UTF-8存储字节。一个字素簇可以由多个码点组成,每个码点又可能占多个字节。因此,不能把 strpos 得到的字节偏移直接传进去,也不能把它返回的位置直接交给 substr。
我在选择这类接口时,会先问“这个位置后面交给谁”:处理用户文本的查找和截取,我倾向让它们统一使用字素簇;处理二进制或明确的字节协议,则保留字节单位。这里分享的是接口选择判断,下面的数值来自示例推导,没有声称实际排查过某个线上故障。
PHP官方文档地址:https://www.php.net/manual/en/function.grapheme-strpos.php
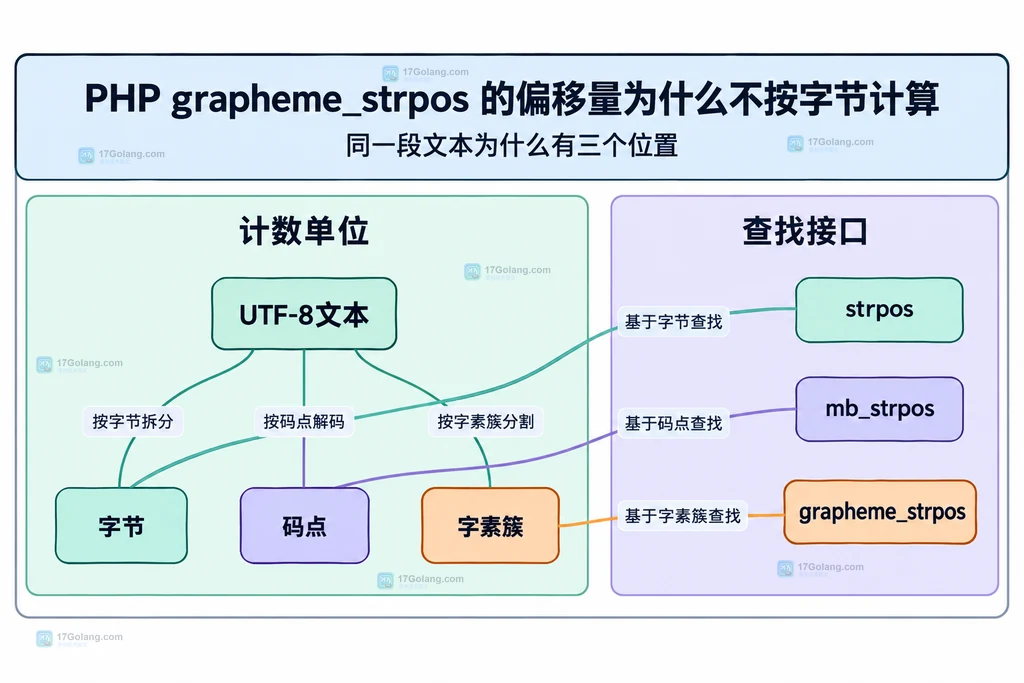
同一段文本为什么有三个位置
用 A + e + U+0301 + B 做例子:中间的e和组合重音形成一个字素簇。B之前有4个UTF-8字节、3个码点、2个字素簇,所以三种接口给出的数字不同,并不是某个函数少算了。
| 接口 | 本例计数单位 | B的预期位置 |
|---|---|---|
| strpos | 字节 | 4 |
| mb_strpos,显式UTF-8 | 码点 | 3 |
| grapheme_strpos | 字素簇 | 2 |
这里把“码点”和“字素簇”分开说,是为了避免用模糊的“字符”指代两种单位。字素簇通常更贴近日常阅读中的一个文字单元,但不是字体实际绘制的字形数量,更不是屏幕像素宽度。mb_strpos的字符位置说明与strpos返回值规则可作对照。
offset只是搜索起点,返回值仍从原文开头计数
假设从字素簇位置1开始找B,返回的仍是2,不是“离搜索起点还有1”。负offset表示从末尾相对确定搜索起点,也不会把结果改成负向坐标。官方手册明确了这两个规则。示例主动只接受非负起点,减少业务接口的歧义。依据:grapheme_strpos参数与返回值。
另一个容易忽略的地方是位置0。if (!$pos) 会把0与false混在一起;判断没有找到要写 $pos === false。先约束有效UTF-8输入、再处理没有找到,也比把所有异常都解释成“搜索词不存在”更清楚。
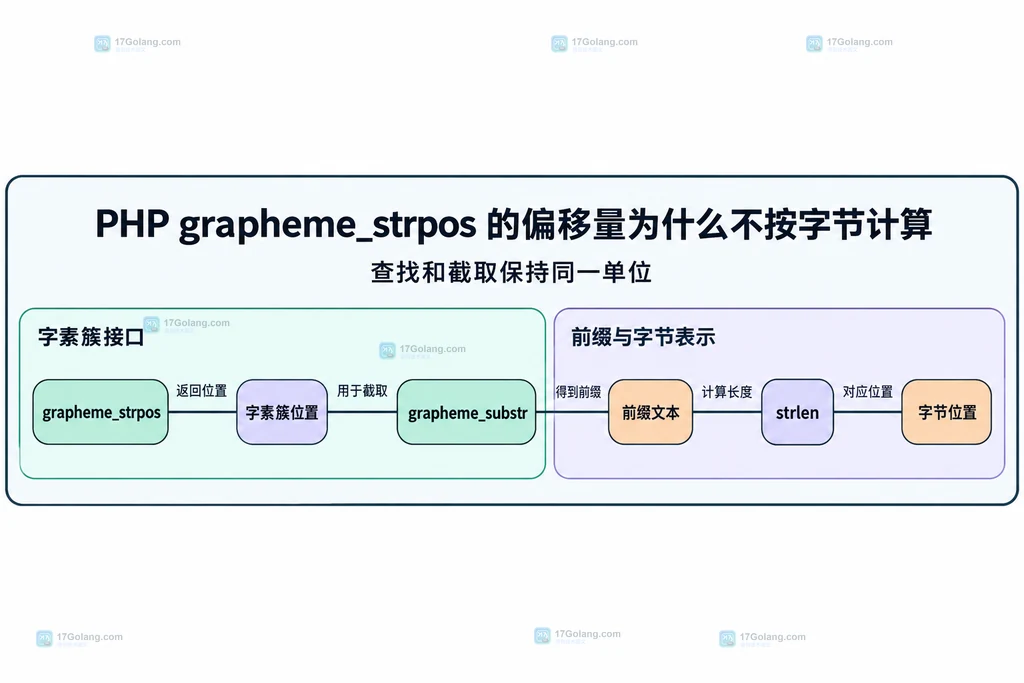
查找和截取保持同一单位
用 grapheme_strpos 查找,就用 grapheme_substr 按这个位置切前缀或尾部。字素簇位置属于两个函数共同的接口约定;前缀文本再交给 strlen,得到的才是该边界对应的字节位置。
下面是独立完整的PHP 8示例。保存为PHP文件后可由读者运行;它不依赖mbstring。长度函数的失败结果用 is_int 判断,避免只检查false而漏掉null。grapheme_strlen失败返回值、grapheme_substr的偏移单位。
 $total) {
        throw new OutOfRangeException('字素簇起点超出文本长度');
    }
    $graphemePos = grapheme_strpos($text, $needle, $start);
    if ($graphemePos === false) {
        return null; // 已满足有效输入约束时,表示未找到。
    }
    // 查找和截取都使用字素簇单位,不能把位置直接传给substr。
    $prefix = grapheme_substr($text, 0, $graphemePos);
    $tail = grapheme_substr($text, $graphemePos);
    if ($prefix === false || $tail === false) {
        throw new RuntimeException('字素簇截取失败');
    }
    return [
        'grapheme_pos' => $graphemePos,
        'byte_pos' => strlen($prefix), // 前缀的UTF-8字节数才是字节位置。
        'prefix' => $prefix,
        'tail' => $tail,
    ];
}

$text = "A" . "e\u{0301}" . "B";
$result = findTextParts($text, 'B', 1);
if ($result === null) {
    echo "未找到", PHP_EOL;
} else {
    // 预期为字素簇位置2、字节位置4;不是相对start的位置1。
    printf("grapheme=%d byte=%d tail=%s\n",
        $result['grapheme_pos'], $result['byte_pos'], $result['tail']);
}
按输入推导,最后一行预期为 grapheme=2 byte=4 tail=B。示例通过先切前缀、再测字节数取得转换结果,没有假设“每个字符固定占几字节”。如果文本被编辑,先前的位置可能失效,因此位置和具体文本版本应一起使用。
字节接口与字素簇接口怎样配合
如果后续组件明确要求UTF-8字节位置,可以使用示例中的 byte_pos。反过来,外部传来的字节偏移必须先确认落在合法边界上;不能直接当字素簇下标。这里没有给出任意字节位置的逆向映射函数,因为“位于多字节字符或组合序列内部时怎么办”需要业务先决定。
我更偏向在变量名里保留单位,例如 $graphemePos、$bytePos,并让接口文档写清计数依据。只有纯ASCII的简单测试容易看不出差别,补充组合重音文本才更能揭示单位误用;对emoji等复杂序列,还要关注实际运行环境的Unicode分段支持。
版本、比较规则和规范化的边界
字素函数属于intl扩展。官方手册在PHP 8.5增加了可选locale参数;本文只使用原有的前三个参数,不把第四参数写成所有PHP 8环境都可用。不同版本及区域设置可能影响比较规则,不能从“按字素簇计数”推断为“严格逐字节相等”。
规范化是另一个独立选择。若业务先用 Normalizer::normalize 统一文本形式,应对被搜索文本与搜索词应用同一约定,并在转换后的文本上查找和截取。不要把转换后的位置直接用于转换前的原始字节串。依据:Normalizer规范化接口。
常见问题
中文搜索时三个位置一定不同吗?
不一定。纯ASCII时往往相同;多字节中文会让字节位置与文本单位位置分开,而普通单码点汉字不一定让码点数与字素簇数不同。
结果0代表没有找到吗?
0代表在开头命中。使用严格比较识别false,不能用真假判断代替。
改成mb_strpos就能完全代替grapheme_strpos吗?
不能自动等同。前者在明确UTF-8时按码点位置理解,组合序列可能仍占多个位置;后者按字素簇边界处理。最终选择取决于后续组件需要哪种单位,查找、截取和位置保存应保持一致。
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
333 收藏
-
335 收藏
-
269 收藏
-
382 收藏
-
452 收藏
-
413 收藏
-
文章 · php教程 | 8小时前 | unicode · 字符串处理 · php教程 · php unicode Intl Normalizer Decomposition_Mapping getRawDecomposition137 收藏
-
332 收藏
-
121 收藏
-
234 收藏
-
118 收藏
-
446 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习