
如果把上传文件命名为 report.csv,再调用 mimetypes 得到 text/csv,这个结果只能说明“这个名字通常对应这个 MIME 类型”。它不能证明文件内容确实是 CSV,也不能证明文件里的文字是 UTF-8、GBK 还是其他编码。
原因很直接:mimetypes 的职责是根据文件名、路径或 URL 的后缀查表,返回 MIME 类型以及可能的 Content-Encoding。它不读取文件字节,更不会解析文本或音频格式。要验证“真实编码”,必须把名称声明层和内容事实层拆开处理。
官方文档:https://docs.python.org/3/library/mimetypes.html
迁移参考:https://docs.python.org/3/library/sndhdr.html
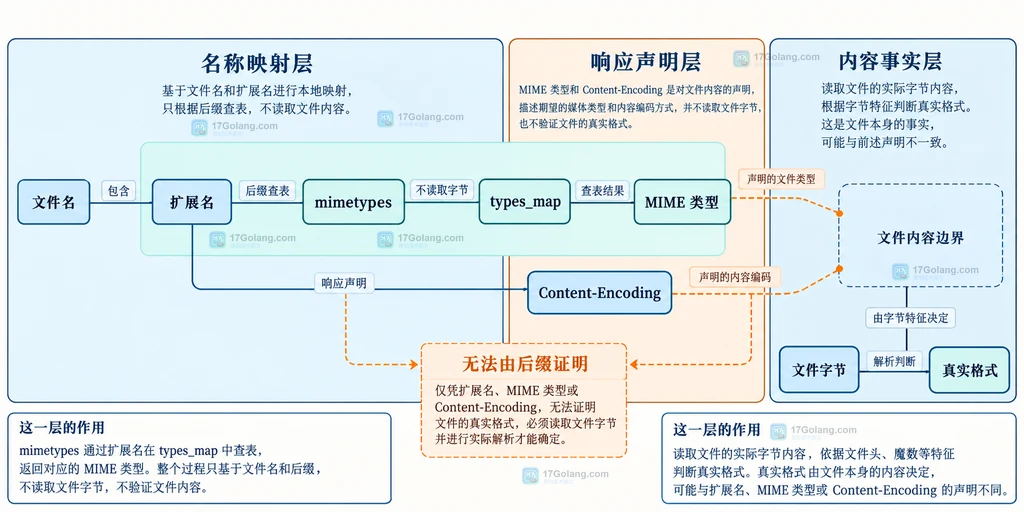
mimetypes 解决的是“怎么声明”,不是“内容是什么”
在 Python 文档里,mimetypes.guess_type() 和 guess_file_type() 都是基于文件名或路径推测 MIME 类型。返回值通常是二元组:第一项是可用于 HTTP Content-Type 的类型,第二项是适用于 Content-Encoding 的编码名,例如文件名包含 .tar.gz 时可能得到 gzip。
这里的“encoding”容易误读。它指的是压缩或传输层的编码声明,不是文本字符编码。gzip、brotli 与 UTF-8、GBK 不是同一层概念。
| 你想知道的事情 | 适合的依据 | mimetypes 是否能单独回答 |
|---|---|---|
| 文件名通常对应什么 MIME | 扩展名与 MIME 类型表 | 可以推测 |
| HTTP 响应是否声明 gzip | 后缀映射或响应头 | 只能提供映射提示 |
| 文本字节能否按 UTF-8 解码 | BOM、严格解码、文件元数据 | 不能 |
| 文件是否真的为 PNG、PDF 或 WAV | 魔数、容器解析器、格式校验 | 不能 |
所以,扩展名可以作为路由或初筛条件,但不能作为上传安全策略的唯一依据。一个名为 notes.txt 的文件完全可能装着二进制数据;一个名为 data.csv 的文件也可能是空文件、损坏文件,或者使用了与业务预期不同的分隔符。
先用 guess_file_type 做名称层判断
如果目标只是给下载响应设置一个初始 MIME,或者根据文件名选择默认处理器,使用名称层 API 就足够。Python 3.13 增加了专门接受路径的 guess_file_type();把路径传给 guess_type() 在新版本中属于软弃用方向,代码可以按运行环境做兼容。
from pathlib import Path
import mimetypes


def guess_declared_type(path: Path) -> tuple[str | None, str | None]:
    # 路径推断只负责给出声明层提示,不读取文件内容。
    if hasattr(mimetypes, "guess_file_type"):
        return mimetypes.guess_file_type(path, strict=True)

    # 兼容旧 Python:旧接口接收字符串路径,但结论仍然只是后缀映射。
    return mimetypes.guess_type(str(path), strict=True)


media_type, content_encoding = guess_declared_type(Path("report.csv"))
# media_type 可能是 text/csv;None 表示映射表里没有认识这个后缀。
# content_encoding 只描述 gzip 等内容编码,不等于 UTF-8 或 GBK。
strict=True 只影响是否限于 IANA 注册的 MIME 类型。它不会把函数变成内容识别器;即使改成 strict=False,也只是增加一些非标准但常见的映射。
文本编码必须回到字节、BOM 和解码结果
文本字符编码解决的是“字节如何还原为字符”。对于 UTF-8、UTF-16 等带 BOM 的文件,可以先识别 BOM;没有 BOM 时,应该优先使用上传协议、数据库字段、文件格式约定或用户配置提供的编码。只有在缺少元数据时,才可以把候选编码逐个进行严格解码,并把“多个候选都能解码”当成不确定,而不是强行选第一个。
from dataclasses import dataclass


@dataclass(frozen=True)
class TextGuess:
    encoding: str | None
    text: str | None
    ambiguous: bool


def decode_text_safely(data: bytes, declared: str | None = None) -> TextGuess:
    # BOM 是强信号,先处理常见的 Unicode 字节序标记。
    bom_candidates = (
        (b"\xef\xbb\xbf", "utf-8-sig"),
        (b"\xff\xfe", "utf-16-le"),
        (b"\xfe\xff", "utf-16-be"),
    )
    for marker, encoding in bom_candidates:
        if data.startswith(marker):
            return TextGuess(encoding, data.decode(encoding, errors="strict"), False)

    # 有业务元数据时优先采用它,严格模式会拒绝无法解码的字节。
    candidates = [declared] if declared else ["utf-8", "gb18030", "big5"]
    successes: list[tuple[str, str]] = []
    for encoding in candidates:
        if not encoding:
            continue
        try:
            text = data.decode(encoding, errors="strict")
        except UnicodeDecodeError:
            # 解码失败只能淘汰这个候选,不能证明另一个候选一定正确。
            continue
        successes.append((encoding, text))

    if len(successes) == 1:
        encoding, text = successes[0]
        return TextGuess(encoding, text, False)
    if len(successes) > 1:
        # 多种编码都能解码时,结果不唯一,应交给元数据或人工策略决定。
        return TextGuess(None, None, True)
    return TextGuess(None, None, False)
这个函数的价值在于把“无法按某编码解码”和“已经证明文件就是另一种编码”区分开。很多单字节编码能够接受大量字节序列,因此“解码不报错”并不等于“编码被唯一识别”。生产系统还应限制候选集合、记录选择依据,并避免用 errors="ignore" 悄悄吞掉坏字节。
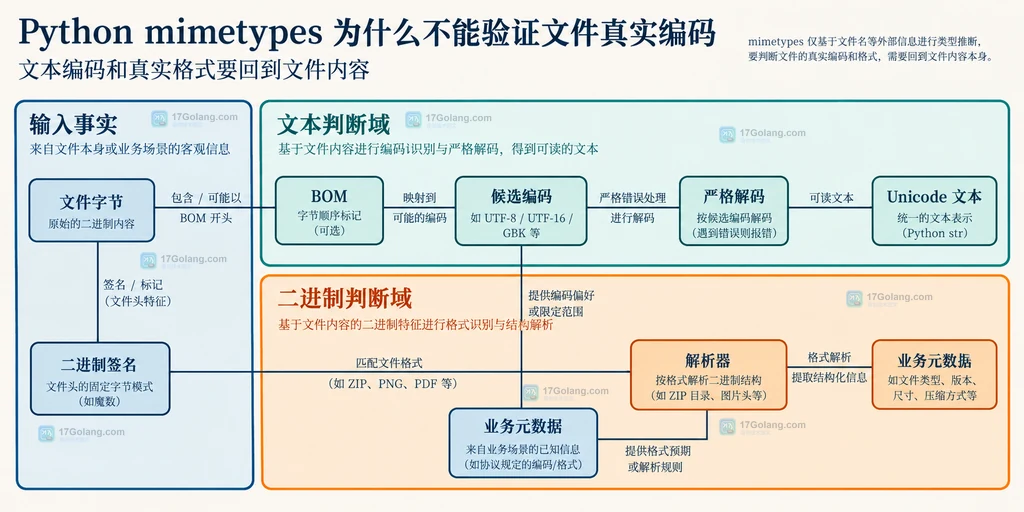
二进制真实格式要检查签名或调用解析器
对 PNG、PDF、ZIP 这类二进制文件,字符编码没有意义。更可靠的初筛方式是读取文件头的固定签名,再用对应格式解析器完成结构检查。下面的示例只展示一个轻量的签名层,不把它包装成完整格式验证。
from pathlib import Path


SIGNATURES = {
    "image/png": b"\x89PNG\r\n\x1a\n",
    "application/pdf": b"%PDF-",
    "application/zip": b"PK\x03\x04",
}


def sniff_binary_type(path: Path) -> str | None:
    # 只读少量文件头,适合做初筛;不要把后缀或短签名当成完整解析。
    header = path.read_bytes()[:16]
    for media_type, signature in SIGNATURES.items():
        if header.startswith(signature):
            return media_type
    return None


def accepts_upload(path: Path, declared_type: str | None) -> bool:
    # 名称层只提供候选,内容层至少要和允许的签名保持一致。
    actual_type = sniff_binary_type(path)
    return actual_type is not None and actual_type == declared_type
签名匹配仍然只是第一道门:恶意或损坏文件可能伪造文件头,真正要处理内容时还需要格式库解析,并设置大小、解压深度、资源消耗和错误处理上限。这个分层比“后缀是 .png,所以内容一定是 PNG”更容易审计。
sndhdr 移除后,不要把 mimetypes 当成音频检测器
Python 官方文档说明,sndhdr 在 3.11 已弃用,并在 3.13 从标准库移除;文档列出的替代方向是 PyPI 上的第三方模块。它们与 mimetypes 的职责不同:前者尝试识别音频内容,后者维护名称到 MIME 的映射。
迁移旧代码时,可以按目标拆分:
- 只需要给音频下载响应设置类型:保留名称层推断,但把它当作声明。
- 需要确认文件确实是某种音频:选择能解析音频头和容器结构的库,并处理解析失败。
- 需要读取采样率、声道或时长:直接使用对应格式的解析器,不要从扩展名反推字段。
如果项目不愿增加第三方依赖,也至少应该把允许的格式、最大大小和后续转码策略写成明确的业务边界,而不是用 mimetypes 的返回值替代内容检查。
上传系统可以按三层组合判断
规模较大的上传服务,通常把检查拆成三个相互独立的层。这样既能保留扩展名带来的用户体验,也不会把一个弱信号误当成事实:
- 声明层:读取文件名、请求头和用户选择,调用
mimetypes得到候选 MIME,仅用于路由和提示。 - 内容层:读取 BOM、文件头或容器元数据;文本使用严格解码,二进制使用签名和轻量解析。
- 业务层:根据允许的媒体类型、大小、字符集和下游处理器做最终决策,记录“为什么接受或拒绝”。
检查记录至少应包含候选 MIME、实际检查方式、解析结果、编码来源和失败原因。不要把 None 当成“文件一定不合法”,也不要把一个非空 MIME 当成“文件已经通过验证”。
| 场景 | 建议组合 | 不要做的事 |
|---|---|---|
| 静态下载响应 | 文件名映射 + 明确的服务端允许列表 | 把 guess 的结果当成安全证明 |
| CSV 或文本导入 | 业务声明 + BOM + 严格解码 + 格式解析 | 用 MIME 推断 UTF-8 |
| 图片或文档上传 | 文件头 + 格式解析 + 大小和资源限制 | 只检查扩展名 |
| 音频处理 | 专用解析器 + 转码或播放前检查 | 用 mimetypes 替代 sndhdr |
常见疑问
mimetypes 返回的 encoding 是 UTF-8 吗?
不是。它通常表示压缩或内容传输相关的编码名称,例如 gzip,适合映射到 Content-Encoding;文本字符集要依据 BOM、协议元数据和实际解码处理。
严格解码成功就能证明编码正确吗?
不能。它只能证明这组字节可以按某个候选解释成文本。多个候选都成功时,仍需要格式约定、元数据或业务规则。
检查魔数后就可以安全处理文件吗?
不能。魔数适合初筛,完整处理仍要用格式解析器,并限制文件大小、嵌套深度和资源消耗。
Python 3.13 中如何替代 sndhdr?
先明确需求:只要声明就用名称层映射;要识别音频内容或读取音频属性,就选能解析目标格式的专用库。不要把 mimetypes 作为等价替代。
总结一下:mimetypes 是“名字到 MIME 的映射表”,不是“字节到真实格式的鉴定器”。把扩展名、字符编码、二进制签名和格式解析放在各自的层里,才能在 Python 版本迁移和文件上传场景中得到可解释、可维护的判断。




