
Karmada多集群调度的新应用场景
来源:17golang原创
时间:2026-11-15 13:48:48 118浏览 收藏
我最近重新看 Karmada,不再把它只理解成“把一个 Deployment 复制到多个 Kubernetes 集群”的工具。CNCF 在 2026 年 9 月宣布 Karmada 毕业,11 月的生态公告又把它放进新一代云原生 AI 基础设施的毕业项目名单里。对平台团队来说,真正值得关注的不是“又一个成熟度标签”,而是多集群调度开始被用来处理更具体的资源、故障和地域问题。
这篇文章把“Karmada多集群调度的新应用场景”拆成四个可以落地判断的方向:混合云容量溢出、多地域容灾、AI 多组件工作负载,以及跨集群服务治理。每个方向都给出适用信号、容易误判的边界和第一次试用时应该留下的运维记录。
官方地址:https://karmada.io/
新闻来源:https://www.cncf.io/announcements/2026/09/07/cloud-native-computing-foundation-announces-karmada-graduation/
Karmada 的新应用场景,不是把所有业务无条件铺到更多集群,而是用统一的 Kubernetes API,把“在哪里运行、何时溢出、怎样故障迁移、哪些组件必须同处”变成明确的策略。新闻可以说明方向,真正能否采用还要看集群标签、资源模型、网络和回退路径。
这次生态消息到底改变了什么判断
CNCF 的毕业公告给出的事实有三层。第一层是项目成熟度:Karmada 已经从 Sandbox 和 Incubating 阶段进入 Graduated。第二层是能力方向:官方公告提到 v1.19 推进分布式 AI 训练任务的多组件调度,并将基于优先级的调度推进到 Beta。第三层是应用压力:混合云容量、多地域韧性、AI 训练、GPU/CPU 调度、跨集群交付和全局配置分发,都被列为实际采用方向。
这三层不能混在一起。毕业不等于每个新特性都已经稳定;生态公告也不是你的集群已经具备 GPU 资源模型、跨地域网络和自动回退能力。我的做法是先问一个更小的问题:业务是否真的需要在多个 Kubernetes 集群之间做“选择”,而不只是想要一个统一的查看入口。
如果答案是需要选择,再看四个信号:候选集群有没有可计算的标签和资源信息,工作负载是否能接受跨集群差异,故障后有没有数据与流量回退方案,策略变更是否能被审计。下面四个场景,分别对应这四类压力。
场景一:本地资源不够时溢出到云集群
混合云扩容是最容易理解、也最容易写成口号的场景。更准确的描述应该是:本地 IDC 是首选集群,公有云集群是有条件的溢出池;只有本地资源不足或进入维护状态时,新增副本才允许落到云上。
Karmada 的 PropagationPolicy 支持按集群名称、标签或字段筛选候选集群,也支持有顺序的 clusterAffinities。官方文档给出的溢出模型就是先尝试主集群组,再把剩余副本交给后备组。这样做的价值不是“自动上云”四个字,而是把成本、数据位置和容量之间的取舍写进调度策略。
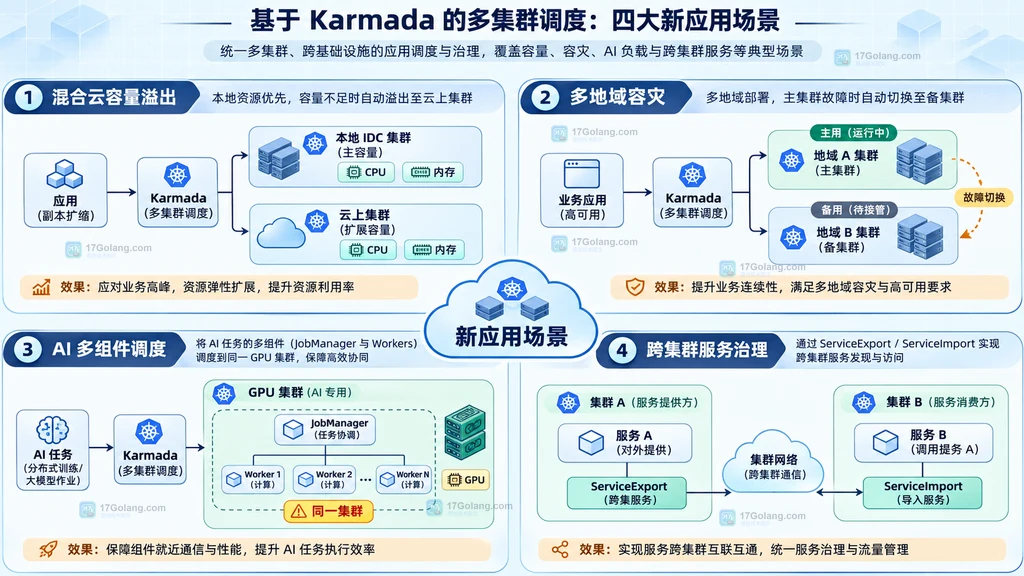
第一次试用时不要直接把生产 Deployment 全量接入。可以先给业务集群贴上 location、provider、capacity-tier 等标签,只选择一个无状态服务,并把溢出动作和云成本告警绑定。观察重点有三个:
- 主集群资源不足时,剩余副本是否确实进入云集群,而不是所有副本重新平均摊开;
- 主集群恢复后,云上的副本是否按预期回收,回收是否会带来流量抖动;
- 镜像、配置、存储类和入口地址是否需要按云厂商做差异化覆盖。
场景二:多地域容灾从备份集群变成调度策略
多地域容灾不只是“再建一套集群”。如果主地域故障,平台还要知道哪些副本可以迁移、哪些集群是候选、服务副本不能同时归零,以及恢复后是否要把流量和副本迁回。
Karmada 官方能力页把跨集群故障迁移、集群污点和不中断服务放在同一组能力里。PropagationPolicy 还可以用 spreadConstraints 按 region 或 cluster 控制分布,用 Duplicated 让多个集群接收完整副本,或用 Divided 把总副本拆到不同集群。具体选择取决于业务是“每个地域都要完整热备”,还是“只需要把总容量分摊出去”。
我会把容灾试用拆成三次,而不是一次故障演练覆盖所有结论:
- 先给一个集群加上不可调度污点,观察策略是否把副本迁移到仍满足候选条件的集群;
- 再模拟控制面能看到的成员集群故障,记录迁移开始、服务副本变化和流量切换的时间点;
- 最后恢复集群,确认是否自动回收、手工回迁,还是需要业务侧重新发布。
这里的关键边界是:Karmada 负责跨集群的资源分发与调度决策,不会替你解决数据库复制、跨地域 DNS、状态存储一致性或业务幂等。带状态服务如果没有独立的数据容灾方案,单纯增加工作负载副本并不能自动变成灾备。
场景三:AI 训练把多组件调度推到前台
AI 工作负载让“一个 Deployment 的副本数”不再足够描述需求。Flink、Ray、分布式训练任务通常有不同的组件模板:有的组件需要 GPU,有的组件需要大内存,有的组件还要和其他组件保持低延迟连接。Karmada 文档把这类能力称为多组件调度,并说明调度器会按组件的资源需求判断候选集群。
这里要特别标出当前边界:官方多组件调度文档仍说明该能力处于 Alpha,且一个工作负载的所有组件当前必须调度到同一个集群,暂不支持把一个多组件工作负载拆到多个集群。CNCF 关于 v1.19 的公告则说明,项目正在推进面向分布式 AI 训练的多组件调度和优先级调度。也就是说,“支持 AI 多集群”应该理解为正在增强的能力方向,而不是可以把 JobManager、Worker 和共享依赖随意拆散。
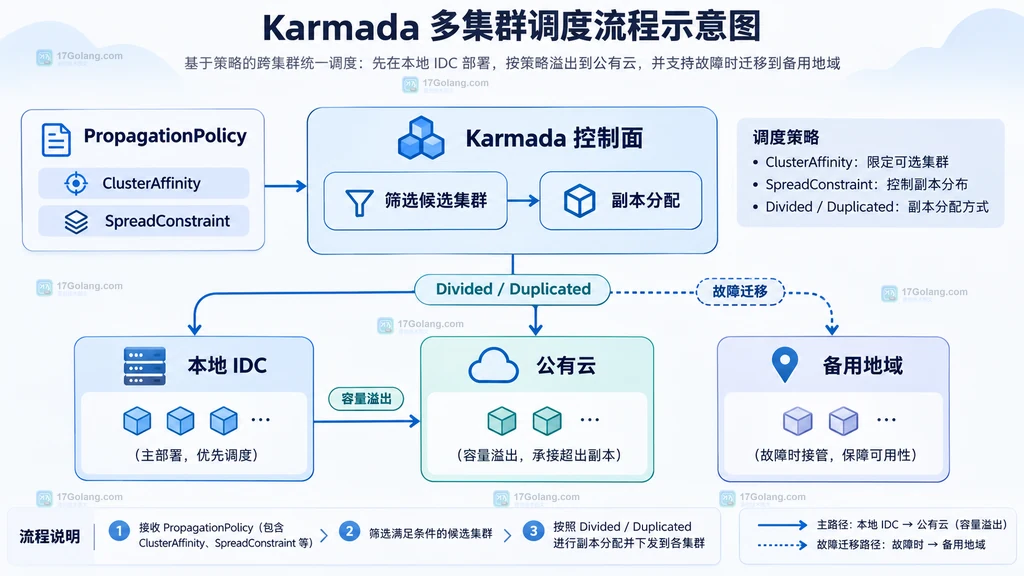
AI 试用应先建立资源事实,再讨论调度算法。至少记录以下内容:
- 成员集群的 GPU 型号、数量、可分配余量和驱动/运行时兼容性;
- 训练任务各组件的 CPU、内存、GPU 与存储需求;
- 优先级、队列和抢占策略是否已经在当前版本与部署方式中启用;
- 任务失败后是重试、迁移还是由训练框架负责恢复。
如果这些信息没有进入集群资源模型,调度器看到的只是“有一台空闲机器”,而不是“有一台能完整承载这组组件、镜像和网络要求的机器”。这也是 AI 场景比普通无状态服务更需要先做小规模验证的原因。
场景四:跨集群服务治理与边缘流量分配
当业务已经分布在多个地域或多种云环境,问题往往从“把 Pod 放哪儿”变成“服务怎样互相发现、流量怎样走、配置怎样保持一致”。Karmada 能力页列出 ServiceExport/ServiceImport 跨集群服务发现、Submariner 跨集群网络,以及与 ErieCanal 集成进行跨集群服务治理。
这个场景的投入通常比单纯副本分发更大,因为它同时涉及网络连通、服务身份、入口层和故障时的流量决策。比较稳妥的切入点是选择一个只读或幂等接口,先验证服务发现和跨集群访问,再把调度策略与流量策略关联起来。不要把“资源已经传播”误认为“服务已经可用”:Deployment 的 Ready、Service 的可达性和真实请求链路是三件事。
边缘场景也可以沿用这个思路:用集群标签表达地域、网络质量或设备能力,用传播策略筛选候选集群,用服务治理层处理请求到达。地域字段和网络状态变化时,要明确是触发重调度、切换流量,还是仅记录告警,避免多个控制器同时做迁移。
一次可回退的 Karmada 试用怎么安排
下面的示例只展示策略形状,不代表任何真实集群已经执行。它把本地集群作为首选组,把云集群作为溢出组,并使用按可用副本动态分配的方式承接容量变化。实际接入前,需要把集群名称、资源选择器和副本数量替换成自己的环境。
apiVersion: policy.karmada.io/v1alpha1
kind: PropagationPolicy
metadata:
  name: checkout-overflow
  namespace: production
spec:
  resourceSelectors:
    - apiVersion: apps/v1
      kind: Deployment
      name: checkout
  placement:
    clusterAffinities:
      # 首选本地 IDC,先满足数据位置和低延迟要求。
      - affinityName: local-idc
        clusterNames:
          - idc-east-1
          - idc-east-2
        overflowAffinities:
          # 本地容量不足时才把剩余副本交给云集群。
          - affinityName: public-cloud
            clusterNames:
              - cloud-east-1
              - cloud-east-2
    replicaScheduling:
      # 总副本数按目标集群的可用容量动态拆分。
      replicaSchedulingType: Divided
      replicaDivisionPreference: Weighted
      weightPreference:
        dynamicWeight: AvailableReplicas
实际操作时,我会先只传播一个 Deployment,并把策略变更、成员集群状态、ResourceBinding、服务副本数和业务请求指标放在同一张记录里。若发现云集群的镜像、StorageClass 或配置不兼容,先撤销该工作负载的传播策略,再恢复原来的单集群发布流程;不要在故障现场继续叠加 OverridePolicy 和流量切换。
# 查看成员集群和策略对象,先确认候选范围没有写错。
kubectl --kubeconfig "$KARMADA_KUBECONFIG" get clusters --show-labels
kubectl --kubeconfig "$KARMADA_KUBECONFIG" -n production get propagationpolicy checkout-overflow -o yaml

# 只观察资源绑定和服务状态,不把这组命令当成线上验收结论。
kubectl --kubeconfig "$KARMADA_KUBECONFIG" -n production get resourcebindings,workloadbindings
kubectl --kubeconfig "$KARMADA_KUBECONFIG" -n production get deploy checkout
回滚路径要在试用前写好:删除或暂停对应的 PropagationPolicy,保留原集群中的资源清单和镜像版本,恢复业务入口到原有集群;如果已经发生副本迁移,还要确认云侧副本、临时存储和流量记录是否需要单独清理。回滚不是“把 YAML 删掉”这么简单,而是要把资源、流量和成本三个状态一起收回来。
哪些信号说明暂时不要扩大范围
| 观察到的信号 | 更可能的原因 | 先做什么 |
|---|---|---|
| 候选集群始终为空 | 标签、字段或污点容忍不匹配 | 缩小 ResourceSelector,逐项核对 ClusterAffinity |
| 副本到了云集群但服务不可用 | 镜像、配置、存储或入口没有做差异化 | 先补齐 OverridePolicy 与服务链路,再扩大工作负载范围 |
| 故障迁移后副本短时归零 | 副本策略、健康信号或流量切换不满足不中断条件 | 暂停自动扩围,做小规模故障演练并记录时间线 |
| AI 组件无法被同一集群完整承载 | 资源模型或组件解释器没有表达真实需求 | 先检查多组件调度开关、CRD 解释器和 GPU 资源状态 |
| 跨集群请求延迟明显升高 | 网络与服务治理层没有配套 | 先把资源传播和流量治理拆开观测 |
我的结论:先选一个压力点,再让策略变复杂
这轮 Karmada 消息最值得平台团队吸收的,不是“多集群终于可以自动化”这种宽泛结论,而是调度对象正在从普通副本扩展到资源容量、地域韧性、异构 AI 组件和服务治理。不同场景需要不同的证据:混合云要看容量与成本,容灾要看故障时间线,AI 要看组件和加速器,服务治理要看网络与真实请求。
如果你的团队刚开始接触 Karmada,我建议顺序是:先用一个无状态服务验证集群筛选,再验证一次本地到云的溢出;接着做可控的污点迁移;最后才尝试 AI 多组件或跨集群服务治理。每一步都保留明确的回滚路径,不要因为项目已经毕业,就跳过自己的兼容性和运维证据。
相关问题
Karmada 适合替代多个集群各自发布吗?
它更适合把跨集群的资源传播、放置和故障策略集中管理,而不是强行替代所有团队已有的发布工具。应用仍然要处理配置、存储、网络和流量差异。
多组件 AI 任务能否把不同组件分到不同集群?
当前官方多组件调度文档明确写出,工作负载的所有组件必须调度到同一集群,跨集群组件拆分尚不支持。应把跨集群拆分视为后续方向,不要在当前试用中默认它已经可用。
PropagationPolicy 和 ClusterPropagationPolicy 怎么选?
前者通常用于命名空间范围的资源传播,后者用于集群范围的策略。先按资源的作用域和团队权限选择,再处理优先级、覆盖策略与回滚责任。
Karmada 会自动解决数据库跨地域一致性吗?
不会。它可以参与工作负载传播和故障迁移,但数据库复制、一致性、备份恢复和写入切换仍需要数据库自身或专门的数据平台方案。
资料入口
Karmada 官方文档:https://karmada.io/docs/v1.18/
调度策略文档:https://karmada.io/docs/next/userguide/scheduling/propagation-policy/
多组件调度文档:https://karmada.io/docs/next/userguide/scheduling/multi-component-scheduling/
CNCF 毕业公告:https://www.cncf.io/announcements/2026/09/07/cloud-native-computing-foundation-announces-karmada-graduation/
-
214 收藏
-
Golang · Go教程 | 5个月前 | 性能优化 · kubernetes · Go教程 · 生产实践 · Go1.25 · golang Go Kubernetes 性能优化 GOMAXPROCS473 收藏
-
Golang · Go教程 | 3个月前 | 容器 · go · 性能 · kubernetes · 运行时 · Kubernetes GOMAXPROCS cgroup Go 1.25 容器 CPU 限额438 收藏
-
318 收藏
-
353 收藏
-
495 收藏
-
374 收藏
-
158 收藏
-
253 收藏
-
科技周边 · 业界新闻 | 29分钟前 | 依赖管理 · rust · Cargo Rust 1.100 unused dependencies cargo check dev-dependencies414 收藏
-
384 收藏
-
251 收藏
-
327 收藏
-
184 收藏
-
479 收藏
-
266 收藏
-
469 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习