
Go xml.Encoder.Flush 怎样确保分段 XML 已写入 Writer
来源:17golang原创
时间:2026-11-15 21:34:59 237浏览 收藏
我在把 XML 结果分批写给下游服务时遇到过一个很容易误判的现象:代码已经打印“批次完成”,但接收方迟迟看不到这一批内容。问题通常不在 EncodeToken 本身,而在于 xml.Encoder 和它下面的 io.Writer 可能各自还有一层缓冲。
官方地址:https://pkg.go.dev/encoding/xml#Encoder.Flush
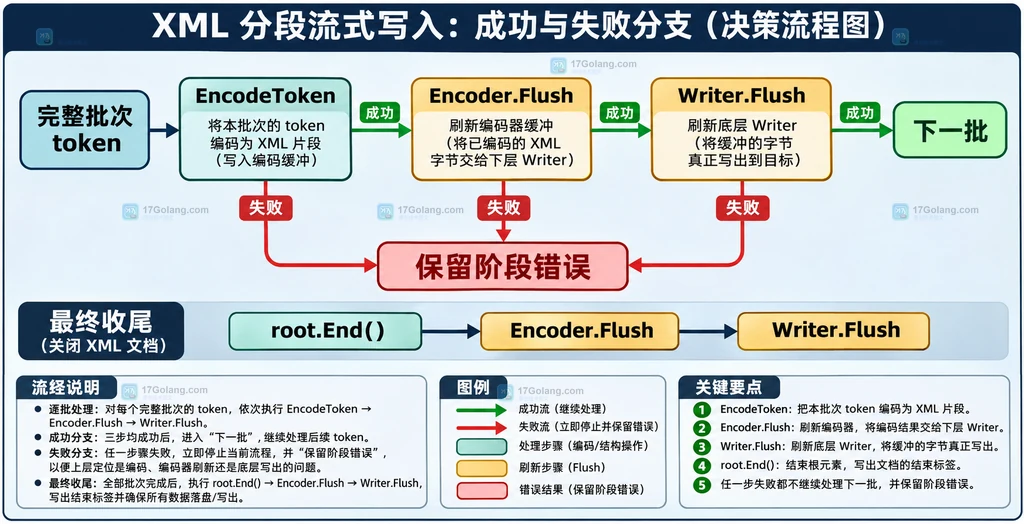
正确的分段写法是:先完成当前批次的 XML token,再调用Encoder.Flush;如果持有的底层对象还是bufio.Writer,还要继续调用它的Flush。两个刷新动作解决的是两层不同的缓冲,任何一个返回错误都不能被忽略。
先分清两个 Flush 到底刷新什么
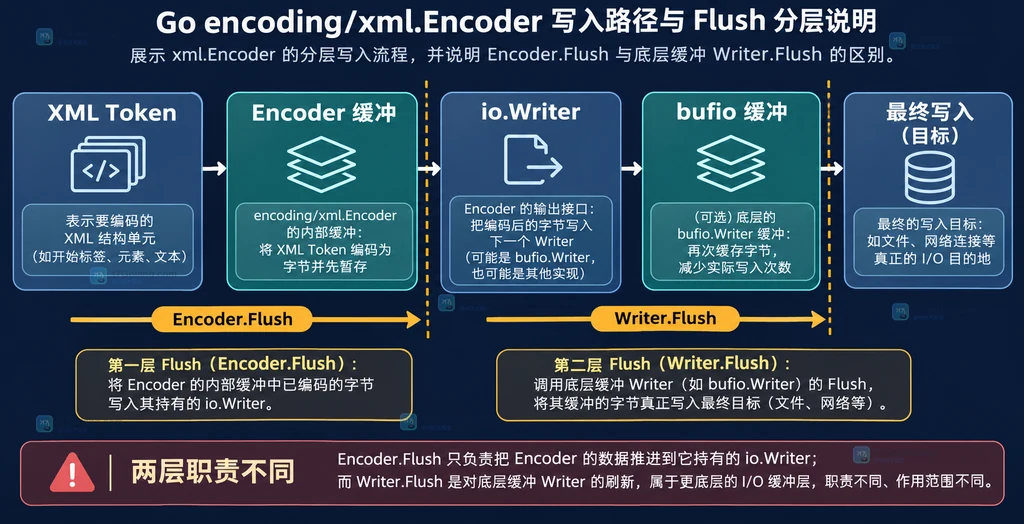
xml.NewEncoder(w) 只知道它拿到了一个 io.Writer。Encoder.Flush 的职责是把编码器已经准备好的 XML 写向这个 Writer;如果这个 Writer 自己又是 bufio.Writer,数据还可能停在 bufio 的缓冲区里。
| 层级 | 动作 | 解决的问题 |
|---|---|---|
| XML 编码器 | enc.Flush() | 把 Encoder 内部暂存的 XML 推给它持有的 Writer |
| 下层缓冲 Writer | buf.Flush() | 把 bufio 中的字节继续推给文件、网络或自定义接收器 |
| 最终设备 | 由 Writer 实现决定 | 例如文件写入、HTTP 响应或管道消费的具体语义 |
先把一批 XML token 写完整
分段输出不代表可以在任意位置刷新。一个实用的批次通常包含完整的子元素,例如一个 item 的开始标签、属性、文本和结束标签。这样下游即使按批次读取,也不会在元素内部被截断。
package main

import (
	"encoding/xml"
	"fmt"
	"io"
)

func writeItem(enc *xml.Encoder, id, name string) error {
	// 每个批次先写一个完整的 item,避免在元素内部暴露半截结构。
	start := xml.StartElement{Name: xml.Name{Local: "item"}, Attr: []xml.Attr{
		{Name: xml.Name{Local: "id"}, Value: id},
	}}
	if err := enc.EncodeToken(start); err != nil {
		return fmt.Errorf("写入 item 开始标签失败: %w", err)
	}

	// CharData 会按 XML 规则转义文本中的特殊字符。
	if err := enc.EncodeToken(xml.CharData(name)); err != nil {
		return fmt.Errorf("写入 item 文本失败: %w", err)
	}
	if err := enc.EncodeToken(start.End()); err != nil {
		return fmt.Errorf("写入 item 结束标签失败: %w", err)
	}
	return nil
}

func writeBatch(w io.Writer, id, name string) error {
	enc := xml.NewEncoder(w)
	if err := writeItem(enc, id, name); err != nil {
		// token 编码失败时不要继续 Flush,调用方应保留原始错误。
		return err
	}
	if err := enc.Flush(); err != nil {
		// 这里的错误表示 XML 编码器向 w 推送字节时失败。
		return fmt.Errorf("刷新 XML 编码器失败: %w", err)
	}
	return nil
}
这个函数适合直接把一个批次推给普通 io.Writer。如果 w 是带缓冲的 Writer,还需要在更外层处理它的刷新,否则“Encoder 已刷新”并不等于“底层设备已收到”。
分段写入时把 Encoder 复用起来
如果每个批次都重新创建 Encoder,XML 的嵌套状态会被拆散,而且很难写出一个完整文档。更稳妥的方式是创建一次 Encoder,让它贯穿同一份 XML 的开始、多个批次和最终结束;批次边界只负责把已经完成的 token 推出去。
package main

import (
	"bufio"
	"encoding/xml"
	"fmt"
	"io"
)

func streamItems(out io.Writer, items []string) error {
	// bufio 只负责下一层字节缓冲,Encoder 负责 XML token 编码。
	buffered := bufio.NewWriter(out)
	enc := xml.NewEncoder(buffered)

	root := xml.StartElement{Name: xml.Name{Local: "items"}}
	if err := enc.EncodeToken(root); err != nil {
		return fmt.Errorf("写入根元素失败: %w", err)
	}

	for index, item := range items {
		if err := writeItem(enc, fmt.Sprint(index+1), item); err != nil {
			return err
		}

		// 当前 item 已完整结束,先刷新 Encoder,让它向 buffered 写入。
		if err := enc.Flush(); err != nil {
			return fmt.Errorf("第 %d 批刷新 Encoder 失败: %w", index+1, err)
		}
		// 继续刷新下一层,才能把字节交给真正的输出 Writer。
		if err := buffered.Flush(); err != nil {
			return fmt.Errorf("第 %d 批刷新底层 Writer 失败: %w", index+1, err)
		}
	}

	if err := enc.EncodeToken(root.End()); err != nil {
		return fmt.Errorf("写入根元素结束标签失败: %w", err)
	}
	if err := enc.Flush(); err != nil {
		// 文档最后的收尾也可能触发写入错误,不能只检查循环内部。
		return fmt.Errorf("收尾刷新 Encoder 失败: %w", err)
	}
	if err := buffered.Flush(); err != nil {
		return fmt.Errorf("收尾刷新底层 Writer 失败: %w", err)
	}
	return nil
}
这里有两个关键点:一是 Encoder 没有在循环中重建,二是每个批次的两个刷新动作顺序固定为“先编码器、后下层缓冲”。如果输出对象不是 bufio.Writer,可以省略第二层,但应该根据实际 Writer 的契约判断,而不是凭日志猜测。
三个阶段的错误要分别保留
分段 XML 至少有三类错误:token 不能编码、Encoder 刷新时底层 Writer 返回错误、下层缓冲最终写出失败。它们发生的位置不同,排障信息也不同。不要在循环里只设置一个布尔值,最后再统一返回一个“写入失败”。
type batchError struct {
	Stage string
	Index int
	Err   error
}

func flushBatch(enc *xml.Encoder, buffered interface{ Flush() error }, index int) *batchError {
	if err := enc.Flush(); err != nil {
		// 先标记 Encoder 阶段,避免把下一层错误混成同一类。
		return &batchError{Stage: "encoder-flush", Index: index, Err: err}
	}
	if err := buffered.Flush(); err != nil {
		// 下层刷新失败通常更接近文件、网络或管道的实际故障。
		return &batchError{Stage: "writer-flush", Index: index, Err: err}
	}
	return nil
}
真实项目中可以把 Stage 作为日志字段,把 Index 作为批次定位信息。错误一旦出现就应停止继续写,因为 XML 流已经不能简单地假设后面的批次仍然能独立恢复。
最终收尾不能省略
中间批次的 Flush 只是把已经完成的片段推送出去,不能替代最终的根元素闭合。若写的是一份完整 XML 文档,循环结束后必须先写 root.End(),再按相同顺序刷新两层 Writer。否则下游可能收到一段可读的前缀,却在文档结束时发现结构没有闭合。
另一个常见误区是把 Encoder.Flush 当成“提交成功”。它只能返回当前编码器向其 Writer 写入时遇到的错误;下层 Writer 是否还缓存、是否需要显式刷新、是否有远端确认,都由更下层的协议决定。
怎样选择批次大小
| 场景 | 建议 | 代价 |
|---|---|---|
| 实时推送小事件 | 每个完整事件刷新一次 | 系统调用和网络写入更频繁 |
| 大量离线导出 | 积累多个完整元素后再刷新 | 延迟增加,单次失败影响的批次更大 |
| 长连接下游 | 按协议约定的可消费边界刷新 | 需要同时理解 XML 结构和传输层缓冲 |
批次大小不是越小越好。先确定下游需要多快看到数据,再决定刷新频率;无论选哪种粒度,都要保留批次编号和三阶段错误位置,便于失败后判断是否能从某个完整元素重新开始。
常见问题
调用 Encoder.Flush 后为什么文件大小还没变化?
如果 Encoder 持有的是 bufio.Writer,数据可能仍在 bufio 缓冲区里。继续调用底层 Writer 的 Flush,并检查它返回的错误。
每写一个元素都必须 Flush 吗?
不必须。实时性要求高时可以缩小批次;离线导出可以积累多个完整元素,减少刷新次数。关键是不要在元素结构中间制造读者无法判断的边界。
Encoder.Flush 返回 nil 就代表远端已经处理了吗?
不代表。它只说明当前编码器向它的 Writer 写入时没有报告错误;网络发送、服务端解析和业务确认仍属于更后面的协议层。
为什么不直接使用 xml.Marshal?
Marshal 适合一次性把值编码成字节切片;当数据量大、需要持续推送或希望控制批次边界时,复用 Encoder 并按 token 分段刷新更容易控制内存和延迟。
总结一下:把 Encoder.Flush 看成 XML 编码层的刷新,把 bufio.Writer.Flush 看成下一层的刷新;每个批次先完成完整 token,再按层级顺序刷新,并保留每一步的错误。这样“批次完成”的日志才和实际写出边界一致。
-
860 收藏
-
843 收藏
-
826 收藏
-
809 收藏
-
792 收藏
-
148 收藏
-
350 收藏
-
Golang · Go教程 | 15分钟前 | 错误处理 · 文件读取 · csv · Go教程 · 数据导入 · csv Go encoding/csv csv.Reader FieldsPerRecord ErrFieldCount101 收藏
-
316 收藏
-
476 收藏
-
416 收藏
-
127 收藏
-
337 收藏
-
297 收藏
-
271 收藏
-
196 收藏
-
482 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习