
Go go/ast.BasicLit.Kind 怎样判断字面量的类型
来源:17golang原创
时间:2026-11-19 01:31:44 192浏览 收藏
做 Go 源码分析时,字面量往往是最早需要分类的一批节点:配置值、数组下标、常量声明和函数参数里都可能出现它们。go/ast.BasicLit 把这类节点统一表示出来,而真正适合用来判断类别的字段是 Kind。
官方文档:https://pkg.go.dev/go/ast#BasicLit
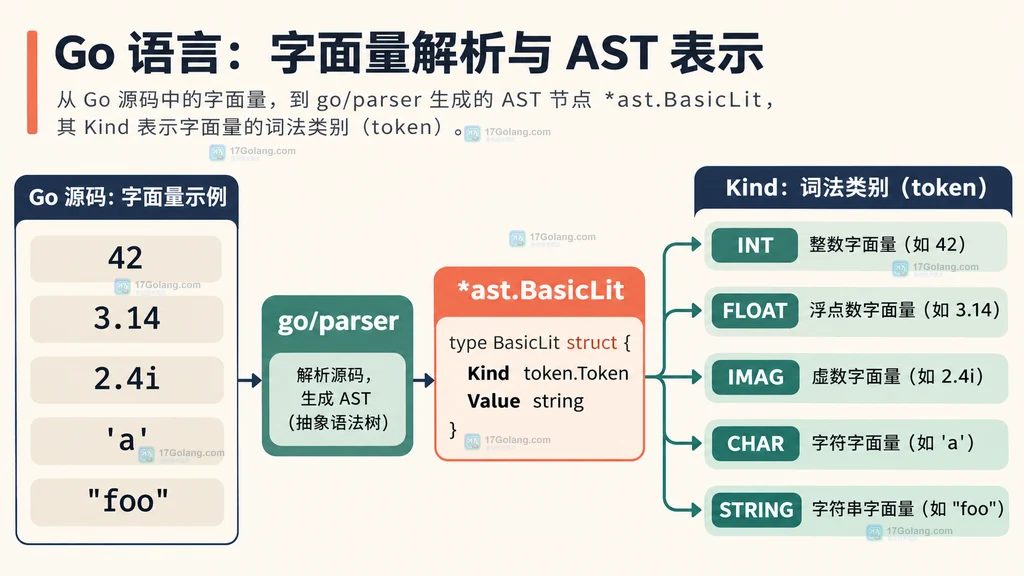
BasicLit.Kind是一个token.Token,可表示INT、FLOAT、IMAG、CHAR或STRING。Value则保留字面量在源码中的文本形式;分类和解码是两个不同步骤。
- 先用
parser.ParseFile得到 AST,再用ast.Inspect找*ast.BasicLit。 - 用
lit.Kind与token.INT等常量比较,不要根据Value的字符串前缀猜类型。 Value适合保留源码文本,FileSet.Position适合输出行列位置。- 带引号的字符和字符串仍然保留引号;需要解码时再调用
strconv。
先把 BasicLit 的四个字段放回数据流
可以把一个基础字面量看成一条小型数据记录:Kind 负责分类,Value 负责保存原始文本,ValuePos 和 ValueEnd 负责标出它在源文件中的范围。它们共同描述“这是什么、写成什么、出现在哪里”,但不负责把文本转换成业务层的数字或字符。
例如源码中的 42 会成为 Kind == token.INT 的节点,3.14 会成为 token.FLOAT,2.4i 会成为 token.IMAG。字符和字符串的引号属于 Value 的一部分,因此不要把 Value 误认为已经解码后的内容。
从 Go 源码找到 BasicLit 节点
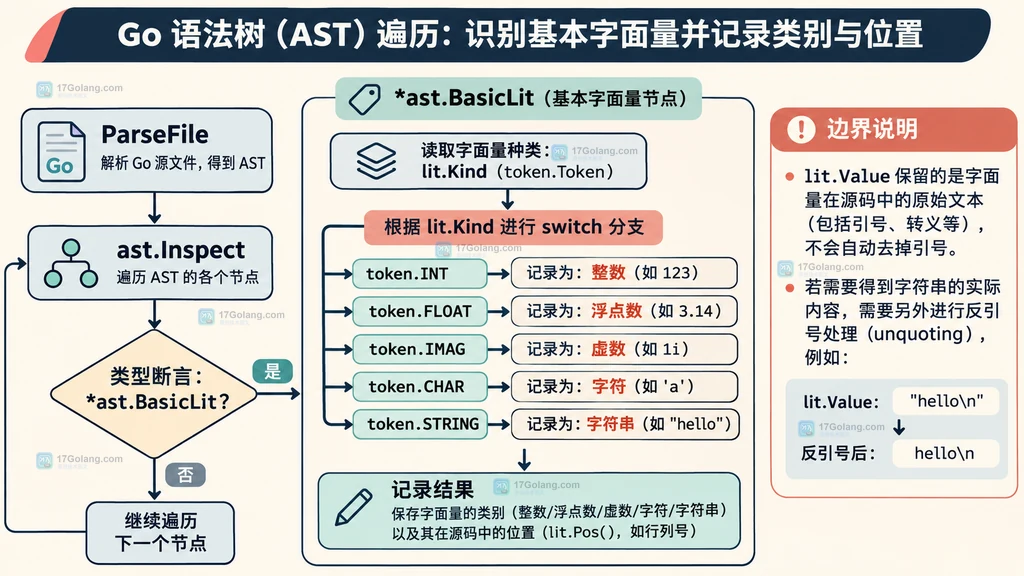
AST 通常由 go/parser.ParseFile 产生。解析之后,可以使用 ast.Inspect 深度遍历所有节点,在回调里做一次类型断言。这样分类逻辑只会作用于真正的 *ast.BasicLit,不会把标识符、二元表达式或函数调用混在一起。
package main

import (
    "fmt"
    "go/ast"
    "go/parser"
    "go/token"
)

func main() {
    const source = `package demo

var count = 42
var rate = 3.14
var mask = 2.4i
var letter = '中'
var message = "hello"
`

    files := token.NewFileSet()
    file, err := parser.ParseFile(files, "demo.go", source, 0)
    if err != nil {
        // 解析失败时没有可靠的 AST,先把错误交给调用方。
        panic(err)
    }

    ast.Inspect(file, func(node ast.Node) bool {
        lit, ok := node.(*ast.BasicLit)
        if !ok {
            // 返回 true 继续走子节点;非 BasicLit 节点不参与分类。
            return true
        }

        position := files.Position(lit.Pos())
        fmt.Printf("%s %s %q\\n", position, lit.Kind, lit.Value)
        return true
    })
}
这里的断言使用了指针类型,因为 AST 中的节点实现是以指针形式出现的。回调返回 true 表示继续遍历;如果某个节点已经完成了你需要的处理,也可以根据遍历策略返回 false 来剪枝。
用 Kind 做稳定的分类分流
Kind 的类型是 token.Token,因此应直接与 token.INT、token.FLOAT、token.IMAG、token.CHAR 和 token.STRING 比较。与其检查 Value 是否包含小数点、引号或 i,不如让词法分析阶段已经得到的 token 分类成为唯一入口。
func classifyLiteral(lit *ast.BasicLit) (string, bool) {
    // Kind 是语法分类;Value 只是源码文本,不用它猜类型。
    switch lit.Kind {
    case token.INT:
        return "integer", true
    case token.FLOAT:
        return "float", true
    case token.IMAG:
        return "imaginary", true
    case token.CHAR:
        return "character", true
    case token.STRING:
        return "string", true
    default:
        // 保留未知分支,避免未来 token 扩展时静默误分类。
        return "unknown", false
    }
}
这个函数只回答“节点属于哪一类”。它没有尝试计算 1 + 2 的结果,也没有判断一个常量最终会被赋予什么静态类型,这正好保持了 BasicLit.Kind 的问题边界。
同时保存 Value 和源码位置
做重构工具、索引器或诊断器时,分类结果通常还需要和原始文本、行列位置一起保存。lit.Value 能保留源码写法,例如十六进制整数仍然带有它的前缀;files.Position(lit.Pos()) 则把抽象的 token.Pos 转为文件名、行号和列号。
type LiteralRecord struct {
    Category string
    Source   string
    File     string
    Line     int
    Column   int
}

func recordLiteral(fset *token.FileSet, lit *ast.BasicLit) (LiteralRecord, bool) {
    category, ok := classifyLiteral(lit)
    if !ok {
        return LiteralRecord{}, false
    }

    position := fset.Position(lit.Pos())
    return LiteralRecord{
        Category: category,
        Source:   lit.Value,
        File:     position.Filename,
        Line:     position.Line,
        Column:   position.Column,
    }, true
}
把 Source 和 Category 同时保留下来很实用:前者用于生成诊断或做精确替换,后者用于统计和规则匹配。不要把 token.Pos 直接当作用户可读的行号,它必须依赖对应的 FileSet 解释。
分类不等于解码:字符和字符串要另处理
官方文档特别说明,CHAR 和 STRING 的 Value 会带着引号保存。比如字符串节点的值可能是 "hello",而不是已经去掉引号的 hello。如果业务需要真正的字符串内容,应在确认 Kind 后再使用 strconv.Unquote;字符则可以考虑 strconv.UnquoteChar。
func decodeText(lit *ast.BasicLit) (string, error) {
    switch lit.Kind {
    case token.STRING:
        // Unquote 负责去掉 Go 字符串字面量的引号并处理转义。
        return strconv.Unquote(lit.Value)
    case token.CHAR:
        // UnquoteChar 返回一个 rune 及其消耗的字节数。
        value, _, _, err := strconv.UnquoteChar(lit.Value[1:], '\'')
        if err != nil {
            return "", err
        }
        return string(value), nil
    default:
        // 数字类字面量仍然先保留 Value,按业务需要选择解析器。
        return lit.Value, nil
    }
}
上面的函数示范了职责分层:Kind 决定调用哪个解码器,Value 提供输入文本。数字字面量如果还要做精确计算,应根据目标类型选择 strconv 或 go/constant,不要把“语法分类”误当成“完成了语义求值”。
常见误区与边界
- 用字符串猜类别:十六进制、原始字符串和带转义的字符会让前缀判断变得脆弱,优先使用
Kind。 - 忽略未知分支:将来 token 集合出现变化时,显式的
default更容易暴露问题。 - 混淆位置对象:
ValuePos是文件集中的位置标识,只有配套的FileSet才能转换为行列。 - 把 Value 当解码结果:带引号的
CHAR和STRING需要单独处理转义。 - 越过问题边界:
BasicLit.Kind不能替代常量求值、类型检查或编译器语义分析。
小结
go/ast.BasicLit.Kind 适合做源码层面的第一层分类。稳定的处理链路是:用 parser.ParseFile 得到 AST,用 ast.Inspect 找到 *ast.BasicLit,用 Kind 对照 token 常量分流,再按需要保存 Value 和通过 FileSet 解释过的位置。完成分类后,字符和字符串的解码、数字的精确解析以及更高层的类型判断,分别交给对应的专用工具。
-
369 收藏
-
344 收藏
-
464 收藏
-
327 收藏
-
349 收藏
-
389 收藏
-
Golang · Go教程 | 19分钟前 | 标准库 · 正则表达式 · Go教程 · 兼容性 · 正则表达式 Go POSIX ERE regexp.CompilePOSIX leftmost-longest189 收藏
-
305 收藏
-
143 收藏
-
105 收藏
-
472 收藏
-
Golang · Go教程 | 1小时前 | TLS · Go教程 · net/http · Go httptrace.ClientTrace TLSHandshakeStart TLSHandshakeDone HTTPS耗时442 收藏
-
Golang · Go教程 | 1小时前 | Go教程 · net/http · tls Transport HTTP请求调试 Request.Body Go net/http/httputil.DumpRequestOut 客户端请求 敏感数据脱敏151 收藏
-
391 收藏
-
Golang · Go教程 | 1小时前 | 错误处理 · HTTP服务 · Go教程 · net/http · handler HTTP上传 MaxBytesReader 请求体大小 Go net/http.MaxBytesHandler385 收藏
-
402 收藏
-
254 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习