
我第一次在 AST 工具里处理源码位置时,最容易混淆的是两个“偏移”:token.Pos 看起来像一个整数,但它不是当前文件从 0 开始的字节索引;而 token.File.Offset 返回的才是相对于这个文件起点的 offset。把这两个概念分开,后面的切片、诊断和源码高亮都会顺很多。
先分清 token.Pos 与文件内 offset
token.FileSet 会把每个文件放进一个互不重叠的位置区间。文件登记时有一个 base 和一个 size,某个文件内的 offset 会被映射为 base + offset,这就是属于该文件的 token.Pos。所以多个文件可以共享一套位置类型,但每个文件仍然有自己的局部字节坐标。
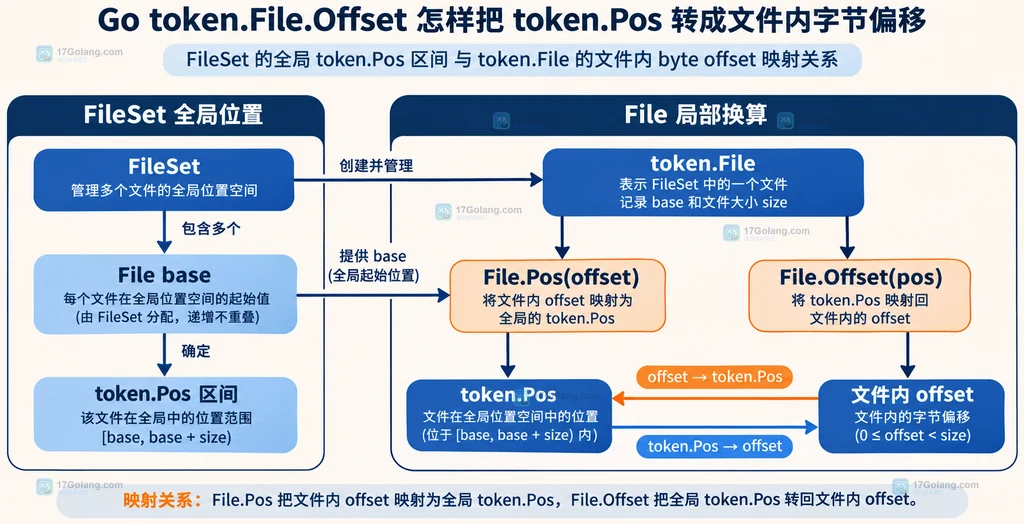
如果你的目标是展示“第几行第几列”,可以交给 FileSet.Position;如果你的目标是从原始源码字节切片,应该先拿到对应的 *token.File,再调用 File.Offset。
最小配方:用 File.Pos 和 File.Offset 往返
下面的例子故意从一个已知的文件内 offset 开始。这样最容易看出两个 API 的职责:File.Pos 做正向映射,File.Offset 做反向映射。
package main

import (
	"fmt"
	"go/token"
)

func main() {
	fset := token.NewFileSet()
	file := fset.AddFile("demo.go", -1, 24)

	// 文件内第 9 个字节,对应一个属于 demo.go 的 token.Pos。
	pos := file.Pos(9)

	// 再把 token.Pos 换回 demo.go 内的字节偏移。
	offset := file.Offset(pos)

	fmt.Printf("pos=%d offset=%d\\n", pos, offset)
}
这里的 offset 是从 demo.go 起点计算的 0 基字节位置。不要把 int(pos) 直接当成它:pos 还包含了这个文件在 FileSet 中的 base。
关键边界:File.Offset 会把位置钳回文件范围
File.Offset 的实用之处在于它定义了边界行为。传入 NoPos 或文件起点之前的位置,结果是 0;传入文件范围内的位置,结果是对应的文件内 offset;超过文件结束位置,结果会被钳到 File.Size()。这使它适合在拿到 AST 节点位置后做保护性换算,但不代表一个无效位置突然变成了有效语义。
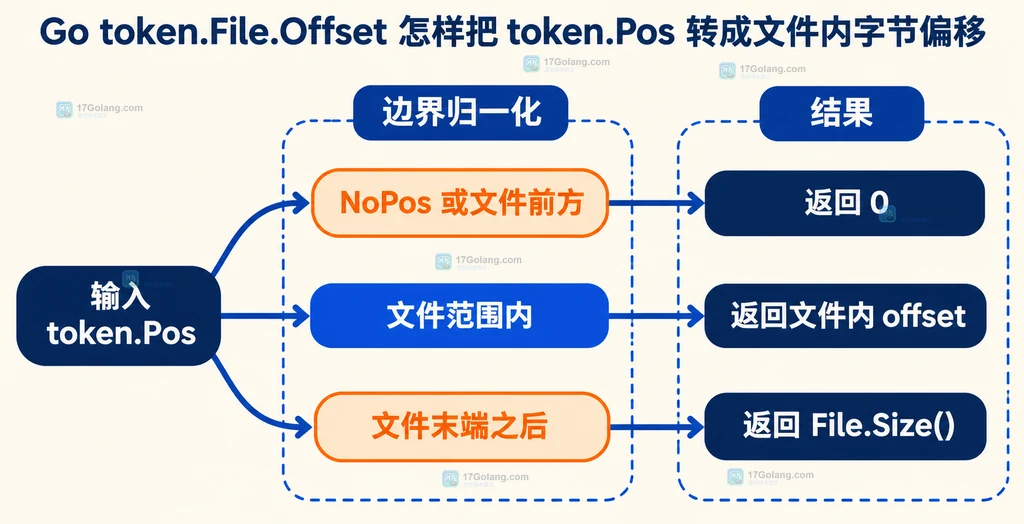
文档还给出一个很有用的往返关系:对合法的文件内 offset,f.Offset(f.Pos(offset)) 会回到原来的 offset。反方向的 f.Pos(f.Offset(p)) == p 则只对落在文件位置区间里的合法 token.Pos 成立;任意整数都不能自动成为合法的文件位置。
把配方接到 AST 节点上
解析器返回的节点通常只给你 Pos() 和 End()。真正要切源码时,先让 FileSet 找到节点所属的 File,再分别转换起止位置:
func nodeBytes(src []byte, fset *token.FileSet, node interface {
	Pos() token.Pos
	End() token.Pos
}) []byte {
	file := fset.File(node.Pos())
	if file == nil {
		return nil
	}

	start := file.Offset(node.Pos())
	end := file.Offset(node.End())
	if start < 0 || end < start || end > len(src) {
		return nil
	}
	return src[start:end]
}
这个函数有两个前提:src 必须就是这个 File 登记时对应的内容,并且节点的起止位置属于同一个文件。跨文件节点、合成节点或没有位置的节点,不能只靠一对整数切片解决。
几个容易踩到的坑
- 把 token.Pos 当数组下标:先用
File.Offset,不要直接把int(pos)喂给src[pos:]。 - 混淆行列与字节:
Position.Line和Position.Column是展示信息;多字节 UTF-8 文本中,列号不等于字节数。 - 忽略 FileSet.File 返回 nil:位置不属于当前文件集时,先处理 nil,再进入 offset 计算。
- 把边界钳位当成校验:越界位置得到 0 或
File.Size(),需要额外判断原始位置是否真的落在节点或文件范围内。
完整片段:同时保留展示位置与字节范围
func describe(node interface {
	Pos() token.Pos
	End() token.Pos
}, fset *token.FileSet) (token.Position, token.Position, int, int, bool) {
	file := fset.File(node.Pos())
	if file == nil {
		return token.Position{}, token.Position{}, 0, 0, false
	}

	start, end := node.Pos(), node.End()
	startOffset := file.Offset(start)
	endOffset := file.Offset(end)
	if endOffset < startOffset {
		return token.Position{}, token.Position{}, 0, 0, false
	}

	// 行列用于人读,offset 用于切源码;两套坐标各自承担不同职责。
	return fset.Position(start), fset.Position(end), startOffset, endOffset, true
}
我现在处理这类源码位置时,会把它记成一句很简单的规则:token.Pos 是 FileSet 坐标,File.Offset 是 File 坐标,展示用 Position,切字节用 offset。只要先找对 *token.File,就不会因为 base、行列或 UTF-8 字节长度混在一起而误切源码。




