
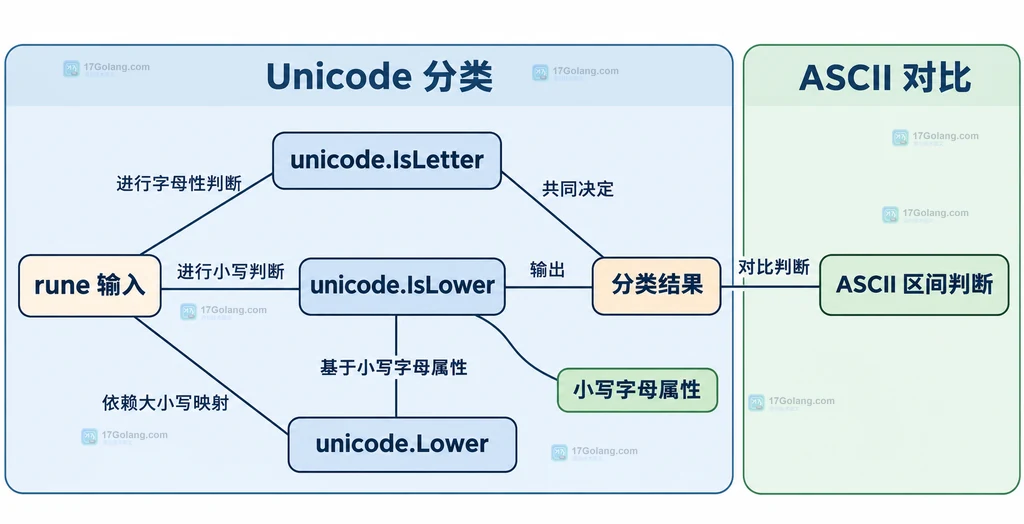
在 Go 里,判断一个字符是不是 Unicode 小写字母,直接把它作为 rune 传给 unicode.IsLower:返回 true 就表示它属于 Unicode 的小写字母分类,返回 false 则不是。它判断的是字符属性,不是“是否落在 ASCII 的 a 到 z 之间”。
一句话结论:遍历字符串时用 range 取得 rune,再调用 unicode.IsLower(r)。如果业务只接受英文小写,才使用 ASCII 区间判断。
先记住三个边界:
IsLower是 Unicode 分类函数,不负责转换大小写。IsLetter比它宽,大小写字母和其他 Unicode 字母都可能返回 true。- 字符串按字节下标访问时,不能把下标当作字符数量;多字节字符应先得到 rune。
先看 IsLower 判断的对象
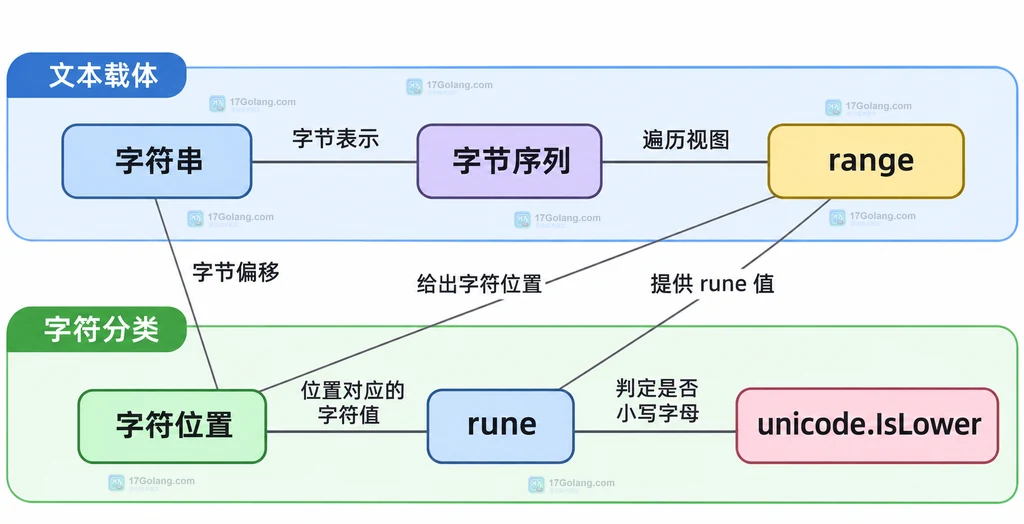
unicode.IsLower 的参数类型是 rune,也就是一个 Unicode code point。标准库根据 Unicode 表判断它是否属于小写字母;因此它不是只认识英文字母,也不能用来判断“字符是否可打印”或“字符是否为任意字母”。
最小写法可以保持得很短:
package main

import (
	"fmt"
	"unicode"
)

func main() {
	// rune 表示一个 Unicode 字符;IsLower 只负责分类,不改变原值。
	for _, r := range []rune{'a', 'G', 'ß', '中'} {
		fmt.Printf("%q: %v\n", r, unicode.IsLower(r))
	}
}
这里的返回值只说明“是不是小写字母”。即使判断结果为 true,原来的 rune 也不会被修改。
把它放进字符串遍历
面对字符串,优先使用 range。它会按 UTF-8 解码得到 rune,同时给出该字符在原字符串中的字节起始位置;这个位置不是第几个字符。这样既能覆盖多字节字符,也能明确索引的单位。
package main

import (
	"fmt"
	"unicode"
)

func printLowerPositions(text string) {
	// range 的 index 是字节偏移;r 是当前解码出的 rune。
	for byteIndex, r := range text {
		if unicode.IsLower(r) {
			fmt.Printf("byte=%d rune=%q\n", byteIndex, r)
		}
	}
}

func main() {
	printLowerPositions("Go café")
}
如果只写 for i := 0; i < len(text); i++,拿到的是单个字节,不能直接把 text[i] 当作完整字符。若业务需要字符序号,可以在遍历时另维护一个 rune 计数,而不要把 byteIndex 当成字符序号。
区分 IsLower、IsLetter 和 ASCII 判断
三个写法解决的是不同问题。unicode.IsLower(r) 询问“小写字母属性”;unicode.IsLetter(r) 询问“是不是 Unicode 字母”;而 r >= 'a' && r <= 'z' 只覆盖 ASCII 英文小写区间。
| 目标 | 建议写法 | 边界 |
|---|---|---|
| 识别 Unicode 小写字母 | unicode.IsLower(r) | 按 Unicode 属性分类 |
| 识别 Unicode 字母 | unicode.IsLetter(r) | 范围比小写字母更宽 |
| 只允许英文小写 | r >= 'a' && r <= 'z' | 明确限定 ASCII |
例如用户名规则如果明确要求英文小写,ASCII 判断更直白;文本分析、自然语言处理或国际化输入则应使用 Unicode 分类。不要因为函数名里有 “Lower” 就把它当成规范化工具。
分类和大小写转换不是一件事
IsLower 不会把字符变成小写。如果目标是转换,应使用 unicode.ToLower 或对应的大小写转换逻辑,再根据业务决定是否保留原字符串。分类适合做过滤、统计和校验;转换会产生新的 rune 结果,二者不要混在一个判断函数里。
package main

import (
	"fmt"
	"unicode"
)

func classifyAndConvert(r rune) (bool, rune) {
	// 先记录原始分类,再单独计算转换结果,避免误以为 IsLower 会修改 r。
	isLower := unicode.IsLower(r)
	converted := unicode.ToLower(r)
	return isLower, converted
}

func main() {
	isLower, converted := classifyAndConvert('G')
	fmt.Printf("lower=%v converted=%q\n", isLower, converted)
}
工程上可以把这两个动作拆成两个命名清楚的小函数:一个负责分类,一个负责转换。这样在校验失败、统计大小写比例或生成规范化文本时,调用方更不容易误读返回值。
常见问题
中文字符为什么不是小写字母?
unicode.IsLower 判断的是 Unicode 小写字母属性,不是“可读文字”或“任意字母”。中文通常不属于小写/大写分类;如果只想判断是否为字母,应改用 unicode.IsLetter。
为什么不能用 len 统计字符串中的小写字符?
len 返回字节数,不是 rune 数量。应使用 range 逐个得到 rune,再调用 unicode.IsLower;如果需要字符数量,也要按 rune 计数。




