登录
推荐 文章 Go 技术 课程 下载 专题 AI
首页 >  AI 编程开发  >  DreaMoving
DreaMoving:基于扩散模型的可控视频生成框架

DreaMoving

AI 编程开发
728次浏览
2025-03-14

工具简介

DreaMoving是一个先进的视频生成工具,利用扩散模型技术生成高质量、定制化的人类视频。通过Video ControlNet和Content Guider,用户可以精确控制视频中的身份、动作和外观,适用于娱乐、教育和广告等领域。

详细介绍

DreaMoving

DreaMoving是什么:

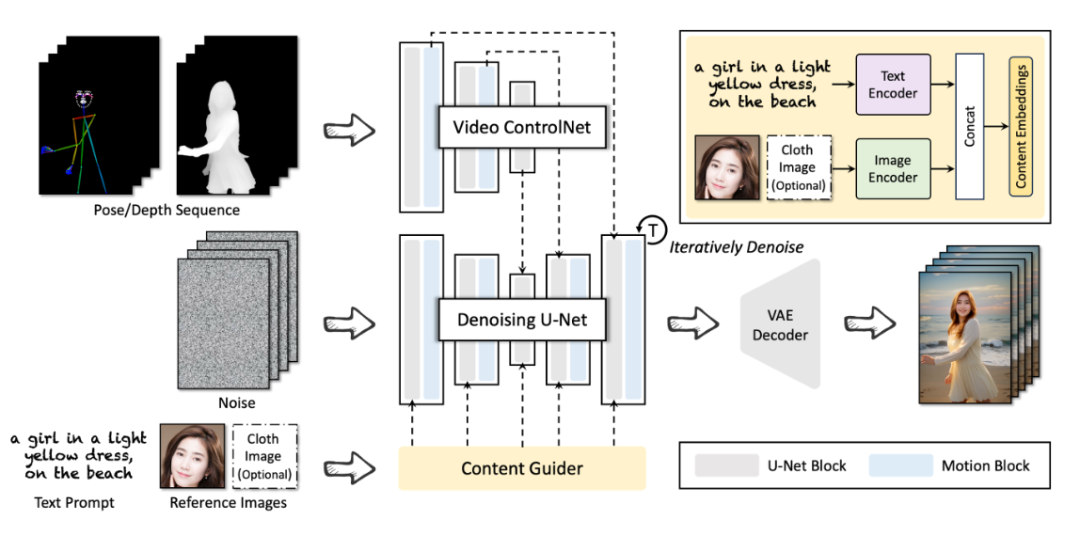
DreaMoving是一款基于扩散模型的可控视频生成框架,专为生成高质量、定制化的人类视频而设计。通过给定目标身份和姿势序列,DreaMoving能够生成目标身份在任何场景中跳舞的视频,受姿势序列驱动。为了实现这一目标,DreaMoving引入了Video ControlNet用于动作控制,以及Content Guider用于身份保持。该框架操作简便,兼容大多数风格化的扩散模型,生成多样化的视频结果。

主要特点:

  • 高质量视频生成:利用指导序列和简单的内容描述(如文本和参考图像),生成高质量、高保真度的视频。
  • 精确身份控制:通过面部参考图像,实现对视频中人物身份的精确控制。
  • 动作操控:通过姿势序列,实现对视频中人物动作的精确控制。
  • 视频外观控制:通过指定的文本提示,实现对视频整体外观的全面控制。
  • 强大的泛化能力:在未见过的领域中表现出色,具有强大的泛化能力。

主要功能:

  • Video ControlNet:通过在每个U-Net块后注入运动块,处理控制序列(如姿势或深度),生成额外的时间残差,实现动作控制。
  • Content Guider:将输入的文本提示和外观表达(如人脸和服装)转换为内容嵌入,用于交叉注意力,实现身份保持。
  • Denoising U-Net:基于Stable-Diffusion U-Net的衍生版本,包含用于视频生成的运动块。

使用示例:

  • 身份控制:通过提供一个女孩的面部参考图像,DreaMoving可以生成她在不同场景中跳舞的视频,保持身份的一致性。
  • 动作操控:通过输入不同的姿势序列,DreaMoving可以生成目标人物在不同场景中执行特定动作的视频。
  • 视频外观控制:通过指定的文本提示,如“一个女孩,微笑着,在法国小镇跳舞,穿着浅蓝色长裙”,DreaMoving可以生成符合描述的视频。

总结:

DreaMoving是一个创新的视频生成框架,通过其独特的Video ControlNet和Content Guider,实现了对视频内容的高度控制。它不仅能够生成高质量的视频,还能在身份、动作和外观方面提供精细的控制。DreaMoving的泛化能力使其在处理未见过的领域时也能保持良好的性能,这为视频生成领域带来了新的可能性,特别是在娱乐、教育和广告等行业中具有广泛的应用前景。

最新文章

QueryRow 何时真正返回错误,为什么必须在 Scan 时判断

QueryRow 何时真正返回错误,为什么必须在 Scan 时判断

Go 的 QueryRowContext 总会返回非 nil 的 Row
PHP DateTimeImmutable 处理跨时区预约的正确方式

PHP DateTimeImmutable 处理跨时区预约的正确方式

用 DateTimeImmutable 和 IANA 时区处理跨时区预约
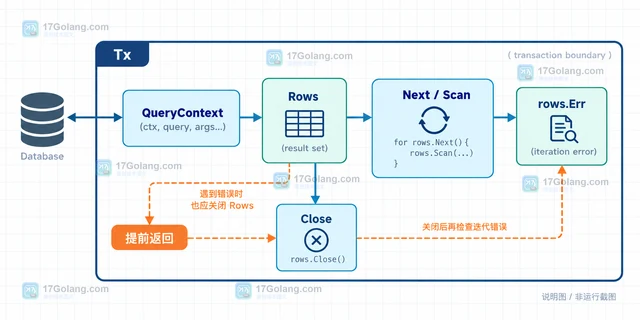
批量查询时按页扫描并及时检查 Rows 的最终错误

批量查询时按页扫描并及时检查 Rows 的最终错误

Go 批量查询不能只检查 QueryContext 和 Scan。本文用
Claude Sonnet 5.5 更新后,企业为何更看重速度与单位成本

Claude Sonnet 5.5 更新后,企业为何更看重速度与单位成本

Claude Sonnet 5.5 的价值不只在模型能力,而在更快响应、
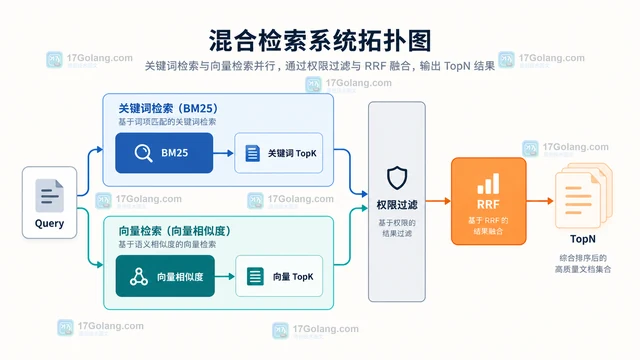
向量检索与关键词检索怎样做混合召回

向量检索与关键词检索怎样做混合召回

混合召回应让关键词与向量检索并行产生候选,再用 RRF 等可解释方法合并
事务已经回滚却仍占用连接,常见的资源遗漏在哪里

事务已经回滚却仍占用连接,常见的资源遗漏在哪里

Go 的 database/sql 中,事务回滚并不等于所有相关资源都已