登录
推荐 文章 Go 技术 课程 下载 专题 AI
首页 >  AI 编程开发  >  scikit-learn
scikit-learn:Python机器学习库详解与应用

scikit-learn

AI 编程开发
506次浏览
2025-03-18

工具简介

探索scikit-learn,Python最流行的机器学习库之一。了解其功能、应用场景及如何使用scikit-learn进行数据分析和机器学习建模,提升您的AI技能。

详细介绍

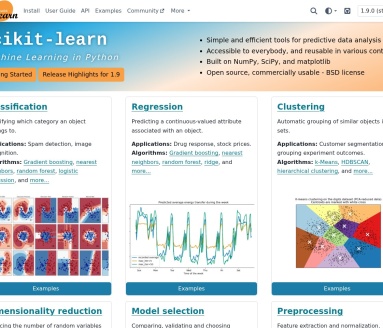
scikit-learn是Python生态系统中一个功能强大且广泛使用的机器学习库。它提供了简单高效的工具,用于数据挖掘和数据分析,支持包括分类、回归、聚类、降维等多种机器学习算法。

scikit-learn的主要特点:

  • 易用性: scikit-learn设计简洁,易于上手,适合初学者和专业人士。
  • 丰富的算法: 包含多种机器学习算法,如支持向量机(SVM)、随机森林、K-means聚类等。
  • 数据预处理: 提供数据标准化、归一化、特征选择等多种预处理工具。
  • 模型评估: 支持交叉验证、网格搜索等多种模型评估和优化方法。

应用场景:

  • 数据科学: 用于数据探索、特征工程和模型训练。
  • 机器学习项目: 从学术研究到工业应用,scikit-learn在各领域均有广泛应用。
  • 教育培训: 许多大学和在线课程使用scikit-learn作为教学工具。

如何使用scikit-learn:

scikit-learn的使用非常直观。您可以轻松地导入库,使用其API进行数据加载、预处理、模型训练和评估。例如:

from sklearn import datasets
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score

# 加载数据
iris = datasets.load_iris()
X, y = iris.data, iris.target

# 划分训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)

# 训练模型
clf = RandomForestClassifier()
clf.fit(X_train, y_train)

# 预测并评估模型
y_pred = clf.predict(X_test)
print("Accuracy:", accuracy_score(y_test, y_pred))

通过scikit-learn,您可以快速构建并部署机器学习模型,提升数据分析和预测能力。无论您是初学者还是专业人士,scikit-learn都是您进行机器学习研究和应用的理想选择。

最新文章

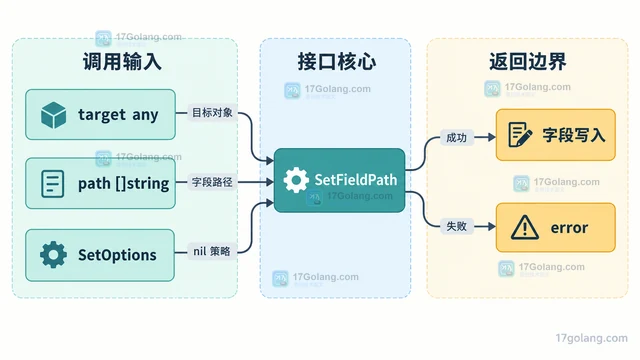
安全地为可设置字段赋值并处理指针层级

安全地为可设置字段赋值并处理指针层级

本文设计一个安全的 Go 反射字段赋值 API:从多层指针入口定位可设置
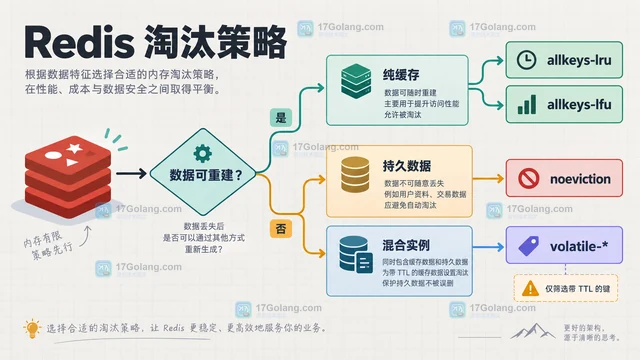
内存淘汰策略怎么选:先区分缓存库与持久数据

内存淘汰策略怎么选:先区分缓存库与持久数据

从数据是否可重建、访问冷热和 TTL 三个维度选择 Redis 内存淘汰
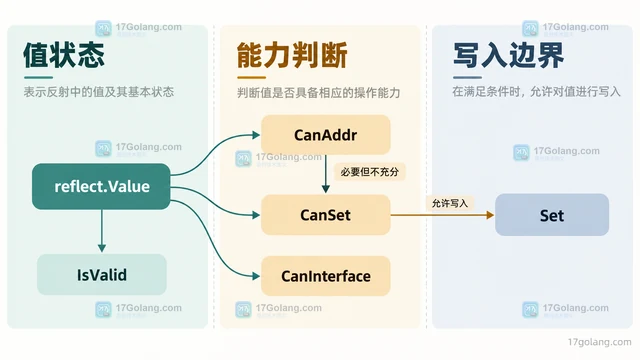
reflect.Value 为什么会 panic,CanSet 与可寻址性如何理解

reflect.Value 为什么会 panic,CanSet 与可寻址性如何理解

reflect.Value 的 panic 往往来自前置条件不成立。本文
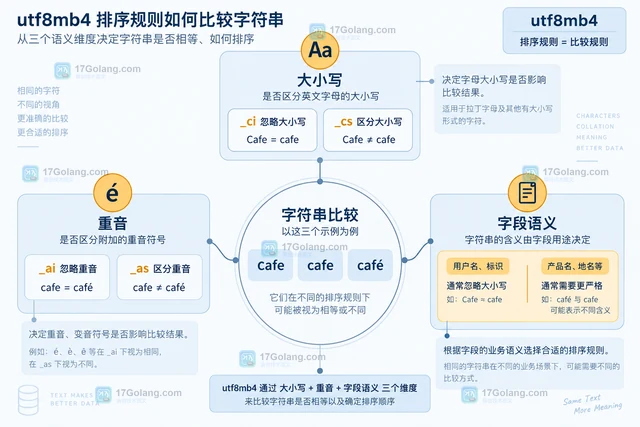
utf8mb4 排序规则怎么选:大小写、重音与唯一键影响

utf8mb4 排序规则怎么选:大小写、重音与唯一键影响

utf8mb4 排序规则不只是影响 ORDER BY,还会决定字符串比较
读取结构体标签生成字段映射并缓存类型元数据

读取结构体标签生成字段映射并缓存类型元数据

用 Go 的 reflect.VisibleFields 和 Struc
薄雾中半透明晶体城市的未来手机壁纸提示词

薄雾中半透明晶体城市的未来手机壁纸提示词

这组原创手机壁纸把半透明晶体城市放入柔和薄雾,提供珍珠青蓝月光版与玫瑰金