登录
推荐 文章 Go 技术 课程 下载 专题 AI
首页 >  AI 编程开发  >  Vary-toy
Vary-toy:小型视觉语言模型,强大功能助力资源有限的研究者

Vary-toy

AI 编程开发
777次浏览
2025-03-14

工具简介

Vary-toy是由MEGVII Technology、University of Chinese Academy of Sciences和Huazhong University of Science and Technology联合开发的小型视觉语言模型(LVLM)。它专为资源有限的研究者设计,提供文档OCR、图像描述、视觉问答等多种功能,支持在消费级GPU上训练和部署。

详细介绍

Vary-toy

Vary-toy:小型视觉语言模型,开启视觉AI新时代

Vary-toy是由MEGVII Technology、中国科学院大学和华中科技大学的研究人员共同开发的一款小型视觉语言模型(LVLM)。它专为资源有限的研究者和开发者设计,旨在解决大型视觉语言模型在训练和部署上的挑战。

核心优势:

  • 小尺寸,大能量:Vary-toy体积小巧,适合在消费级GPU上进行训练和部署,让更多研究者能够轻松上手。
  • 功能全面,应用广泛:尽管尺寸小,Vary-toy却具备与大型模型相媲美的功能,如文档OCR、图像描述、视觉问答等,满足多样化的需求。
  • 视觉词汇网络优化:通过改进的视觉词汇网络,Vary-toy能够更高效地编码自然物体的视觉信息,提升模型的理解能力。

强大功能:

  • 文档级光学字符识别(OCR):精准识别文档中的文字,并可转换为Markdown格式,提升文档处理效率。
  • 图像描述:自动生成对图像内容的详细描述,帮助用户快速理解图像信息。
  • 视觉问答(VQA):与图像内容相关的问答互动,提供智能的视觉理解和回答。
  • 对象检测:识别并定位图像中的各个对象,应用于多种场景。
  • 图像到文本的转换:将图像内容转换为文本,方便信息提取和处理。
  • 多模态对话:支持与用户进行自然的多模态对话,增强用户体验。

应用场景:

  1. 对象检测:
    • 用户上传图片,Vary-toy能够快速识别并标注图中的各个对象,适用于图像分析和数据标注。
  2. OCR图像转文本/Markdown:
    • 用户上传PDF图像,Vary-toy提供精准的OCR结果,并可转换为易于编辑的Markdown格式,提升文档处理效率。
  3. 日常对话:
    • 用户与Vary-toy进行日常对话,模型能够理解图像内容并生成相关对话,增强人机交互体验。

总结:

Vary-toy作为一款小型但功能强大的视觉语言模型,为资源有限的研究者和开发者提供了先进的视觉语言模型功能。通过改进的视觉词汇网络和多任务预训练策略,Vary-toy在保持小尺寸的同时,展现出处理复杂视觉语言任务的强大能力。无论是文档处理、图像分析还是多模态对话,Vary-toy都能为您带来高效、便捷的解决方案。

最新文章

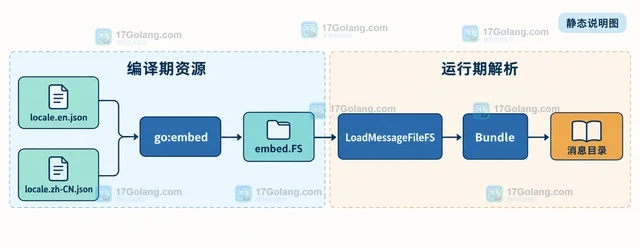
Go go-i18n 怎样从嵌入文件系统加载翻译

Go go-i18n 怎样从嵌入文件系统加载翻译

Go go-i18n 可以通过 LoadMessageFileFS 读取
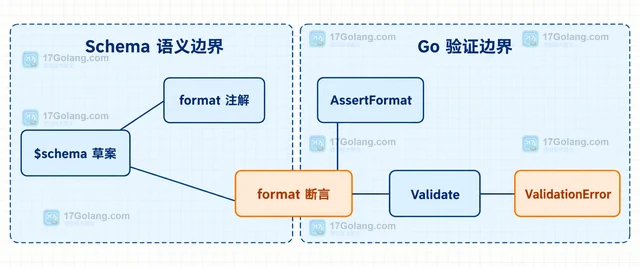
Go jsonschema 的 format 为什么不总是强制断言

Go jsonschema 的 format 为什么不总是强制断言

解释 Go jsonschema 中 format 注解与断言的区别,示
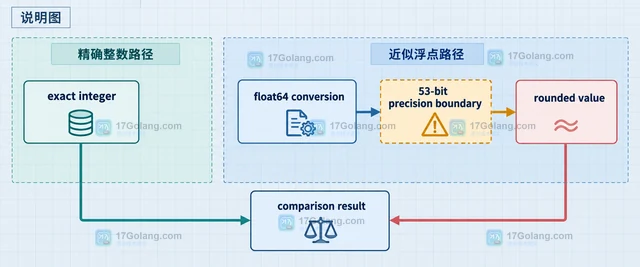
Go gojq 的大整数计算与先转 float64 有什么区别

Go gojq 的大整数计算与先转 float64 有什么区别

gojq 能保持大整数精度并进行任意精度整数计算;如果先转成 float
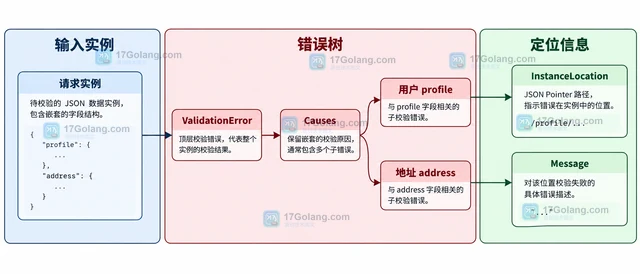
Go jsonschema 怎样展开嵌套字段的校验错误

Go jsonschema 怎样展开嵌套字段的校验错误

Go jsonschema/v5 校验失败时,ValidationErr
Go gojq 怎样为查询表达式绑定外部变量

Go gojq 怎样为查询表达式绑定外部变量

使用WithVariables声明外部变量,并在Code.Run中按顺序
Go go-flags 指针字段怎样区分未传参数与零值

Go go-flags 指针字段怎样区分未传参数与零值

Go go-flags 使用 *int 字段可以区分未传参数与显式传入