登录
推荐 文章 Go 技术 课程 下载 专题 AI
首页 >  AI 绘画作图  >  Video Diffusion Models
Video Diffusion Models:利用扩散模型生成高质量视频的先进技术

Video Diffusion Models

AI 绘画作图
671次浏览
2025-03-24

工具简介

Video Diffusion Models项目专注于利用扩散模型生成高质量视频,支持文本条件和梯度条件方法,实现高效的视频生成和扩展。

详细介绍

Video Diffusion Models

Video Diffusion Models:探索视频生成的新前沿

Video Diffusion Models是一个前沿的研究项目,致力于利用扩散模型(diffusion models)在视频生成领域的应用。这些模型已经在图像和音频生成中展现出强大的能力,现在正被用于创造高质量视频。

核心优势:

  • 高质量视频生成: 无论是无条件还是条件设置,扩散模型都能生成清晰、连贯的视频内容。
  • 灵活架构: 通过简单调整,标准高斯扩散模型可以在深度学习加速器的内存限制内高效处理视频数据。
  • 自回归生成: 模型能够生成固定数量帧的视频块,并通过重新利用训练好的模型生成更长的视频。

强大功能:

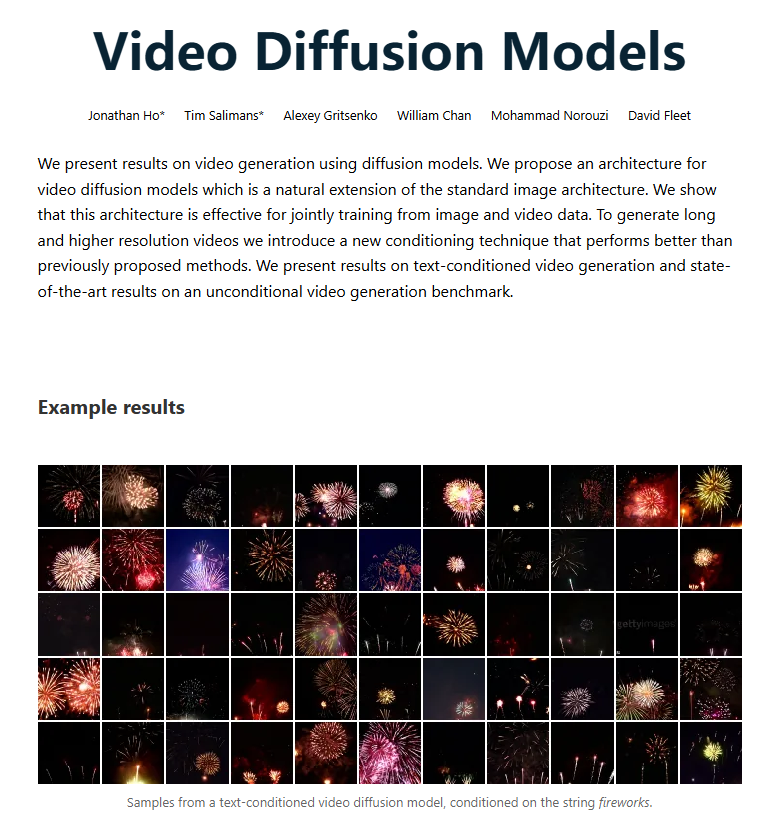
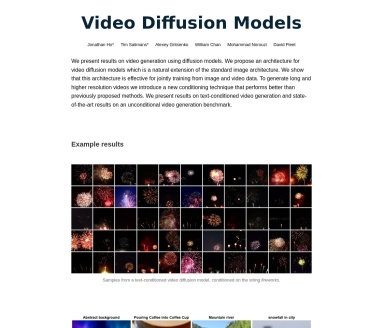
  • 文本条件视频生成: 根据给定的文本条件,如“fireworks”,模型可以生成与该条件相关的视频样本。
  • 梯度条件方法: 通过梯度优化改进模型采样过程,确保生成的视频与条件信息高度一致。
  • 自回归扩展: 利用梯度方法将模型扩展到更多时间步和更高分辨率,提升视频生成的灵活性。

应用场景:

  • 视频创作者: 通过输入特定文本条件,快速生成与主题相关的视频内容,提升创作效率。
  • 研究人员: 探索从无序到有序的视频生成过程,推动视频生成技术的发展。

总结:

Video Diffusion Models项目通过创新的扩散模型技术,展示了在视频生成领域的巨大潜力。通过文本条件生成、梯度条件方法和自回归扩展技术,项目实现了高质量、时间连贯的视频样本生成,为视频生成领域提供了新的研究方向和应用基础。

最新文章

新能源汽车充电站日常巡检如何记录枪口、计费和告警状态

新能源汽车充电站日常巡检如何记录枪口、计费和告警状态

按充电枪建立巡检记录,分别核对设备状态、计费结果和告警处置,让充电站交接
Go regexp用 Expand 生成结构化替换文本的实践示例

Go regexp用 Expand 生成结构化替换文本的实践示例

用 Go regexp 的 Expand 和 FindSubmatchI
CSS scroll snap让横向卡片滚动停在卡片边界的实现方法

CSS scroll snap让横向卡片滚动停在卡片边界的实现方法

本文用一段最小 CSS 配方让横向卡片在滚动结束后停在卡片边界,说明 s
影视团队选择LibTV前要看什么?功能、成本与交付检查

影视团队选择LibTV前要看什么?功能、成本与交付检查

本文针对影视团队选型LibTV的实际需求,从功能、成本、交付三维度梳理全
Go archive/tar识别 Tar 硬链接与符号链接的排查指南

Go archive/tar识别 Tar 硬链接与符号链接的排查指南

Go archive/tar 不应通过文件名后缀判断 Tar 链接。读取
Linux inotify处理目录监控事件丢失风险的实现方法

Linux inotify处理目录监控事件丢失风险的实现方法

Linux inotify 不能保证事件永不丢失。本文围绕 IN_Q_O