OhYesAI是什么
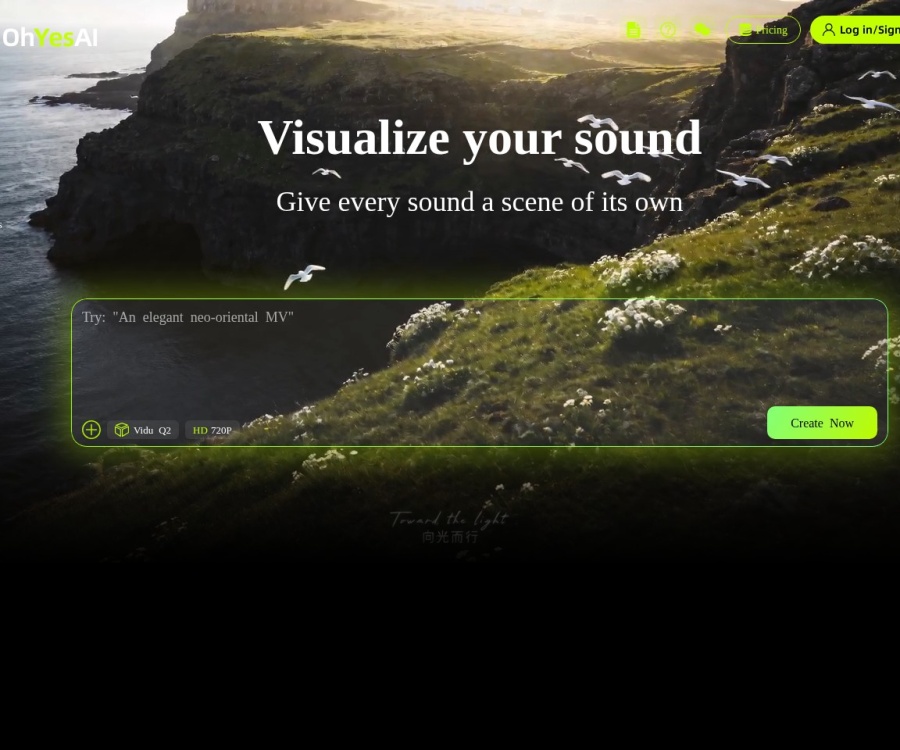
OhYesAI 是一个致力于 AI 音乐 MV 制作的音视频一体化智能创作平台,旨在让每一段旋律都能匹配专属的视觉画面。用户仅需上传音频文件或通过自然语言指令生成原创歌曲,OhYesAI 便能结合自研算法与 Vidu、可灵、Seedance 等前沿视频模型,自动化执行分镜设计、音画节奏匹配、视频渲染及歌词字幕添加等全过程,一键输出长达 5 分钟的电影质感 MV。无论是独立音乐人、内容创作者还是普通用户,无需具备剪辑技巧或乐理知识,只需通过简单的对话交互即可精准把控视觉风格、角色设定及分镜细节,轻松实现从零素材到完整成片的低门槛创作体验。
OhYesAI的主要功能
AI 原创音乐创作:输入主题、情感基调与风格偏好,AI 即可自动生成包含歌词的完整歌曲,涵盖流行、摇滚、电子、R&B 等多种曲风,并可直接衔接至 MV 制作环节。
音频驱动 MV 制作:支持导入 MP3/WAV/M4A 等格式的音频文件,AI 智能分析节奏、情绪及歌词内容,生成与音乐节拍紧密契合的高清视觉影像。
多模型灵活切换:集成 Vidu Q2、Kling V3 Omni Pro、Seedance 2.0 等主流视频生成模型,用户可根据对画质、生成速度的不同需求自由切换。
智能分镜规划与编辑:系统依据音乐节奏自动拆解并生成带时间戳的分镜脚本,支持单独替换镜头、重绘、调整时长及优化提示词,实现高度可控的精细化创作。
参考图角色一致性保持:允许上传 1-6 张人物、服饰、场景或道具参考图,确保 MV 中主角形象及整体视觉风格在不同镜头间保持高度统一。
毫秒级音画精准同步:采用独家算法精确解析 BPM 与音频波形,自动对齐画面转场、镜头动态与鼓点节拍,将同步误差控制在毫秒级别。
歌词字幕与智能口型匹配:自动生成并嵌入歌词字幕,提供免费的时间轴校准服务;当出现人物正面镜头时,可启用智能口型同步功能,使口型与歌词完美对应。
对话式协同创作体验:全程采用自然语言交互模式,既可通过文字描述生成音乐与画面,也能直接下达如“将第 8 个分镜移至第 9 位”等具体剪辑指令。
如何使用OhYesAI
- 访问平台:进入 OhYesAI 官方网站 https://ohyesai.com/ ,完成注册或登录操作。
选择视频模型与画布比例:在对话界面左下角切换所需的生成模型(如 Vidu Q2、Kling V3 Omni Pro、Seedance 2.0 等),并通过对话框指令设定画面比例(16:9 横屏或 9:16 竖屏)。
准备音乐素材:点击“本地上传”导入 MP3/WAV/M4A 音频文件(时长限制 6 分钟内),或在对话框中输入需求让 AI 创作原创歌曲,选定满意版本后进入 MV 制作流程。
上传主体参考图(可选步骤):上传 1-6 张图片以固定人物、服装、场景或道具形象,建议单张图片仅包含一人且面部清晰;若不上传图片,也可直接通过文字描述进行生成。
设定视觉风格:在对话框中输入风格提示词,例如“动漫风格”、“写实风格”或“唯美梦幻”,以便 AI 准确理解画面基调。
确认主体与场景设计:系统基于音乐、参考图及提示词生成视觉参考图,用户可放大查看并对不满意处进行编辑,确认无误后发送“确认并继续”。
审阅与修改分镜脚本:系统根据音乐节奏与歌词自动生成带时间戳的分镜描述(此步骤不消耗积分),用户可在对话框中提出修改意见或直接点击分镜框编辑,确认后发送“确认并生成”。
逐镜审阅与精细调整:分镜视频生成后,可通过对话框快速指令进行调整,或点击“编辑分镜”弹窗修改提示词、更换参考图,甚至针对单个镜头切换更强大的模型进行重绘。
添加字幕与口型同步:导出前开启“歌词字幕”功能自动嵌入歌词,若时间轴存在偏差可请求 AI 免费重新校准;若包含人物正面演唱镜头,可开启“智能口型同步”功能。
一键成片与下载:渲染结束后点击右上角“下载”按钮保存视频,所有作品均可在侧边栏【资源】板块中查看并分享给好友。
OhYesAI的核心优势
全流程一键生成:上传音频或通过 AI 生成歌曲后,系统自动处理从分镜规划、音画同步到高清渲染的全部环节,无需手动剪辑即可直接输出成品。
对话式自然语言交互:全程通过文字对话进行操控,既能生成音乐与画面,也能精准执行如“将第 8 个分镜移至第 9 位”等具体剪辑指令,实现零门槛上手。
毫秒级音画同步技术:凭借独家音画同步算法,精确解析音频 BPM 与节奏波形,确保画面转场、镜头律动与鼓点节拍高度吻合,呈现专业级卡点效果。
多模型自由切换机制:平台整合了 Vidu Q2、Kling V3 Omni Pro、Seedance 2.0 等行业领先视频模型,用户可根据画质、速度及成本需求随时切换,甚至可为单个镜头独立更换模型。
5 分钟完整叙事能力:突破短视频时长限制,支持生成长达 5 分钟的高清 MV 成片,能够完整呈现一首歌曲的视觉故事线。
精细化分镜可控编辑:系统自动生成带时间戳的分镜脚本(不消耗积分),支持单镜头替换、重绘、提示词优化及时长调整,有效避免废片产生,确保创作过程完全可控。
智能字幕与口型同步:自动生成并嵌入歌词字幕,提供免费时间轴校准服务;在包含人物正面镜头时可开启智能口型同步,使人物口型与歌词精准匹配,增强真实感。
角色一致性保障:支持上传 1-6 张参考图以固定人物、服装与场景,结合 AI 智能规划,确保主角形象在多镜头切换中保持高度统一。
OhYesAI的同类竞品对比
| 对比维度 | OhYesAI | Neural Frames | Kaiber AI |
|---|
| 产品定位 | AI 音视频智能体,专注中文用户的对话式 MV 创作平台 | 专为音乐人打造的音频反应式 AI MV 生成器 | 通用型 AI 动画视频生成平台,支持音乐可视化 |
| 核心创作模式 | 文本生成音乐 + 音频驱动 MV + 分镜对话式编辑 | 音频上传 + Autopilot 一键生成 + 分镜精修 | 文本/图像/音频转动画视频,模板化风格渲染 |
| 音频解析能力 | 解析 BPM、节奏、歌词情绪,自动匹配画面 | 8-stem 分离(鼓/贝斯/人声/旋律等),逐轨映射视觉触发器 | 支持音频输入驱动画面,但无深度 stem 级解析 |
| 分镜/故事板 | 智能生成带时间戳的分镜脚本,支持单镜头替换、重绘、时长调整 | 自动生成 5-7 场景故事板,支持逐帧关键帧与视频提示词编辑 | 无明确分镜脚本系统,以连续动画片段为主 |
| 角色一致性 | 支持 1-6 张参考图固定人物、服装、场景 | 支持上传参考图,跨场景与跨项目保持角色统一 | 无专门的角色一致性保障机制 |
| 音画同步精度 | 独家毫秒级卡点算法,节拍同步误差控制在 50ms 内 | Per-stem audio-reactive,可将鼓点映射到镜头缩放、贝斯映射到调色 | 基础音频可视化,节奏匹配精度一般 |
| 最大视频时长 | 最长 5 分钟成片,支持完整歌曲叙事 | 支持 Full Track(完整曲目),通常覆盖 3-5 分钟 | 未明确限制,但更适合中短视频 |
| 接入视频模型 | Vidu Q2、Kling V3 Omni Pro、Seedance 2.0 | Kling、Seedance、Runway 等多模型集成 | 自有模型,风格化渲染为主 |
| 交互方式 | 全程对话式协同,自然语言控制分镜与剪辑 | Autopilot 两键生成 + DAW 风格时间线编辑 + 对话式修改 | 简洁的 Web/App 界面,提示词驱动 |
| 字幕与口型 | 自动生成歌词字幕,免费校准;支持智能口型同步 | 支持 Lip Sync 口型同步;Lyric Showcase 模式可展示歌词 | 无专门的歌词字幕与口型同步功能 |
OhYesAI的应用场景
独立音乐宣发与 Demo 预热:独立音乐人及原创歌手可为新作品快速制作高品质预热 MV 或视觉化专辑封面。
短视频与自媒体批量生产:抖音、B 站、小红书等平台创作者可将音乐、卡点视频、小说推文有声内容一键转化为与节奏匹配的视觉画面。
品牌广告与营销宣传片:品牌方可将产品宣传文案或主题音乐转化为电影级视觉短片,适用于电商详情页、社交媒体广告投放或发布会暖场视频。
教育与知识科普可视化:教育机构及科普博主可将儿歌、历史故事、科学原理讲解音频转化为动画 MV 或卡通风格短片。
游戏与虚拟偶像内容:游戏厂商可为角色主题曲、版本更新 PV 制作专属 MV;虚拟偶像运营团队也可快速生成对口型、卡节拍的表演视频。
直播与舞台背景:主播、DJ 及线下演出团队可将实时音频或 Set 列表转化为动态视觉背景,替代传统 VJ 操作,实现音画同步的沉浸式舞台效果。