Gemma是什么
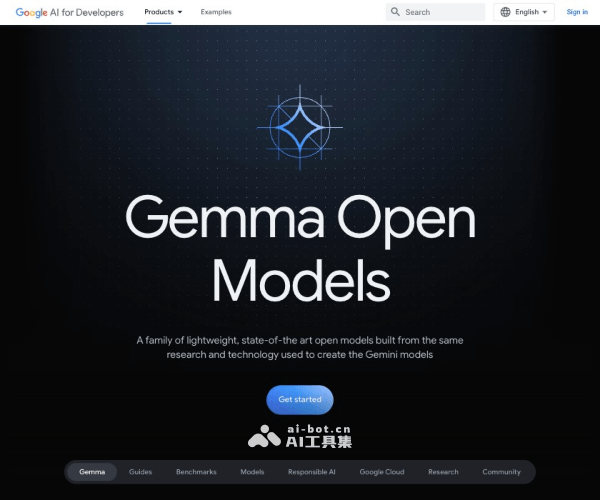
Gemma是谷歌DeepMind联合其他团队打造的一系列轻量级、高性能开放人工智能模型。该系列基于与Gemini同源的核心技术,旨在赋能开发者和研究人员构建安全、负责任的AI应用。Gemma家族主要包含20亿参数(2B)和70亿参数(7B)两种规格,均提供预训练版和指令微调版,并完美兼容JAX、PyTorch及TensorFlow等主流框架,确保在不同硬件设备上高效部署。值得注意的是,第二代模型Gemma 2已于6月28日正式发布。
Gemma的官方入口
- Gemma的官网主页:https://ai.google.dev/gemma?hl=zh-cn
- Gemma的Hugging Face模型:https://huggingface.co/models?search=google/gemma
- Gemma的Kaggle模型地址:https://www.kaggle.com/models/google/gemma/code/
- Gemma的技术报告:https://storage.googleapis.com/deepmind-media/gemma/gemma-report.pdf
- 官方PyTorch实现GitHub代码库:https://github.com/google/gemma_pytorch
- Gemma的Google Colab运行地址:https://colab.research.google.com/github/google/generative-ai-docs/blob/main/site/en/gemma/docs/lora_tuning.ipynb
Gemma的主要特性
- 轻量级架构:Gemma采用轻量化设计,能够轻松适配个人电脑、工作站等多种计算环境,降低部署门槛。
- 开放模型:模型权重完全开放,允许用户在遵循许可协议的前提下进行商业应用及分发,促进生态繁荣。
- 预训练与指令微调:不仅提供基础预训练模型,还推出经人类反馈强化学习(RLHF)优化的指令微调版本,确保模型行为更加安全可靠。
- 多框架支持:全面支持JAX、PyTorch和TensorFlow等主流AI框架,并通过Keras 3.0工具链简化推理及监督微调(SFT)流程。
- 安全性与可靠性:严格遵循Google AI原则,利用自动化技术清洗训练数据中的敏感信息,并通过红队测试和对抗性测试等多重安全评估。
- 性能优化:针对NVIDIA GPU和Google Cloud TPUs等硬件进行深度优化,保障在不同设备上的卓越运行性能。
- 社区支持:Google通过Kaggle、Colab提供免费算力资源及Google Cloud积分,积极鼓励社区利用Gemma开展创新研究。
- 跨平台兼容性:具备广泛的设备适应能力,可在笔记本、台式机、物联网设备及云端环境中稳定运行,支持 diverse AI功能。
- 负责任的AI工具包:配套发布Responsible Generative AI Toolkit,包含安全分类器、调试工具及应用指南,协助开发者打造安全的AI应用。
Gemma的技术要点
- 模型架构:基于先进的Transformer解码器架构,采用多头注意力机制以并行关注文本多处信息。引入旋转位置嵌入(RoPE)替代绝对位置嵌入,有效缩减模型体积并提升效率;使用GeGLU激活函数取代传统ReLU,并在Transformer子层输入输出端实施归一化处理。
- 训练基础设施:依托Google专为机器学习打造的TPUv5e高性能计算平台进行训练。通过模型分片和数据复制技术,在多个Pod(芯片集群)间高效调度分布式计算资源。
- 预训练数据:基于海量高质量英语数据预训练(2B模型约2万亿token,7B模型约6万亿token),涵盖网络文档、数学及代码领域。数据经过严格过滤,在保障多样性的同时剔除不安全内容。
- 微调策略:结合监督式微调(SFT)与基于人类反馈的强化学习(RLHF)。利用合成文本对、人类提示响应对以及基于偏好数据训练的奖励模型,进一步优化模型表现。
- 安全性和责任:从预训练阶段即介入数据过滤以降低有害内容风险,并通过自动化基准测试及人工评估等多重安全审查,确保实际应用中的安全性。
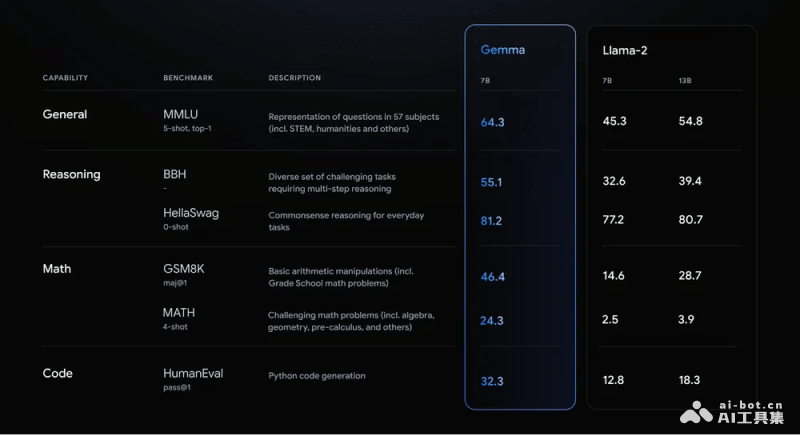
- 性能评估:在问答、常识推理、数理科学及编码任务等领域表现优异。在MMLU、MBPP等18项基准测试中,Gemma在11项指标上超越了Llama-13B或Mistral-7B等同规模或更大规模的开放模型。
- 开放性和可访问性:以开源形式发布预训练及微调检查点,并提供完整的推理与部署代码库,极大降低了研究人员和开发者获取及使用先进语言模型的门槛。
常见问题
Gemma属于开源开放的大语言模型,用户可直接在Hugging Face平台查看详细信息并下载模型文件。
目前Gemma主要提供20亿(2B)和70亿(7B)参数量的版本,未来预计将推出更多新的模型变体。