登录
推荐 文章 Go 技术 课程 下载 专题 AI
首页 >  AI 编程开发  >  MLlib(ApacheSpark)
SEO标题:
MLlib (Apache Spark):高效机器学习库,支持多语言和快速迭代计算

MLlib(ApacheSpark)

AI 编程开发
646次浏览
2025-03-16

工具简介

SEO摘要: 探索MLlib,Apache Spark的强大机器学习库,适用于Java、Scala、Python和R。MLlib提供高质量算法,性能比MapReduce快100倍,并支持Hadoop、Mesos、Kubernetes等多种环境,轻松访问HDFS、HBase等数据源。

详细介绍

新的介绍内容:

MLlib (Apache Spark)

MLlib (Apache Spark):高效机器学习库,支持多语言和快速迭代计算

使用方便

MLlib是Apache Spark的一部分,支持多种编程语言,包括Java、Scala、Python和R。通过与Spark的API无缝集成,MLlib能够与Python(从Spark 0.9开始)和R库(从Spark 1.5开始)中的NumPy进行互操作。无论您使用的是HDFS、HBase还是本地文件,MLlib都可以轻松插入您的Hadoop工作流中,简化数据处理和分析过程。

表现

MLlib的设计目标之一是高效运行机器学习算法,其性能比传统的MapReduce快100倍。得益于Spark的迭代计算能力,MLlib能够快速执行复杂的机器学习任务。MLlib包含经过优化的高质量算法,这些算法不仅速度快,还能产生比单遍近似更准确的结果,帮助您在数据分析和机器学习任务中取得更好的效果。

无处不在

无论您是在Hadoop、Apache Mesos、Kubernetes上运行Spark,还是在云端针对不同的数据源进行处理,MLlib都能适应您的需求。您可以使用Spark的独立集群模式,在EC2、Hadoop YARN、Mesos或Kubernetes上运行Spark,轻松访问HDFS、Apache Cassandra、Apache HBase、Apache Hive以及数百个其他数据源中的数据,实现灵活高效的数据处理和机器学习应用。

总结

MLlib (Apache Spark) 是一款功能强大、易于使用的机器学习库,适用于多种编程语言和数据源。其高效的算法和快速的迭代计算能力,使其成为数据科学家和工程师的理想选择。无论您是在本地环境还是云端进行数据处理和机器学习,MLlib都能为您提供卓越的性能和灵活性。

最新文章

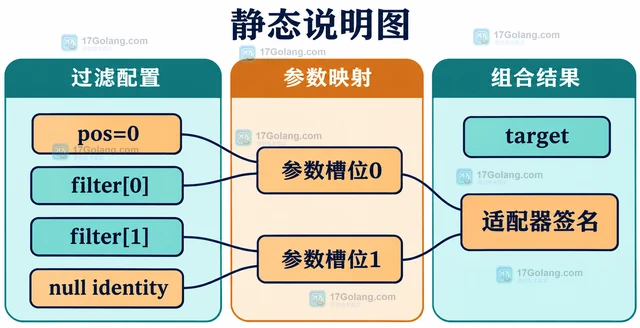
Java MethodHandles.filterArguments 怎样按位置预处理方法参数

Java MethodHandles.filterArguments 怎样按位置预处理方法参数

MethodHandles.filterArguments 可以在调用目
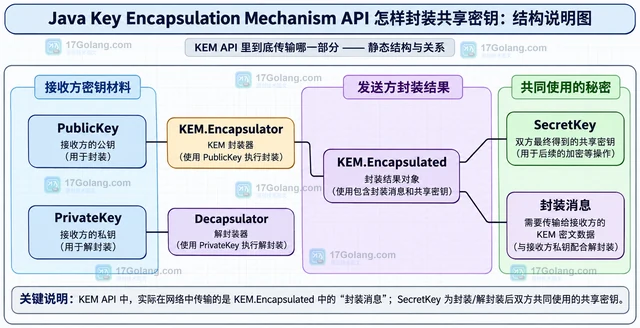
Java Key Encapsulation Mechanism API 怎样封装共享密钥

Java Key Encapsulation Mechanism API 怎样封装共享密钥

用 Java 21 的 KEM API 理清发送方和接收方的封装、解封装
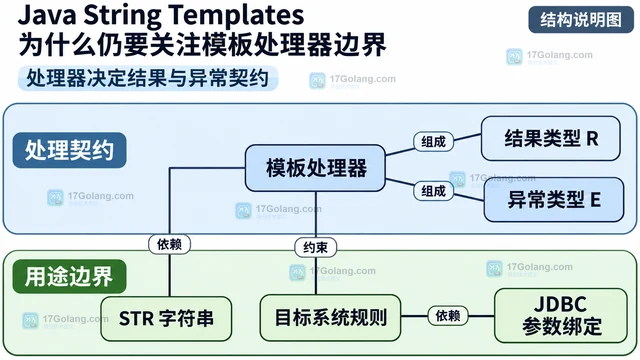
Java String Templates 为什么仍要关注模板处理器边界

Java String Templates 为什么仍要关注模板处理器边界

String Templates 的历史预览设计保留片段和值,处理器负责
Java Thread.onSpinWait 怎样给自旋等待循环降成本

Java Thread.onSpinWait 怎样给自旋等待循环降成本

Thread.onSpinWait 只是自旋等待的运行时提示,不负责同步
Java Locale.stripExtensions 怎样去掉扩展标签保留基础地区

Java Locale.stripExtensions 怎样去掉扩展标签保留基础地区

介绍 Java Locale.stripExtensions 怎样去掉
Java StructuredTaskScope.Subtask.state 怎样区分未完成、成功与失败

Java StructuredTaskScope.Subtask.state 怎样区分未完成、成功与失败

Java StructuredTaskScope.Subtask.sta