当前位置:首页 >专题 >AI Agent 评测与回归测试工程专题
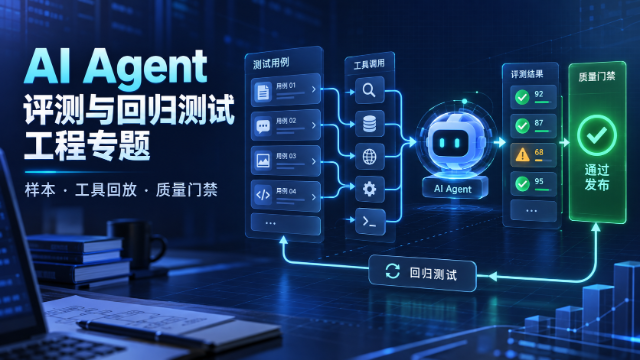
AI Agent 评测与回归测试工程
AI Agent 评测与回归测试工程专题
从任务样本、工具调用到质量门禁与上线回放
Agent 能否稳定完成任务,不能只看一次演示。真正上线需要固定样本、可解释评分、工具调用回放、失败分类和版本对照,把模型与工作流变化变成可以验收的工程证据。本专题聚焦 Agent 评测与回归测试,兼顾 OpenAI、Anthropic、Google 的官方资料和 Go 实践。
官方入口与评测基线
先统一模型 API、评测数据、工具与 SDK 的官方语义
官方
OpenAI Evals 指南
OpenAI 官方评测指南,覆盖数据集、grader、运行和结果比较。
官方
OpenAI Evals API 参考
创建、运行和管理评测的官方 API 参考。
官方
Anthropic 工具调用文档
Anthropic 官方工具调用实现指南,说明工具定义、执行与结果回传。
官方
Google Gemini API 参考
Gemini API 官方参考,覆盖生成、流式、工具、批处理和 SDK 入口。
官方
Google Gemini 安全与事实性测试
Google 官方安全测试指南,介绍安全指标、评测数据和对抗测试。
官方
LangSmith 评测文档
LangChain 官方平台评测入口,覆盖离线数据集、在线追踪和实验比较。
官方
Google GenAI Go SDK
Google 官方 Go SDK,提供 Gemini API 的 Go 客户端与示例。
Agent 样本、工具与回归路径
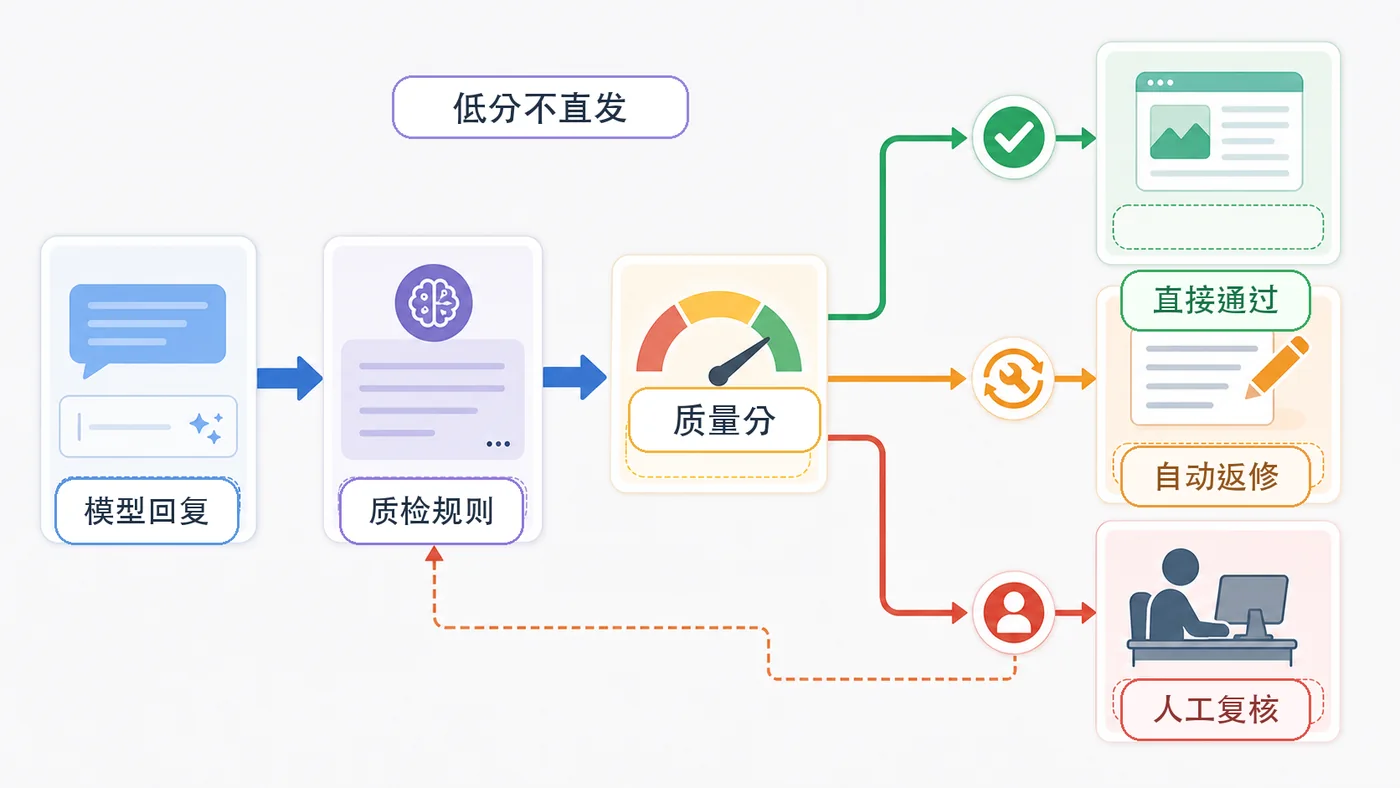
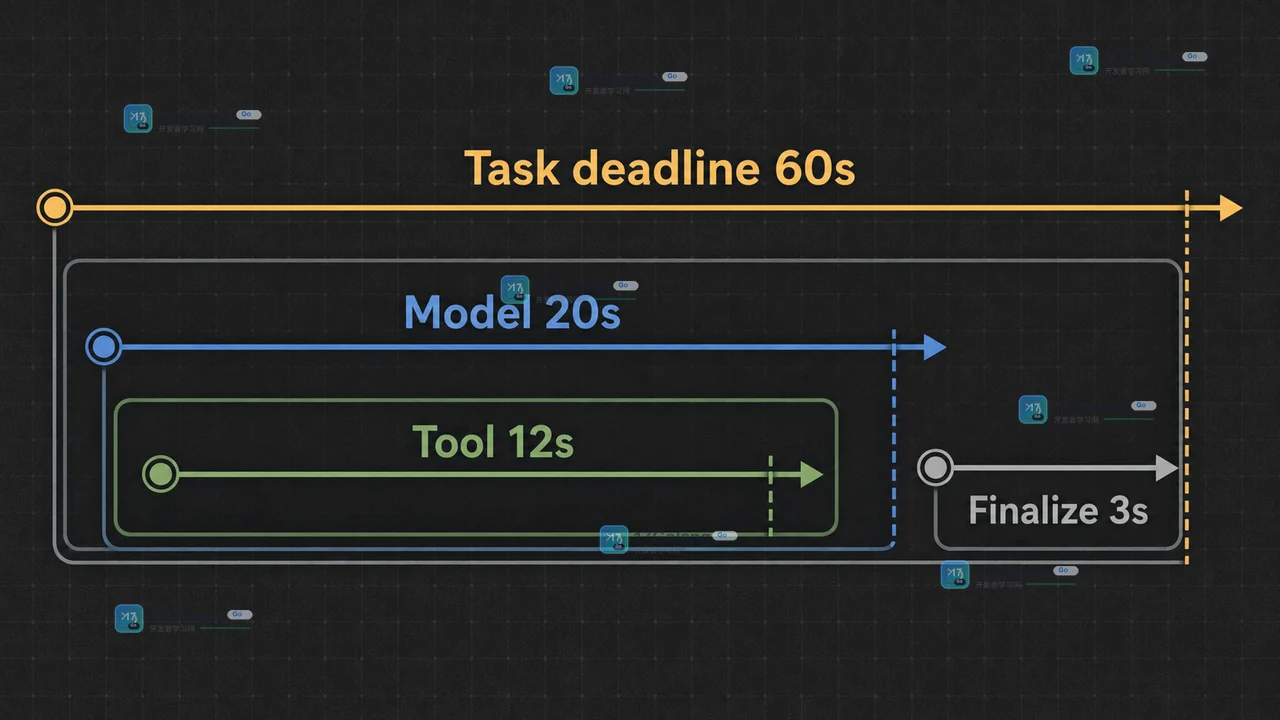
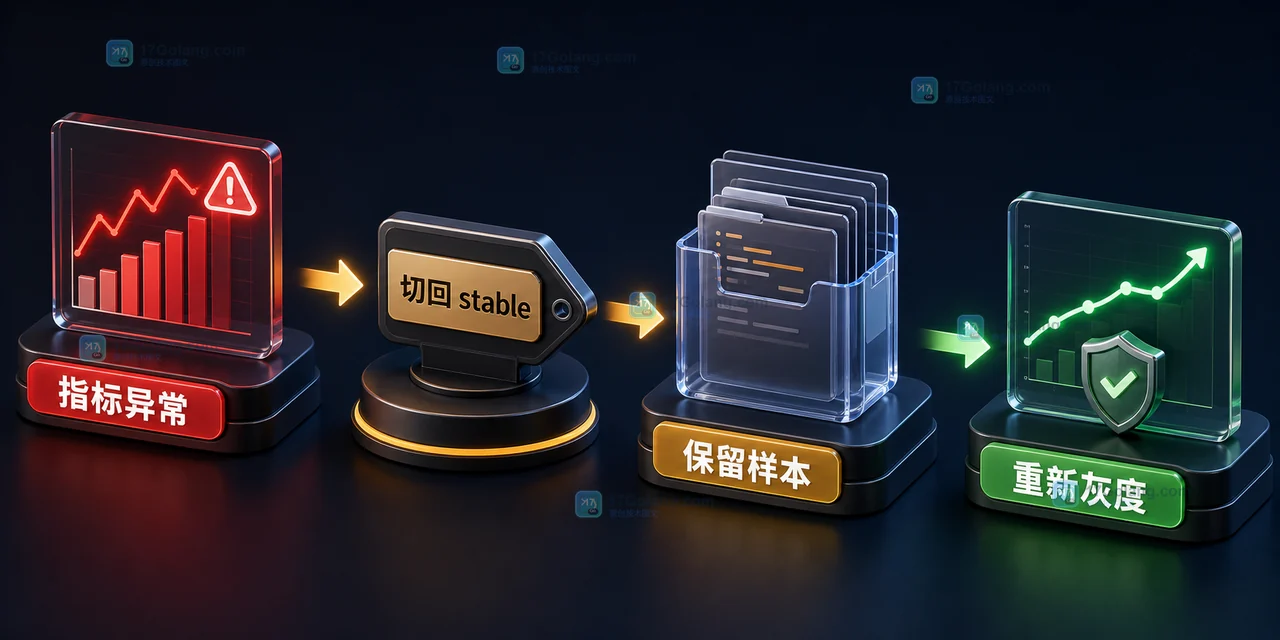
从最小评测集到失败回放和发布门禁


Agent 评测常见问题
样本、评分、随机性和上线门禁的实用答案
Agent 评测集最少应该包含什么?
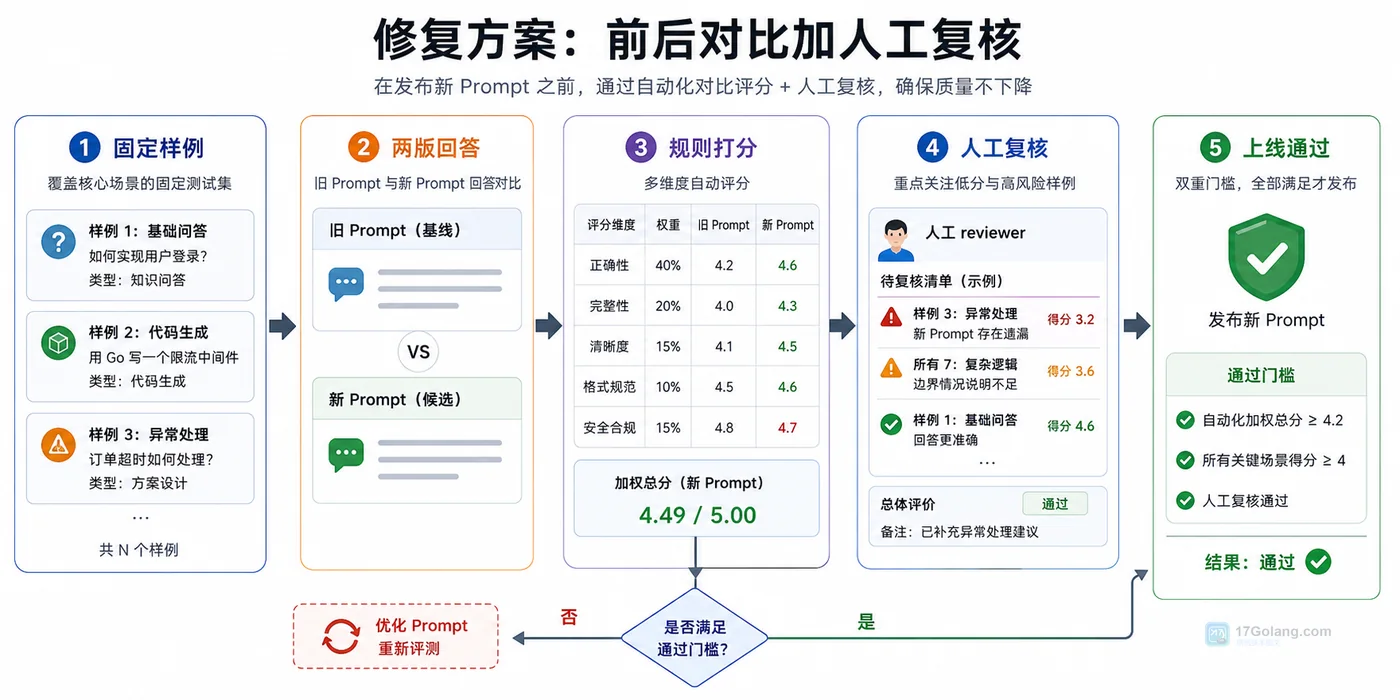
至少包含高频成功任务、边界输入、拒答与安全样本、工具调用、工具失败、超时和需要人工确认的任务;每条固定输入、期望状态和评分规则。
LLM-as-a-judge 能不能直接作为唯一评分?
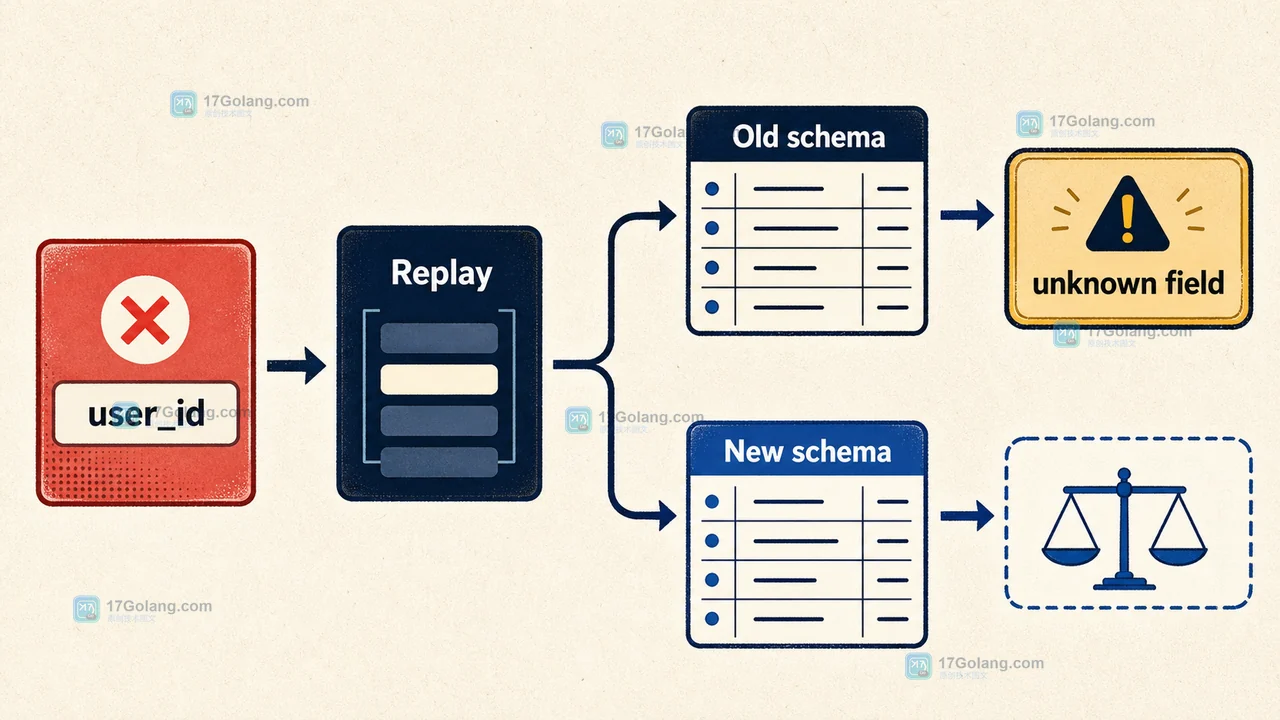
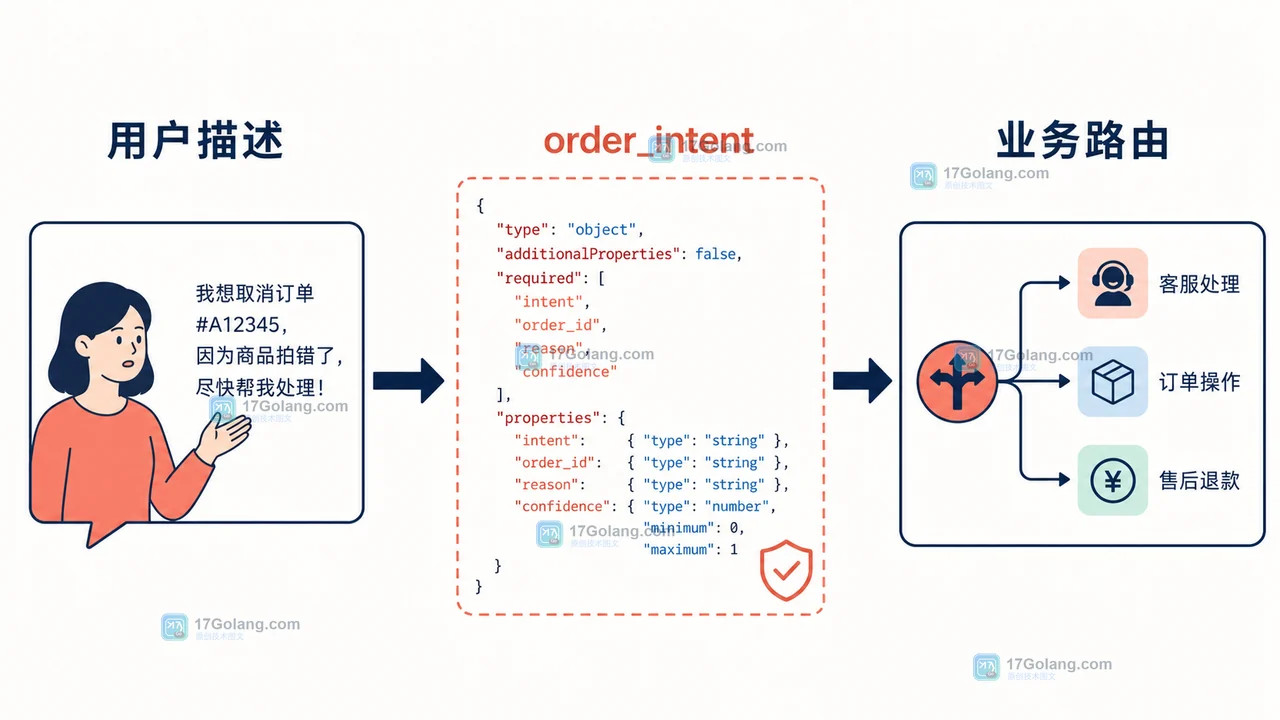
不建议。应把规则校验、结构化 schema、工具状态、人工抽检和模型评分组合使用,并保留评分理由与样本版本。
模型有随机性,回归测试怎样判断通过?
固定模型版本、温度和工具环境,允许合理波动区间;同时关注通过率、关键失败率、拒答率、工具错误率和成本等分位或置信区间。
什么时候可以让 Agent 评测通过后自动发布?
只有当样本版本、评分规则、工具权限、数据脱敏、失败回放、阈值和回滚路径都固定并经过演练时,才对低风险变更开放自动发布;敏感动作保留人工审批。
相关专题
继续查看相近方向内容
查看更多
最新文章
-
- Go archive/tar.Reader.Next 怎么安全遍历归档条目
- 5分钟前 337浏览
-
- Redis XPENDING 怎么筛选空闲时间过长的消息
- 10分钟前 349浏览
-
- shizuku遇到问题怎么反馈?版本、启动模式与日志整理说明
- 11分钟前 110浏览
-
- Go zip.File.OpenRaw 与 Open 有什么区别
- 17分钟前 123浏览
-
- 米坛社区知识库普通用户和开发者怎么选?教程入口与发布边界说明
- 18分钟前 362浏览
-
- MySQL Skip Scan 什么时候会被优化器采用
- 18分钟前 413浏览
-
- Go archive/zip.OpenReader 怎么按名称读取压缩包文件
- 25分钟前 130浏览
-
- 爱玩机工具箱文件目录在哪?主文件、下载文件与数据安全提醒
- 34分钟前 171浏览