
Hugging Face Datasets 流式读取大语料时如何切分样本
来源:17golang原创
时间:2026-09-14 17:29:31 449浏览 收藏
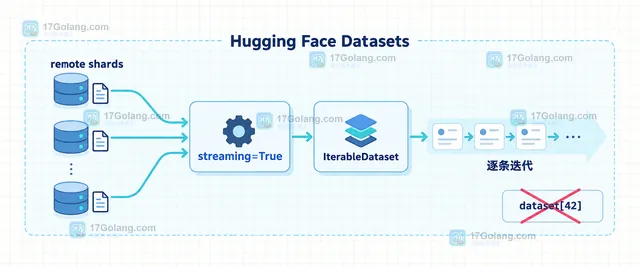
大语料不适合先完整下载再切片时,Hugging Face Datasets 的 streaming=True 可以边迭代边读取。但它返回的不是支持随机下标的普通 Dataset,而是 IterableDataset。所以“切分样本”不能简单理解成 dataset[1000:2000]:连续取一段用 take/skip,并行分给多个 worker 则优先用 shard。
take(n)取前 n 条,skip(n)跳过前 n 条;两者都是流式迭代语义。- 需要多 worker 互斥处理时,用固定的
num_shards和index调用shard。 - 要随机化,先
shuffle再切分;切分后不要再依赖新的 shard 顺序。
先确认流式数据能做什么
下面的代码只展示读取边界,不把它当成本机执行截图。开启流式模式后,数据会随着 for 迭代逐步到达;不能用 len() 或随机下标来获得任意一条记录。这个特性适合训练、批处理和抽样预览,不适合频繁跳到某个绝对行号。
from datasets import load_dataset

# 只在迭代时读取数据,不预先把整个语料落到本地磁盘。
dataset = load_dataset(
    "allenai/c4",
    "en",
    split="train",
    streaming=True,
)

# 取一条记录查看字段;这里没有随机访问语义。
first = next(iter(dataset))
print(first.keys())
连续样本段用 shuffle、take 和 skip
如果需求是“先拿前 500 条做冒烟测试”或“跳过前 10 万条再处理”,可以把数据集看成一个有顺序的迭代器。需要随机顺序时,要在切分之前调用 shuffle:
# 先打乱 shard 顺序和缓冲区中的样本,再固定两个连续窗口。
shuffled = dataset.shuffle(seed=42, buffer_size=10_000)
preview = shuffled.take(500)
training_part = shuffled.skip(500).take(10_000)

for row in training_part:
    # 这里处理一个样本;生产代码可在此处做分词或写入批缓冲。
    text = row.get("text", "")
    if text:
        consume(text)
take 只保留开头的 N 条,skip 返回剩余部分。后者不会瞬移到第 N 条,开始迭代时仍要先走过被跳过的数据,因此跳过很大的偏移量会带来启动延迟。另一个常见坑是把 take/skip 放在 shuffle 前面:切分操作会锁定顺序,后续再调整 shard 顺序就不是你以为的随机切片。
并行任务用 shard 切互斥分片
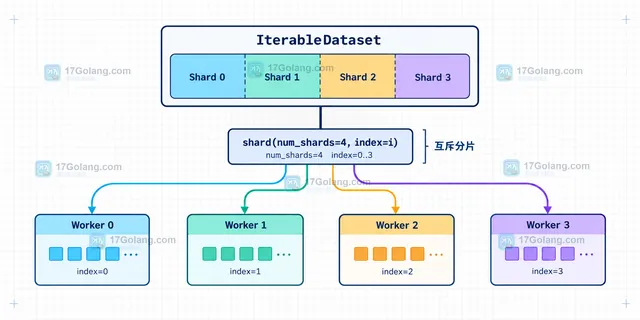
训练或批处理需要多个 worker 同时消费时,按 worker 编号取分片更合适。num_shards 是总分片数,index 是当前 worker 的分片编号,编号从 0 开始:
def read_worker(dataset, worker_id, worker_count):
    # 固定总分片数和当前编号,让不同 worker 读取不同底层 shard。
    part = dataset.shard(num_shards=worker_count, index=worker_id)
    for row in part:
        # 每个 worker 只处理自己的分片,避免简单复制迭代器造成重复。
        yield row


for item in read_worker(dataset, worker_id=1, worker_count=4):
    # 这里接入当前 worker 的预处理逻辑。
    consume(item)
这种方式解决的是“谁负责哪些底层 shard”,不是精确的全局行号分页。若底层只有一个 shard,文档建议改用 skip/take 做窗口;如果是从已有 Dataset 转成流式数据,可用 to_iterable_dataset(num_shards=64) 预先增加可分配的 shard,再交给 PyTorch DataLoader 的 worker。
按目标选择切分方式
| 目标 | 推荐组合 | 需要留意 |
|---|---|---|
| 快速查看头部样本 | take(n) | 只适合顺序前缀,不代表全局随机样本 |
| 处理某个连续窗口 | shuffle().skip(a).take(b) | skip 的偏移量越大,启动遍历越久 |
| 多个 worker 并行消费 | shard(num_shards, index) | 分片编号必须稳定,不能让 worker 随意猜编号 |
| 每轮重新随机 | shuffle(seed).set_epoch(epoch) | 把 epoch 作为循环控制,不要依赖随机访问 |
实际接入 DataLoader 时,还要确认 worker 数量、分片数和样本处理是否幂等。需要恢复中断位置时,不要保存一个“第几行”的假设;IterableDataset 提供 state_dict() 和 load_state_dict(),可以记录当前 shard 与 shard 内位置。
常见问题
take 和 skip 能否替代普通 Dataset 的切片?
只能替代顺序窗口,不能提供随机访问。尤其是 skip,大偏移量仍然需要逐条迭代过去。
先 shard 再 shuffle 可以吗?
如果目标是可预期的随机切分,先 shuffle 再 shard 或 take/skip;切分后再 shuffle 会受到顺序锁定语义影响。
shard 能保证每个 worker 获得完全相同数量的样本吗?
它按底层 shard 分配,不承诺按全局样本数精确均分。最后一个分片可能更短,业务侧应允许批次大小变化。
参考资料:https://huggingface.co/docs/datasets/en/stream;https://huggingface.co/docs/datasets/en/package_reference/loading_methods。
-
346 收藏
-
235 收藏
-
297 收藏
-
387 收藏
-
447 收藏
-
383 收藏
-
科技周边 · 人工智能 | 3小时前 | 人工智能 · openai api · 工程实践 · 批处理 · OpenAI Batch API custom_id 批量请求结果映射 JSONL 结果回配105 收藏
-
146 收藏
-
科技周边 · 人工智能 | 6小时前 | openai · json schema · Structured Outputs · OpenAI Nullable Schema JSON Schema Structured Outputs281 收藏
-
科技周边 · 人工智能 | 7小时前 | 人工智能 · openai api · 检索增强生成 · 文件搜索 · OpenAI Attributes 元数据过滤 Responses API File Search vector store426 收藏
-
科技周边 · 人工智能 | 8小时前 | 异步任务 · 人工智能 · openai api · 接口开发 · 轮询 后台任务 background true OpenAI Responses API response_id314 收藏
-
345 收藏
-
115 收藏
-
171 收藏
-
科技周边 · 人工智能 | 1天前 | 人工智能 · 性能排查 · 提示词工程 · Hugging Face · 模型推理 · KV Cache · 提示词缓存动态字段 DynamicCache KV缓存 Transformers缓存 past_key_values use_cache StaticCache397 收藏
-
科技周边 · 人工智能 | 1天前 | 人工智能 · 模型量化 · 校准数据 · ONNX Runtime · GPTQ · 推理优化 · 量化校准数据 模型量化配置 代表性校准集 ONNX静态量化 GPTQ校准数据 AI模型精度排查276 收藏
-
221 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习