
人工智能技术文章
-
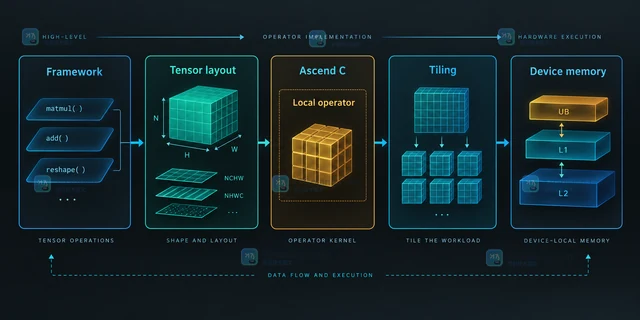 在 DeepSeek 相关 Ascend NPU 项目中,算子负责单卡计算,HCCL/HCOMM 负责跨卡通信,框架后端负责编排。本文按职责边界拆解 Ascend C、通信原语、MoE dispatch/combine 与多卡排查顺序。375 收藏
-
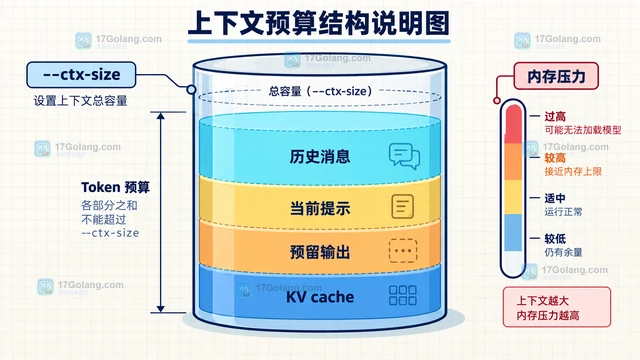 本地运行 GGUF 模型时,量化格式决定权重占用与精度取舍,上下文长度决定单次请求的提示词和生成空间。本文用一套可执行的判断顺序说明 Q4_K_M、Q5_K_M、Q8_0 与 --ctx-size 的配置方法。273 收藏
-
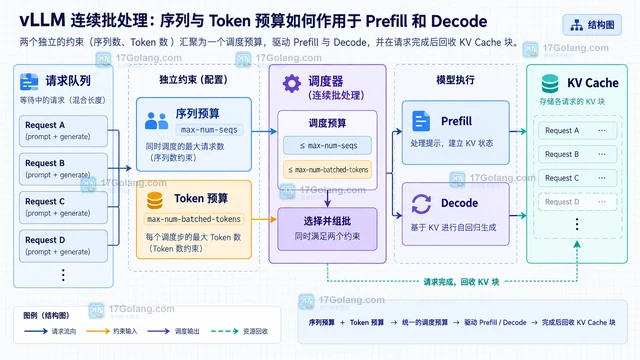 vLLM 连续批处理并不是并发越高越快。本文从模型权重、KV Cache、序列数和批次 token 预算出发,给出显存与吞吐的调参顺序、压测方法和生产降级路径。209 收藏
-
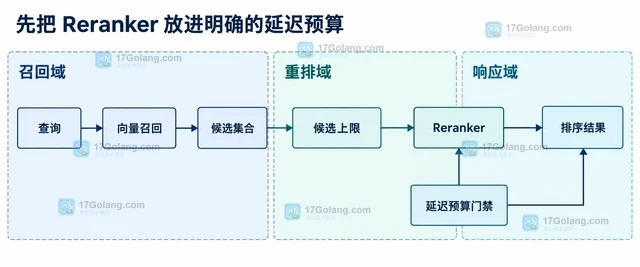 Reranker 通常只应处理召回后的有限候选。本文从延迟预算、候选规模、输入长度、批量和超时降级几个方面,给出一套可落地的检索重排控制方案。113 收藏
-
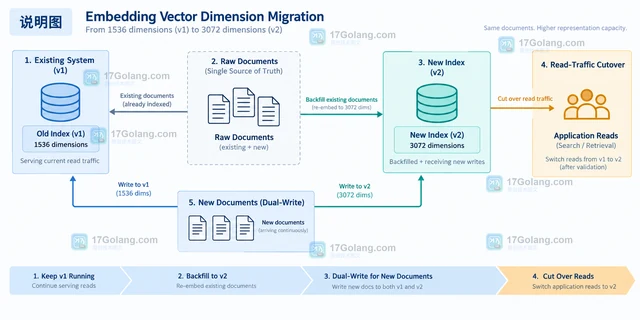 Embedding 维度变化不是改一个配置值就结束。稳妥做法是新建版本化索引,回填历史数据,双写新数据,用固定查询集灰度比较后再切换。429 收藏
-
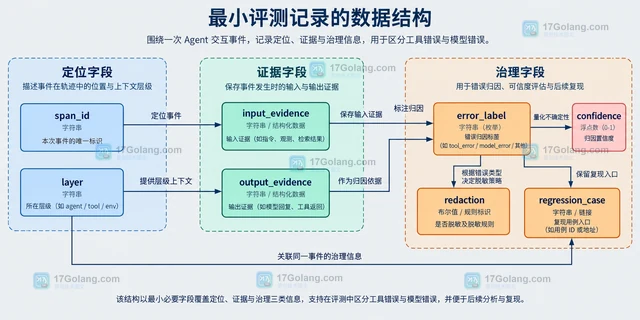 智能体失败不一定是模型能力不足。本文用轨迹中的工具参数、工具响应、环境状态和模型后续决策建立证据分层,给出工具错误、模型错误与混合错误的判定规则、Python 记录结构和回归清单。239 收藏
-
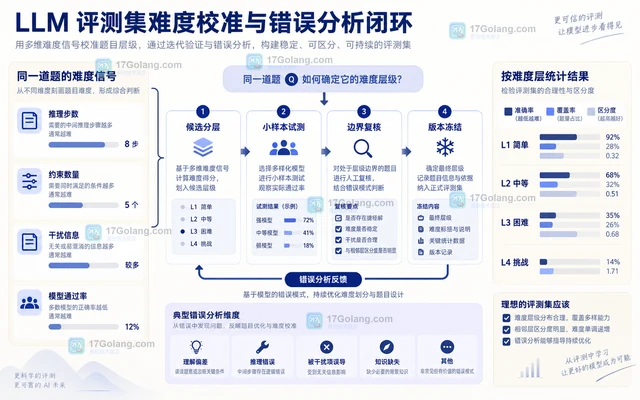 从任务拆解、难度信号、试测校准和分层抽样四个环节构建 LLM 评测集,让总分之外还能看清模型在哪个能力层级上变化。343 收藏
-
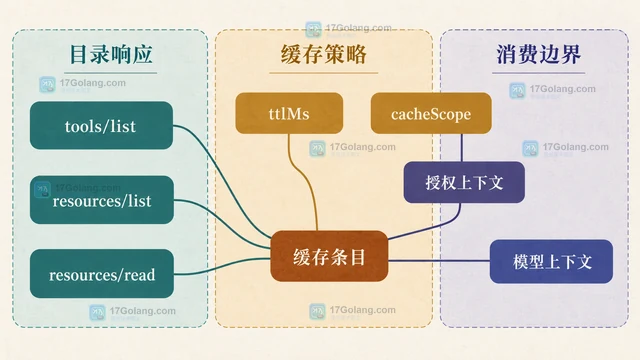 MCP 客户端不应只靠固定 TTL 缓存工具描述和资源。本文按 tools/list、resources/list、resources/read 拆分缓存键,结合 ttlMs、cacheScope 与变更通知设计可恢复的一致性策略。313 收藏
-
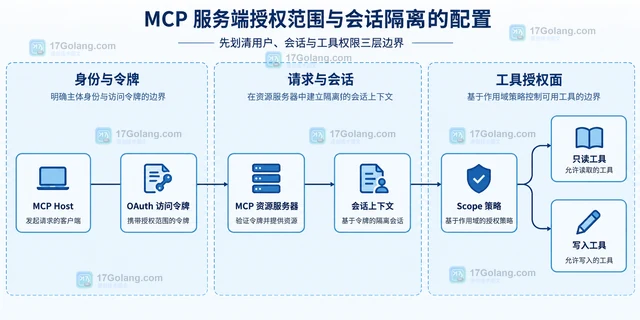 从 HTTP 令牌校验、scope 工具映射、请求级授权上下文和审计字段四个层面,说明如何配置 MCP 服务端的授权范围与会话隔离,避免主体、租户和写入权限混用。161 收藏
-
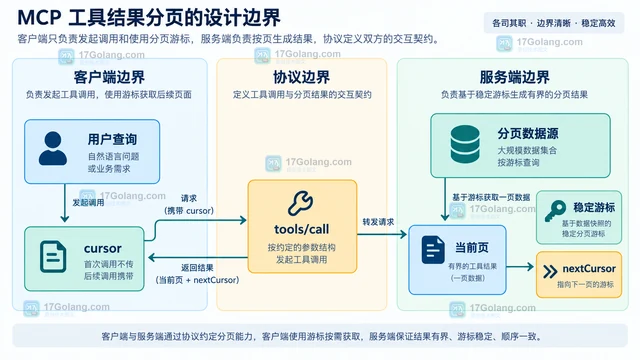 从 MCP 原生列表分页与工具自定义结果两条路径出发,说明如何用稳定游标、结构化续取信息和可读预览控制长列表,避免一次工具调用挤满模型上下文。486 收藏
-
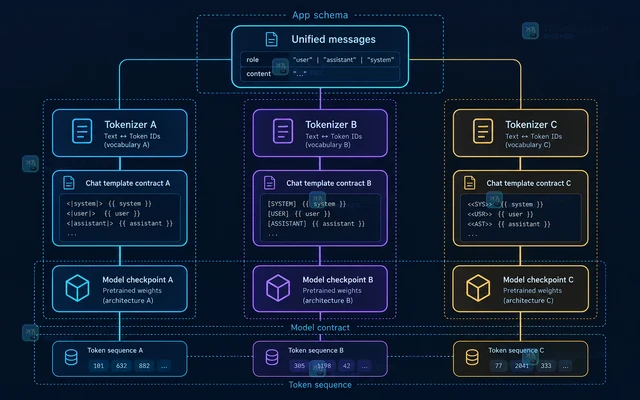 多模型服务应统一 role/content 消息结构,而不是硬编码一套控制 token。本文用 tokenizer.apply_chat_template 建立模型契约层,区分普通回复、预填续写与训练格式,并说明特殊 token 和能力边界。154 收藏
-
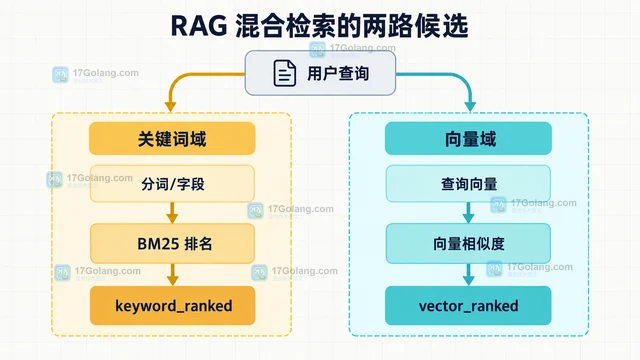 从零实现一个 RRF 混合检索融合器,把关键词与向量排名统一去重、计分,并输出可直接交给 RAG 的候选文档。373 收藏
-
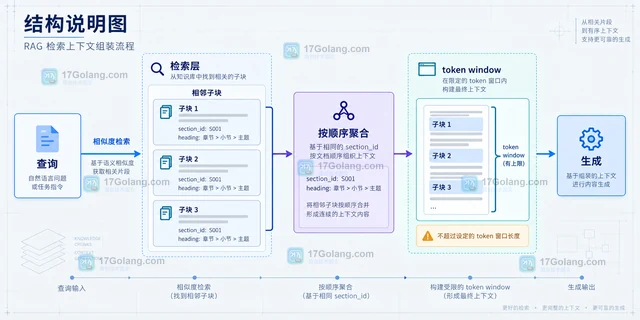 从标题路径、递归切分、token 上限和召回聚合四个环节,说明 RAG 如何减少断章与误召回。300 收藏
-
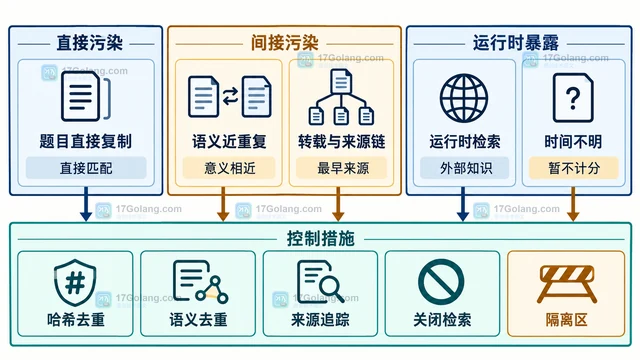 时间切分不能证明评测集绝对无污染,但能用训练截止时间、样本最早来源时间、冻结时间和评测时间建立可审计边界。本文给出三桶切分、重复检测、检索隔离、分窗报告与滚动换题方案。356 收藏
-
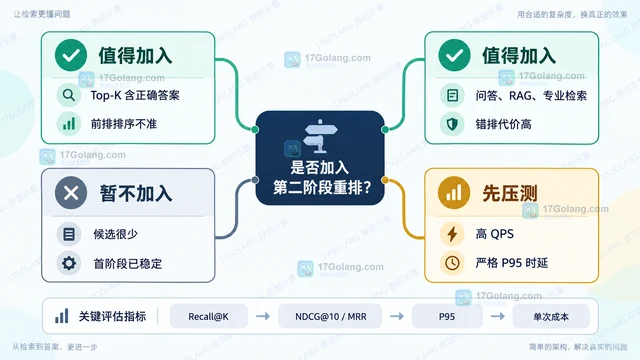 语义检索是否需要第二阶段重排,关键不在模型更强,而在第一阶段已能召回正确文档、前排仍错序且业务能承担额外时延。本文用 Recall@K、NDCG/MRR、P95 和单次成本给出决策与实现方法。449 收藏